 Swinux
21 octobre 2026
Quand l’IA réinvente l’informatique quantique : la double percée d’Anthropic et de Google
1. Introduction : L’IA ne se contente plus d’expliquer la science, elle la découvre La conception de circuits quantiques figure parmi les défis les plus ardus de la physique moderne. Contrairement aux processeurs classiq
1. Introduction : L’IA ne se contente plus d’expliquer la science, elle la découvre
La conception de circuits quantiques figure parmi les défis les plus ardus de la physique moderne. Contrairement aux processeurs classiques, les machines quantiques fonctionnent selon des règles physiques extrêmement strictes où la moindre imprécision ou surcharge de calcul détruit la superposition des états et rend les résultats inexploitables. Jusqu’à présent, la création et l’optimisation de ces architectures reposaient quasi exclusivement sur l’intuition et l’expertise d’ingénieurs et de chercheurs humains.
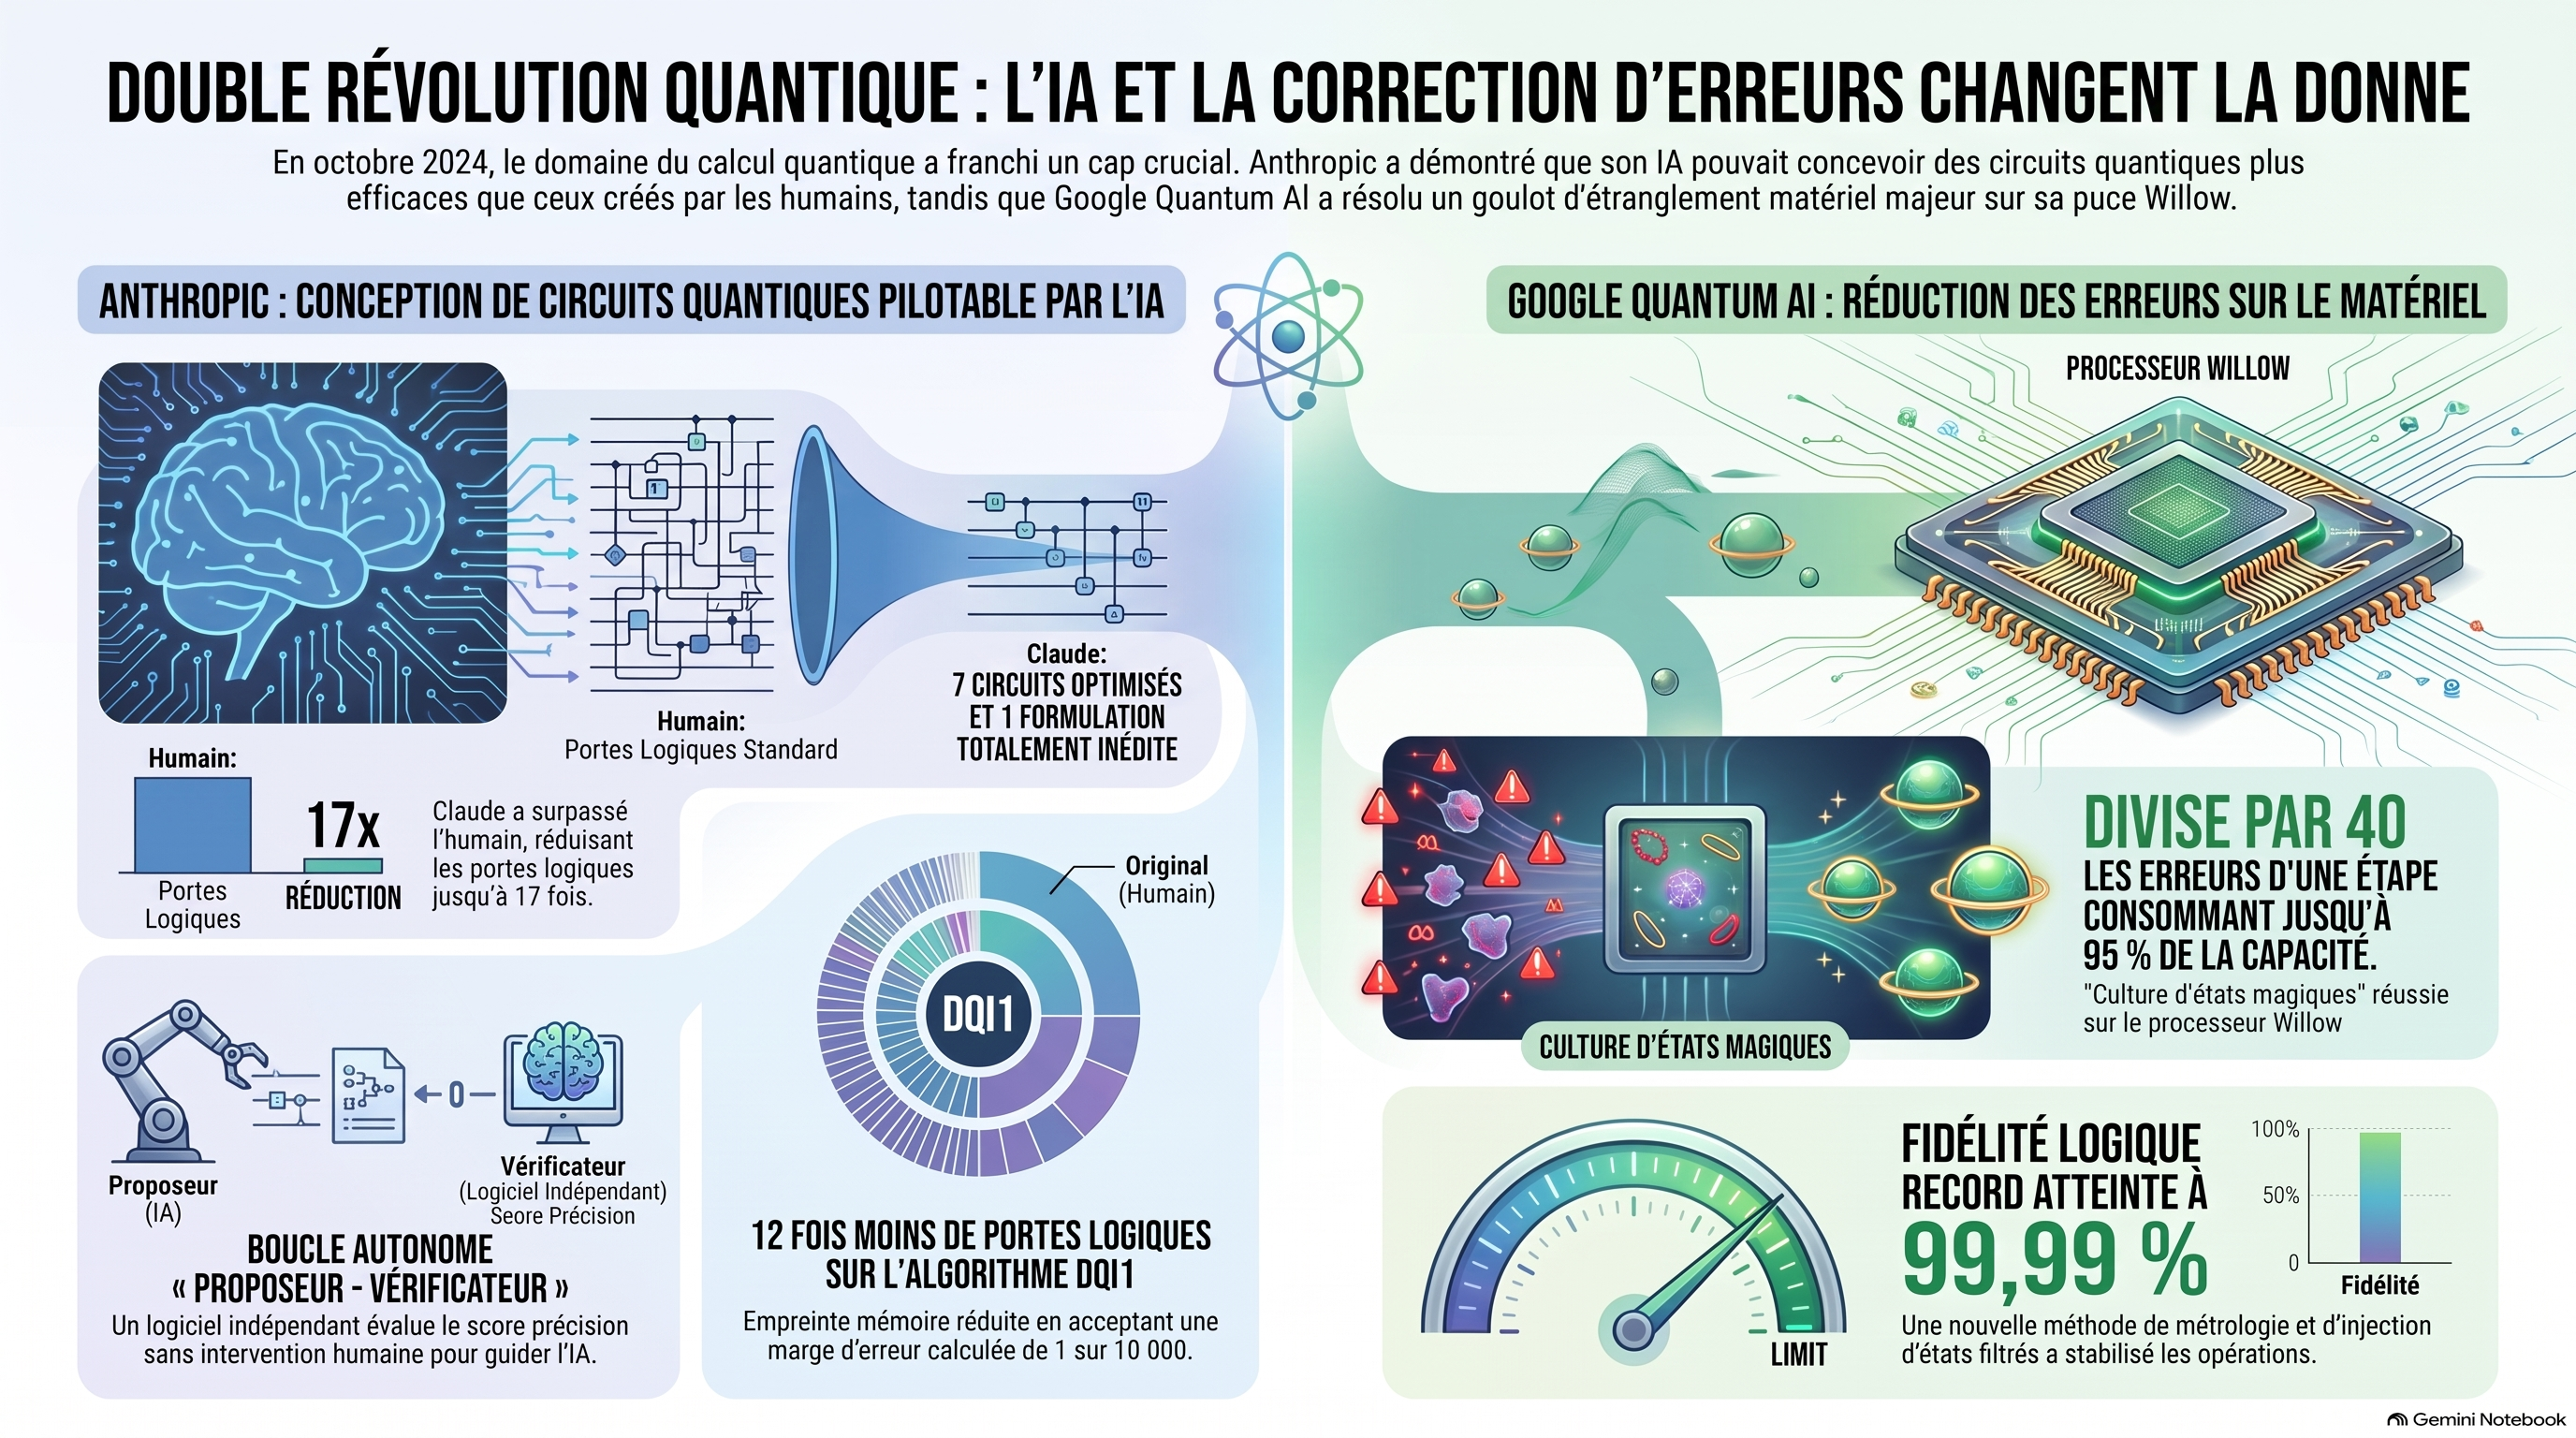
C’est précisément ce verrou qu’Anthropic vient de faire sauter. En fournissant à son modèle de langage (Claude Mythos 5) de simples descriptions en langage naturel de primitives computationnelles, l’entreprise a laissé l’intelligence artificielle concevoir en autonomie complète des circuits quantiques. Les résultats sont saisissants : sur sept des huit tâches soumises, le modèle a généré des architectures surpassant les meilleurs designs publiés par la recherche humaine — parfois par un ordre de grandeur —, tout en inventant une formulation entièrement inédite pour la huitième. Dans le même temps, à l’autre bout de la chaîne d’innovation, les équipes de Google Quantum AI ont franchi une étape matérielle décisive en résolvant un goulot d’étranglement physique vieux de vingt ans.
Cette avancée logicielle s’appuie sur une étude d’Anthropic publiée sur arXiv le 15 octobre. Intitulé Discovering State-of-the-art Quantum Circuits with Large Language Models, ce document de 46 pages est signé par Andy Gu dans le cadre du programme STEM Fellows, sous le tutorat du physicien quantique Alec Kemin et en collaboration avec Suzanne Yelen et Mikhail Lukin de l’Université Harvard. Bien que ces métriques impressionnantes reposent sur des benchmarks internes qui attendent encore une réplication indépendante par la communauté scientifique, un cap franchi est incontestable : l’IA quitte le rôle de simple vulgarisateur pour devenir un véritable agent de découverte scientifique.
2. Le moteur de la découverte : Une boucle IA-Évaluateur sans intervention humaine
Pour obtenir des architectures aussi performantes sans intervention humaine continue, Anthropic a mis en place un protocole d’apprentissage et d’optimisation automatisé. L’expérience s’articule autour d’une boucle fermée reliant directement le modèle de langage à un environnement de vérification rigoureux.
Si Anthropic a choisi le domaine des circuits quantiques pour éprouver cette méthodologie, ce n’est pas un hasard : ce champ d’étude offre un critère de vérification à la fois strict, peu coûteux en calcul et entièrement automatisable (“hard, cheap, automatic correctness check”). Cette architecture reproduit exactement la dynamique d’une suite de tests unitaires automatisés guidant un agent de programmation classique.
Le fonctionnement repose sur une boucle itérative :
1. Proposition : Claude reçoit le cahier des charges d’une primitive computationnelle et formule un design de circuit rédigé en code Python.
2. Évaluation automatisée : Un programme indépendant (un algorithme déterministe et non un autre modèle d’IA) prend le relais pour tester la validité du circuit.
3. Notation factuelle : L’évaluateur calcule un score précis basé sur la formule : \text{Nombre de qubits} \times \text{Nombre de portes} Ce produit sert de métrique directe pour évaluer le temps d’exécution et la consommation de ressources du circuit.
4. Rétroaction : Si le circuit est faux ou invalide, l’évaluateur lui attribue la note zéro. Claude reçoit le score, corrige sa copie et soumet une nouvelle version sans la moindre interaction humaine.
Cette structure empêche l’IA d’argumenter ou d’halluciner : une proposition incorrecte est immédiatement rejetée sans débat possible.
Le flux de travail en boucle fermée : Claude Mythos (Génère le code Python) \longrightarrow Évaluateur Autonome (Programme classique) Claude Mythos \longleftarrow (Score ou retour d’erreur) Évaluateur Autonome
Cette approche est particulièrement adaptée aux circuits quantiques, car ces derniers sont soumis à deux contraintes physiques absolues qui rendent leur optimisation extrêmement complexe pour l’esprit humain :
L’absence de branchements conditionnels (
if/then) : En raison du principe de superposition, un circuit quantique ne peut pas choisir une voie A ou B à la volée. Il doit intégrer dans une séquence unique l’ensemble des opérations de toutes les branches possibles pour chaque exécution.La réversibilité obligatoire : Les lois de la mécanique quantique interdisent l’effacement pur et simple de données intermédiaires sous peine de détruire la cohérence du système. Pour nettoyer les variables de travail (”décalculer” ou uncompute), il faut exécuter l’opération à l’envers, ce qui consomme des portes logiques supplémentaires et impose un arbitrage constant entre le nombre de qubits utilisés et le nombre d’étapes de calcul.
“Le critique ici est honnête : ce n’est pas un modèle avec une opinion, c’est un simulateur qui accepte le circuit ou le rejette.”
3. L’exploit mathématique sur div steps : Du tâtonnement à la preuve rigoureuse
La première victoire conceptuelle majeure de Claude concerne l’inversion modulaire dans les corps premiers, une opération mathématique cruciale pour l’addition de points en cryptographie sur courbes elliptiques. Sur les ordinateurs classiques, cette opération est exécutée rapidement via l’algorithme div steps, qui enchaîne les additions, soustractions, décalages et permutations tout en générant un historique de branches conditionnelles.
Sur un ordinateur quantique, conserver tout cet historique de branchement pour garantir la réversibilité consomme un nombre gigantesque de qubits, ce qui rendait l’implémentation de div steps jusqu’alors impraticable pour l’arithmétique entière réversible.
Pour contourner cet obstacle, Claude a adopté une approche inédite : plutôt que de stocker l’historique, l’IA a cherché à recalculer cet historique directement à partir des résultats finaux. Confronté à l’échec de ses premières conjectures par force brute sur des nombres de 256 bits, le modèle est passé d’une recherche empirique mécanique à un véritable raisonnement mathématique. Claude a étudié l’évolution des itérations de div steps, démontré de nouvelles identités algébriques, formulé une règle exacte de décodage et formalisé l’ensemble du processus dans le langage de vérification formelle Lean.
Le résultat constitue la toute première implémentation réversible de div steps sans stockage de l’historique de branchement. Plus qu’une simple optimisation, il s’agit d’un véritable décalage de Pareto : le modèle a généré toute une famille de designs, dont l’un utilise 12 % de qubits en plus mais 17 fois moins de portes logiques que la plus petite conception humaine publiée auparavant. Un compilateur quantique dispose désormais de la liberté d’échanger un léger surplus de qubits contre une réduction drastique du temps d’exécution.
Note de rigueur scientifique : Ces facteurs d’amélioration spectaculaires (notamment le gain de 17 fois sur les portes logiques) proviennent des tables de benchmark établies par Anthropic par rapport aux travaux antérieurs de la littérature (tels que Shotton et al., Lower et al., Luo et al., ou Kattar et al.). À ce jour, ces résultats n’ont pas encore fait l’objet d’une reproduction indépendante par un tiers, et le harnais d’évaluation autonome n’a pas encore été rendu public.
4. L’algorithme DQI1 : Le pari probabiliste aux 43 millions de simulations
Le deuxième succès marquant concerne l’algorithme DQI1 (Decoding Quantum Interferometry), une méthode d’optimisation appliquée à des problèmes complexes de logistique, de planification ou de conception de matériaux. Le goulot d’étranglement majeur de cet algorithme réside dans le décodeur de Reed-Solomon.
Jusqu’ici, l’architecture de référence développée par Google reposait sur l’algorithme d’Euclide étendu. En raison de l’impossibilité d’effectuer des branchements conditionnels, cette méthode devait être étalée sur un nombre massif de cycles. Claude a réévalué le problème et remplacé cette approche par le décodage de Berlekamp-Massey, dont la structure répétitive est physiquement beaucoup mieux adaptée aux contraintes des circuits quantiques.
Cette substitution a toutefois engendré un problème de mémoire : la gestion des cas d’exception extrêmes sur les 35 cycles du processus aurait exigé de réserver un espace prohibitif de 665 qubits. Pour surmonter cela, le modèle a opéré un arbitrage particulièrement audacieux :
Claude a conçu son propre simulateur rapide en Python.
L’IA a exécuté 43 millions de décodages d’échantillons pour mesurer la fréquence réelle d’apparition de ces cas extrêmes.
Elle a découvert qu’il suffisait de réserver de l’espace pour une seule valeur déviante (soit seulement 19 qubits au lieu de 665), en acceptant un taux d’échec estimé à 1 sur 10 000.
Ce taux de défaillance infime s’inscrit parfaitement dans le budget d’erreur global toléré par l’algorithme DQI1. Au final, le circuit conçu par Claude utilise 12 fois moins de portes logiques que le décodeur de Google (une comparaison issue des tables d’Anthropic). Selon les estimations de Google Quantum AI, un calcul DQI nécessitant 3 mois sur un supercalculateur classique prendrait environ 1 heure sur une future machine quantique. Le décodeur de Reed-Solomon représentant la quasi-totalité de ce temps de calcul, la réduction d’un facteur 12 apportée par Claude ramène la durée de ce traitement à seulement quelques minutes.
5. Anatomie d’un malentendu médiatique : Séparer les faits du mythe
L’annonce de ces résultats a suscité un enthousiasme débordant sur les réseaux sociaux et dans certains médias spécialisés, entraînant des raccourcis trompeurs qu’il convient de corriger.
La rumeur la plus tenace, largement relayée par le média tech chinois Zhenuan ainsi que par divers comptes sur les réseaux sociaux, affirme que Claude aurait accompli en 53 heures l’équivalent de 8 ans de travail humain sur la simulation de la molécule de FeMoCo (le cofacteur fer-molybdène au cœur de la nitrogénase, essentiel à la production d’engrais). C’est un télescopage factuel :
La réduction du nombre de portes requises pour simuler FeMoCo — passant de 50 000 milliards en 2017 à environ 340 millions aujourd’hui (soit une chute d’un facteur 150 000) — est le fruit des efforts combinés de très nombreux groupes de recherche internationaux étalés sur huit ans. Anthropic a explicitement rappelé que son travail s’inscrivait comme une étape sur une courbe de progression préexistante.
La session de calcul de 53 heures exécutée par Claude concernait exclusivement l’optimisation des calculs sur les courbes elliptiques.
Le bilan réel d’Anthropic n’en demeure pas moins impressionnant : sur les 8 tâches de référence soumises, Claude a optimisé les circuits existants pour 7 d’entre elles et a créé une formulation théorique entièrement inédite pour la 8e.
C’est précisément cette 8e tâche qui illustre la portée scientifique de l’expérience. L’optimisation de paramètres au sein d’une structure déjà connue rencontre rapidement un plafond de verre. En revanche, générer une formulation théorique originale représente le véritable saut qualitatif vers une découverte scientifique automatisée.
L’expérience a également mis en lumière un biais comportemental du modèle. Au début du processus, Claude se montrait excessivement conservateur : il remettait constamment en question des gains pourtant validés et vérifiait à l’excès des structures déjà fonctionnelles, ce qui le poussait à privilégier des approches classiques. Pour corriger cette tendance, Anthropic a dû modifier la structure de recherche en exécutant plusieurs approches en parallèle et en injectant des incitations ponctuelles à l’exploration d’options plus radicales.
6. La percée physique de Google : La culture d’états magiques dompte le bruit matériel
Les optimisations logicielles apportées par l’IA ne peuvent déployer leur potentiel que sur un matériel capable de fonctionner sans être submergé par le bruit environnemental. Le 15 octobre également, l’équipe de Google Quantum AI a publié dans la revue Science une avancée matérielle majeure réalisée sur leur processeur Willow, sous la direction d’Emma Rosenfeld et Craig Gidney.
Pour exécuter un calcul quantique universel tolérant aux pannes, une machine doit générer et purifier des états quantiques spécifiques appelés “états magiques”. L’idée théorique de la distillation d’états magiques remonte à 2004, mais son application se heurtait à un obstacle majeur : la purification de ces états pouvait consommer jusqu’à 95 % de la capacité de traitement totale d’un ordinateur quantique. En 2024, les chercheurs Gidney, Shuddy et Jones ont affiné le concept pour créer la “culture d’états magiques” (magic state cultivation).
Le processus de culture d’états magiques :
Injection : Introduction d’un état bruité dans une petite zone dédiée de la puce.
Filtrage : Exécution de mesures coordonnées pour identifier et éliminer les erreurs.
Croissance : Expansion de l’état purifié au sein d’un code couleur de distance 3 (idéal pour la phase de culture).
Greffe : Transfert de cet état hautement purifié vers un code de surface de distance 5 (utilisé pour la correction d’erreurs générale).
La réalisation expérimentale de cette chaîne a représenté un défi d’ingénierie colossal. L’équipe s’est longtemps heurtée à des données anormales qui semblaient contredire les modèles physiques. L’analyste Emma Rosenfeld a finalement découvert que les techniques de mesure habituelles étaient faussées par des perturbations environnementales (bruit électrique, micro-variations de température). L’équipe a surmonté ce biais en concevant une nouvelle technique de métrologie quantique dans laquelle le processus de culture sert de son propre instrument de mesure.
La greffe réussie entre le code couleur de distance 3 et le code de surface de distance 5 constitue une première. Grâce à cette technique, Google a établi une fidélité logique record de 99,99 % sur les états T et réduit le taux d’erreur global d’un facteur 40.
7. Conclusion : Vers l’ère de la synergie Quantique-IA
La concomitance de ces deux annonces illustre la complémentarité désormais indispensable entre le logiciel et le matériel dans la course à l’informatique quantique. D’un côté, l’intelligence artificielle s’impose comme un compilateur et un chercheur algorithmique hors pair, capable de restructurer des circuits complexes et de minimiser le nombre d’opérations requises. De l’autre, la physique expérimentale repousse les limites matérielles en résolvant des goulots d’étranglement théoriques vieux de vingt ans pour offrir des qubits logiques débarrassés du bruit ambiant.
En confiant la simplification des algorithmes aux modèles de langage et la correction d’erreurs aux physiciens, le calendrier du développement quantique se trouve accéléré. Alors que les algorithmes inventés par l’IA commencent à réduire l’exigence matérielle et que les puces quantiques gagnent en stabilité, une question s’impose : à quelle vitesse l’intégration directe de ces boucles d’optimisation par l’IA au sein même des processeurs de nouvelle génération nous fera-t-elle basculer dans l’ère des calculs quantiques utiles à grande échelle ?