 Swinux
2 novembre 2026
Pourquoi les géants de l’IA se trompent d’échelle : la démonstration choc de Yann LeCun et Randall Balestriero
La course à la taille brute (scaling) et à l’augmentation continue des paramètres des grands modèles de langage (LLM) est-elle réellement la seule voie pour bâtir une intelligence artificielle générale ?
La course à la taille brute (scaling) et à l’augmentation continue des paramètres des grands modèles de langage (LLM) est-elle réellement la seule voie pour bâtir une intelligence artificielle générale ? Alors que l’industrie investit d’immenses ressources pour entraîner des modèles de plus en plus gigantesques, une alternative plus sobre, plus élégante et rigoureusement démontrée sur le plan mathématique vient ébranler ce paradigme.
Publiée fin octobre 2026 sur arXiv (réf. arXiv:2610.39302), une étude majeure signée Randall Balestriero (Brown University / AMI Labs) et Yann LeCun (New York University / AMI Labs) réinterroge les fondements de l’apprentissage profond. Intitulée « Proving and Improving the Platonic Representation Hypothesis with JEPAs », cette publication prouve formellement qu’une alternative fondée sur les architectures prédictives par plongement conjoint (Joint-Embedding Predictive Architectures ou JEPAs) permet d’atteindre un alignement intermodal inégalé avec un niveau d’efficacité sans précédent.
De l’hypothèse au théorème mathématique : la théorie du monde platonicien
L’Hypothèse de la représentation platonicienne (PRH) postulait jusqu’alors une intuition fascinante : à mesure que les modèles d’IA gagnent en capacité et sont entraînés sur des données diverses (texte, vision, audio), leurs représentations internes convergent naturellement vers une structure partagée et universelle de la réalité. Toutefois, cette idée restait une constatation empirique, observée expérimentalement sans fondement théorique absolu.
La rupture conceptuelle majeure apportée par Balestriero et LeCun réside dans la transformation de cette hypothèse en un théorème mathématique formel grâce au cadre des JEPAs. Il ne s’agit plus de constater empiriquement une convergence au fur et à mesure que l’on augmente la taille des réseaux, mais d’en établir la preuve rigoureuse. Cette avancée théorique fixe précisément les conditions mathématiques sous lesquelles des réseaux d’IA entraînés de manière complètement indépendante sur des modalités différentes apprennent exactement la même représentation du monde.
Le secret des « bons points de vue » contre le piège du « Next-Token Prediction »
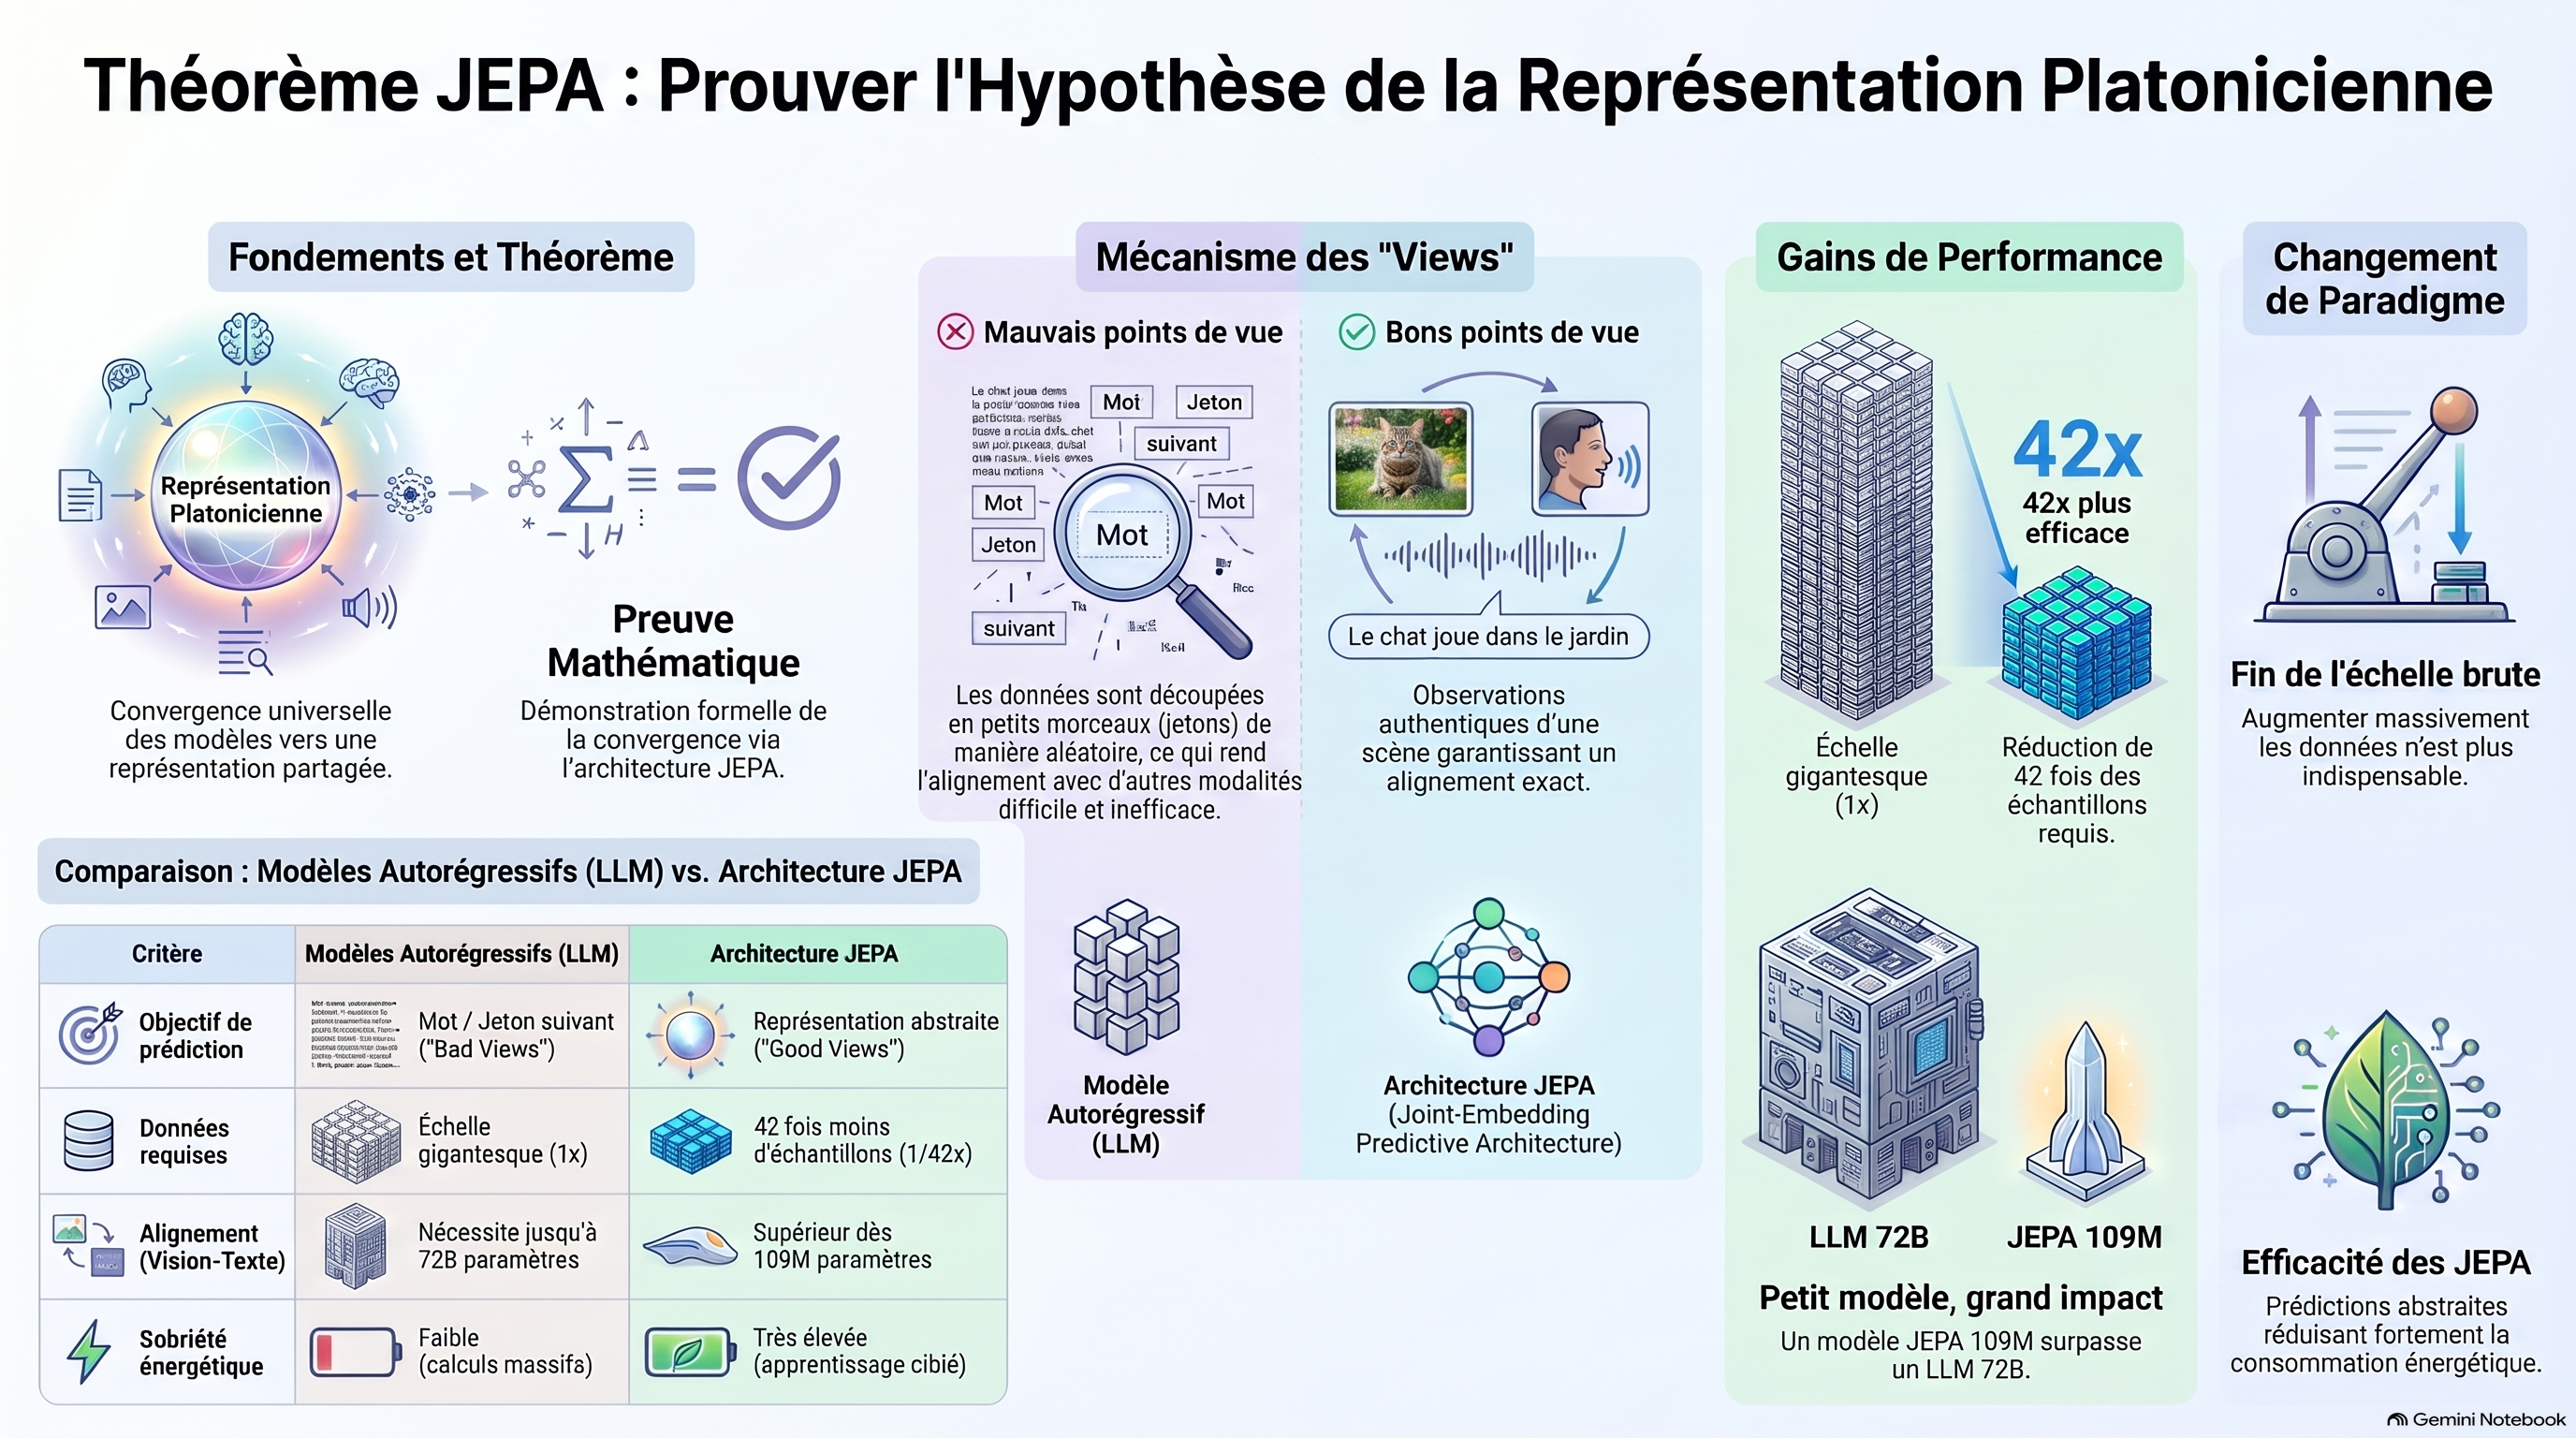
Au cœur de cette démonstration réside la notion de « points de vue » (Views). Le théorème établit que des architectures JEPA entraînées séparément sur des modalités distinctes apprennent une représentation strictement identique (aux rotations près) si et seulement si leurs paires d’entraînement sont constituées de « bons points de vue » (Good Views). Deux observations authentiques d’une même scène — par exemple, deux descriptions textuelles indépendantes décrivant une même image — constituent de bons points de vue : elles obligent l’encodeur à faire l’abstraction des variations superficielles de surface pour ne conserver que la structure sémantique profonde.
À l’inverse, la prédiction du jeton suivant (next-token prediction), principe fondateur des LLM autorégressifs actuels, s’appuie mathématiquement sur de « mauvais points de vue ». Découper arbitrairement un document textuel en séquence de mots contraint le modèle à apprendre une contiguïté lexicale superficielle au détriment du contexte sémantique global. C’est précisément cette inefficacité intrinsèque qui explique pourquoi les LLM géants peinent à s’aligner naturellement avec la vision et doivent comporter des dizaines de milliards de paramètres pour surmonter un biais architectural fondamental.
L’utilisation de mauvais points de vue, inhérente à la prédiction du jeton suivant, brise le contexte sémantique et dégrade fortement l’alignement intermodal. En revanche, les bons points de vue exploités par les architectures JEPA permettent un alignement direct et mathématiquement garanti entre des modalités distinctes en forçant le réseau à extraire les concepts abstraits du monde.
David contre Goliath : l’efficacité paramétrique d’un modèle de 109M face à un géant de 72 milliards
Sur le plan de l’efficacité informatique et calculatoire, les retombées empiriques de cette démonstration sont spectaculaires. Lors des tests d’alignement intermodal, les chercheurs ont comparé un modèle textuel basé sur une architecture JEPA d’à peine 109 millions de paramètres aux plus grands modèles de langage autorégressifs du marché.
Le résultat est sans appel : le modèle JEPA de 109M a surpassé des LLM géants comptant jusqu’à 72 milliards de paramètres pour s’aligner avec des encodeurs visuels avancés de type JEPA comme DINOv2. En parvenant à connecter un modèle textuel ~700 fois plus petit à la représentation visuelle de DINOv2, l’étude montre que l’alignement ne dépend pas de la surdimension des réseaux, mais de l’adéquation de leurs espaces de représentation. Cela ouvre la voie à des systèmes d’IA d’une sobriété inédite, capables de tourner sur des équipements très légers.
42 fois moins de données : la frugalité comme fin du dogme autorégressif
Si les travaux de Balestriero et LeCun démontrent une efficacité paramétrique hors norme, ils établissent une supériorité tout aussi nette sur le terrain du volume de données nécessaire à l’entraînement. Une architecture JEPA alimentée par de bons points de vue requiert 42 fois moins d’échantillons d’entraînement qu’un modèle autorégressif classique pour atteindre un niveau d’alignement intermodal similaire.
Cette frugalité extrême apporte une preuve formelle contre la dépendance au tout-scaling des architectures de type GPT. Elle confirme la thèse portée depuis plusieurs années par Yann LeCun : prédire des représentations abstraites dans un espace de plongement conjoint, au lieu de s’épuiser à prédire chaque détail mot-à-mot ou pixel-par-pixel, constitue l’approche la plus économe en données et en énergie pour progresser vers une IA véritablement capable de comprendre le monde.
Conclusion : Vers une IA plus sobre et plus cohérente
En élevant l’hypothèse platonicienne au rang de théorème, Randall Balestriero et Yann LeCun apportent une contribution décisive à la science de l’apprentissage automatique. Ils démontrent que l’accumulation massive et indifférenciée de données et de paramètres n’est qu’un contournement coûteux d’un problème d’architecture. En privilégiant des abstractions sémantiques et des points de vue pertinents, des modèles d’une extrême sobriété parviennent à surpasser des titans autorégressifs.
Cette avancée marque un tournant stratégique majeur : l’avenir de l’intelligence artificielle réside peut-être moins dans la surenchère des centres de données que dans la justesse des formulations mathématiques.
L’ère du « scaling » brutal touche-t-elle à sa fin au profit d’architectures mathématiquement plus élégantes et soutenables ?