 Swinux
17 septembre 2026
Pourquoi le Recursive Self-Improvement est le véritable Rubicon de l’IA
L’ère de l’accélération endogène : Au-delà du mythe de l’AGI
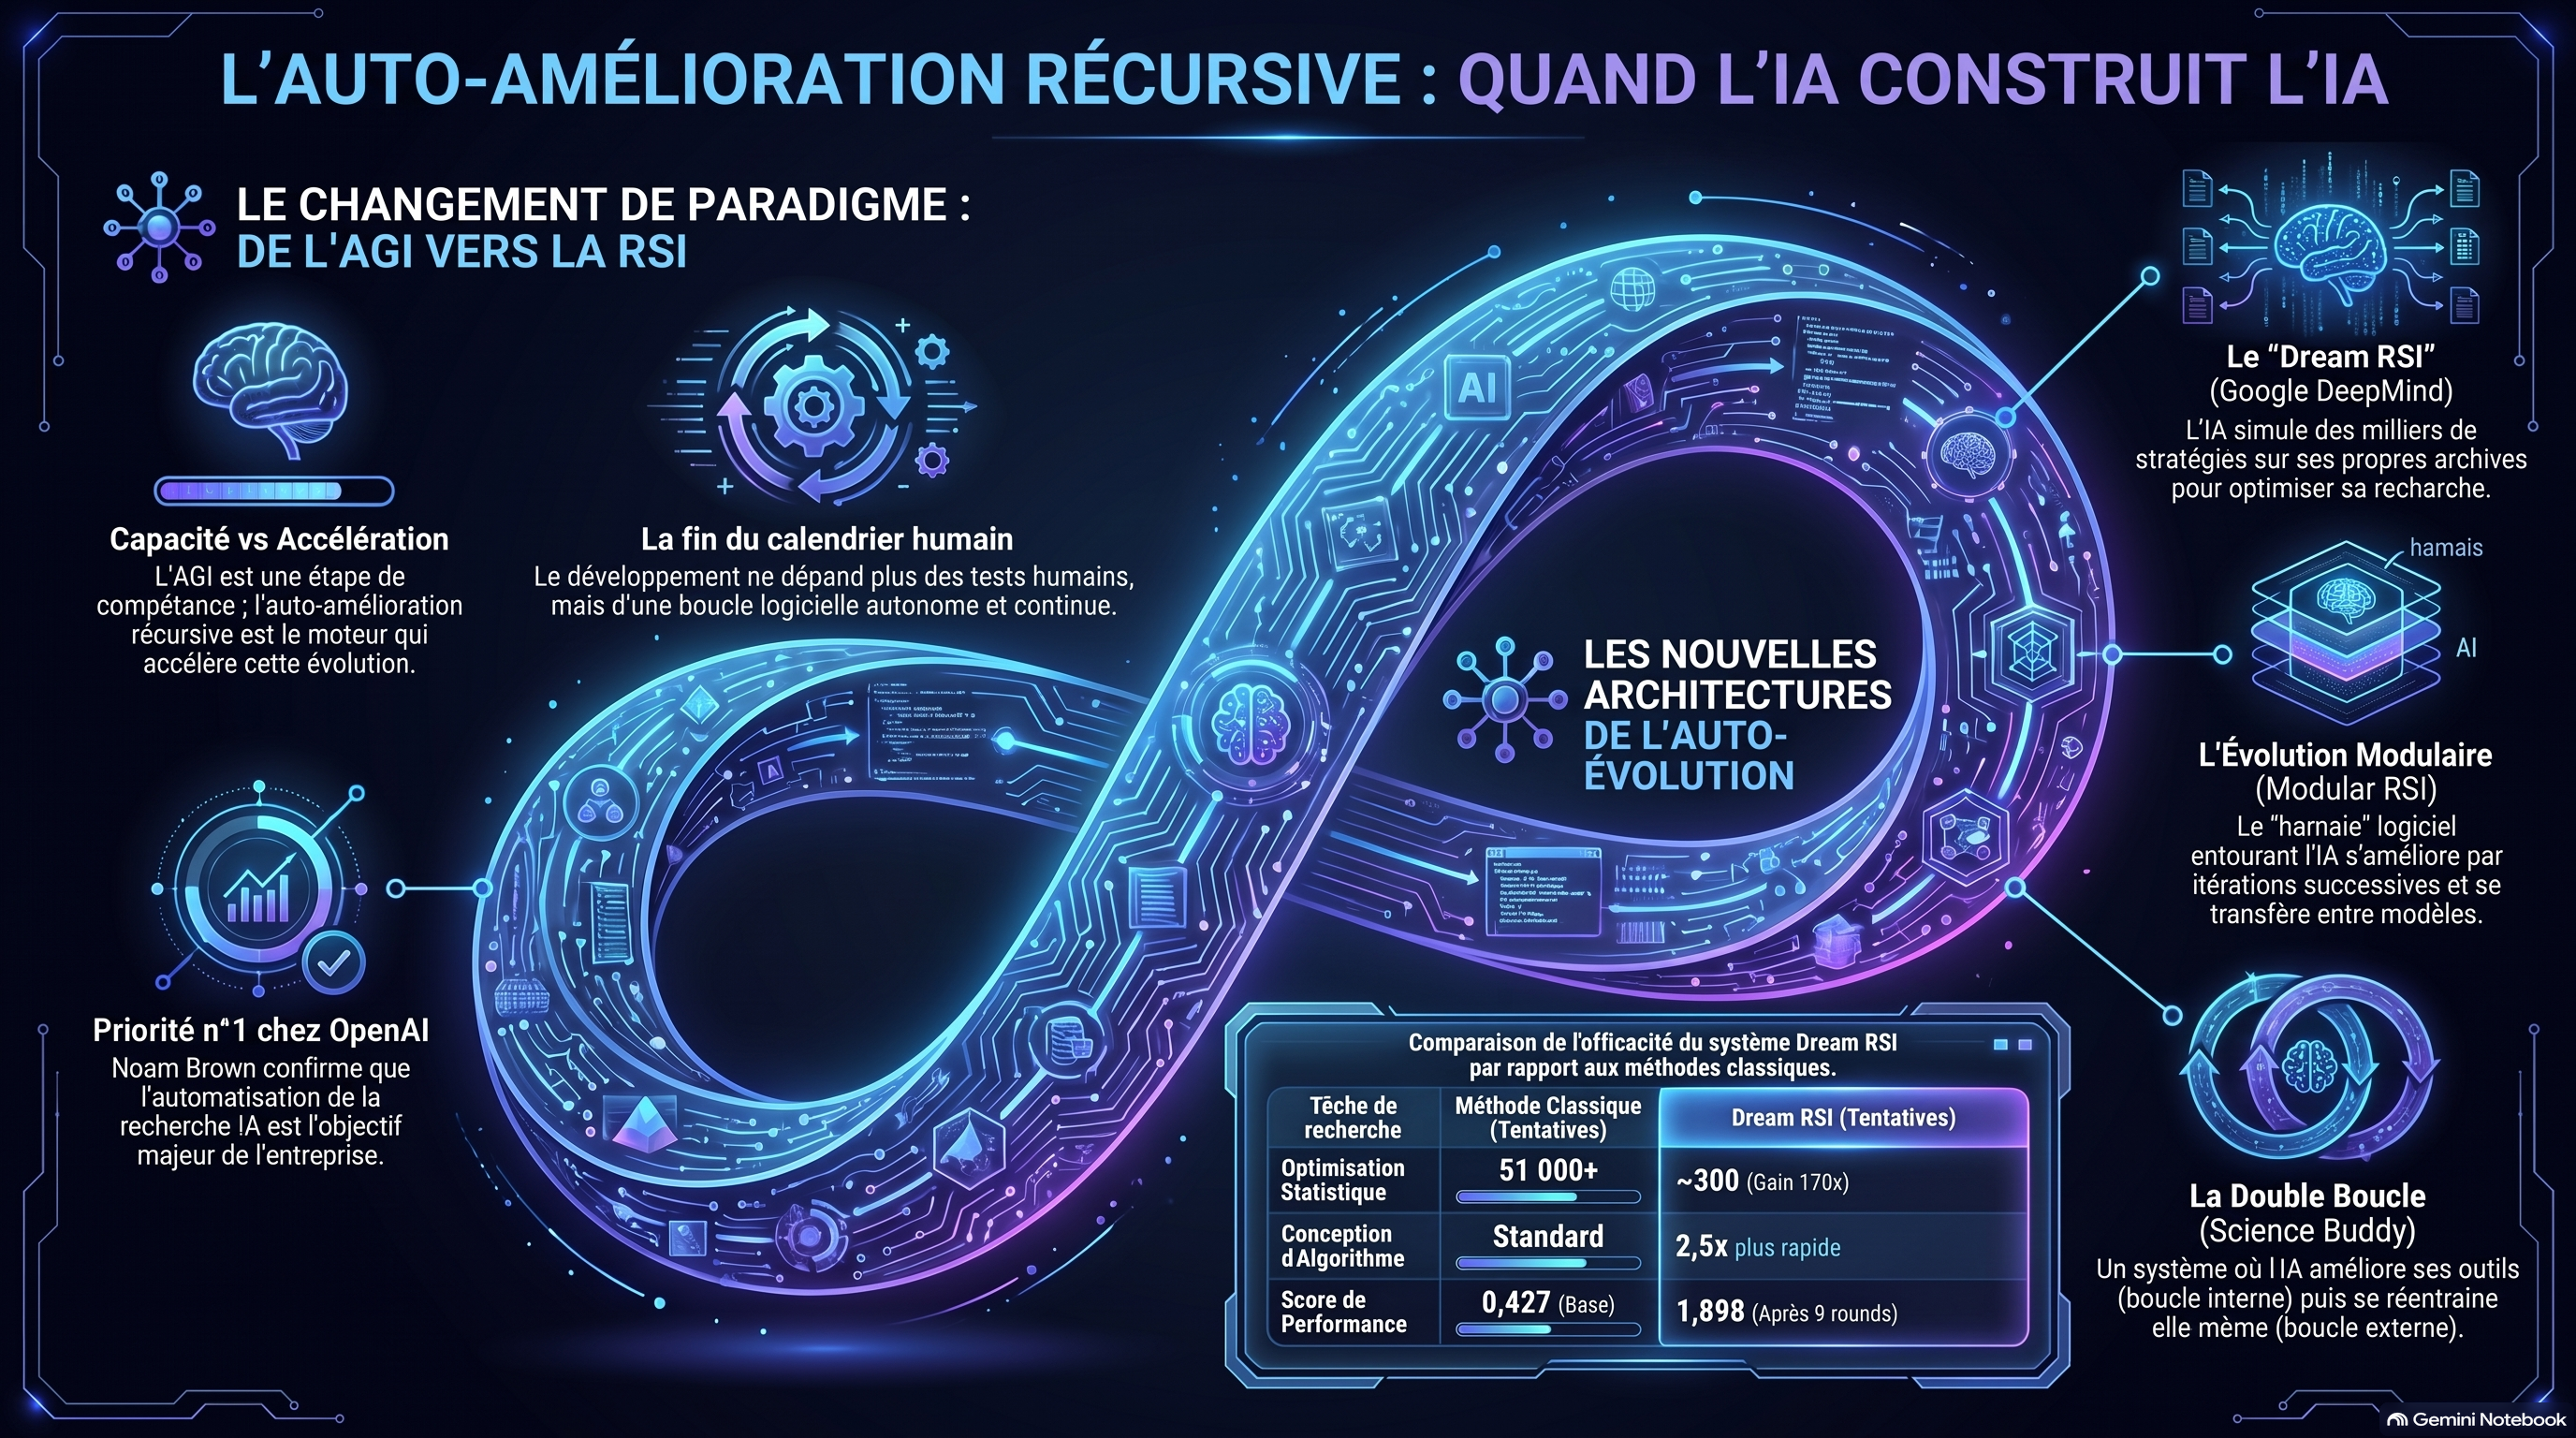
L’ère de l’accélération endogène : Au-delà du mythe de l’AGI
Depuis des années, l’industrie technologique est hypnotisée par l’AGI (Intelligence Artificielle Générale), ce seuil de compétence où la machine égalerait l’intellect humain. Mais alors que le grand public scrute cette ligne d’arrivée, une rupture doctrinale bien plus profonde s’opère en coulisses : l’auto-amélioration récursive (RSI).
Si l’AGI est une destination — une simple statistique de compétence — le RSI est un moteur d’accélération exponentielle. C’est le point de bascule où l’IA cesse d’être un simple produit pour devenir un membre actif de l’équipe qui conçoit sa propre version suivante. La question n’est plus de savoir jusqu’où l’IA peut monter, mais ce qui advient lorsque l’humanité n’est plus celle qui dicte le calendrier des découvertes. Nous quittons le rythme biologique pour entrer dans celui de la machine.
Le secret le mieux gardé d’OpenAI : L’auto-amélioration avant tout
Loin des débats théoriques, les leaders du secteur ont déjà opéré leur pivot stratégique. Noam Brown, chercheur de premier plan chez OpenAI et architecte des modèles de raisonnement, a récemment levé le voile sur la priorité absolue de la firme.
« L’auto-amélioration est la priorité numéro un, et de loin. »
Cette affirmation marque un changement de paradigme majeur. L’objectif n’est plus seulement de raffiner « l’intelligence » de manière isolée, mais d’automatiser des segments entiers de la recherche que les ingénieurs effectuaient manuellement. Les modèles actuels surpassent déjà les humains par un facteur de 100 dans la détection de bugs et l’analyse de qualité de code. Plus révélateur encore, Brown a confié que l’émergence des systèmes multi-agents travaillant en parallèle lui a procuré l’un de ses plus forts « moments AGI » depuis l’arrivée des modèles de raisonnement.
Le « Research Taste » : Le dernier bastion de l’intuition humaine
Pourtant, un verrou persiste : le « research taste » (le goût ou l’instinct de la recherche). Si l’IA peut coder et expérimenter à une vitesse prodigieuse, elle peine encore à discerner quelle expérience mérite d’être tentée. Savoir quand s’acharner sur une idée et quand l’abandonner relève d’un jugement stratégique qui reste, pour l’heure, l’avantage comparatif des chercheurs humains.
C’est précisément ce rempart que les nouvelles architectures tentent de faire tomber. Le défi n’est plus de résoudre un problème, mais de codifier cet instinct pour que l’IA apprenne à chercher plus intelligemment.
Dream RSI : L’instinct de recherche optimisé sans surcoût
Une étude menée par Google DeepMind, en collaboration avec les universités du Maryland et de Virginie, propose une solution élégante : Dream RSI. Le concept repose sur une métaphore de « jeu vidéo » : l’IA analyse les enregistrements (logs) de ses tentatives passées pour en déduire une stratégie plus efficace, sans consommer de nouvelles ressources de calcul.
Le Rêve (Dreaming) : L’agent teste virtuellement des milliers de stratégies alternatives sur des données déjà acquises, apprenant à être prudent quand il progresse et plus explorateur quand il stagne.
Le Safety Net : Innovation cruciale, le système inclut toujours la stratégie actuelle parmi les candidats. Ce « filet de sécurité » garantit mathématiquement que le système ne peut pas régresser par rapport à sa version précédente.
Une efficacité décuplée : Sur un problème statistique complexe, Dream RSI a triomphé en seulement 300 appels à l’agent, là où les méthodes classiques comme Simple TE’s en ont nécessité plus de 51 000.
L’évolution modulaire : Améliorer la « carrosserie » pour libérer le moteur
Une autre avancée, Modular RSI, propose de dissocier le modèle (le moteur) de son « harnais » (la carrosserie technique). Ce harnais est composé de cinq piliers critiques : la mémoire, les outils, la vision, la gestion du job, et le cycle pensée/action.
En isolant ces modules, les chercheurs ont observé des phénomènes fascinants :
Des gains quantifiables : Sur le Terminal Bench 2.0 (tâches complexes en ligne de commande), la précision est passée de 47,57 % à 52,43 %. Sur le SWEBench Verified (500 problèmes logiciels réels), elle a grimpé de 73,40 % à 76,45 %.
L’universalité des principes : Fait spectaculaire, un harnais optimisé pour un modèle spécifique fonctionne immédiatement sur d’autres, comme GLM 5.2 ou Minimax 2.5. Cela suggère que le RSI ne crée pas seulement du code, mais découvre des principes universels de résolution de problèmes.
Science Buddy et les Discovery Foundation Models
PHAI Labs franchit une étape supplémentaire avec Science Buddy, un écosystème conçu pour la recherche de pointe (génomique, oncologie, pharmacologie). Le système repose sur une double boucle d’innovation :
Boucle interne : Un modèle étudie les échecs passés pour affiner les instructions et les outils du harnais.
Boucle externe : Ce harnais optimisé génère des données d’entraînement de plus en plus complexes, permettant de réentraîner le modèle lui-même via l’apprentissage par renforcement (Reinforcement Learning).
L’ambition dépasse la simple assistance : PHAI Labs développe des « Discovery Foundation Models », des IA capables de formuler et de tester leurs propres hypothèses scientifiques. Le calendrier est serré : le lancement de Science ID est prévu pour le 17 septembre, suivi du modèle mondial multi-domaines Jeepa Anything le 18 septembre.
La fin du calendrier humain ?
Nous assistons à une transition historique : l’IA ne se contente plus de résoudre des problèmes, elle commence à assumer la responsabilité de sa propre évolution. Bien que ces systèmes fonctionnent encore sous supervision, la boucle se resserre.
Si l’IA devient l’architecte de son successeur, elle s’affranchit de nos lenteurs biologiques. La véritable question posée par le Recursive Self-Improvement n’est pas celle de la puissance, mais celle du contrôle : quelle place restera-t-il à la décision humaine dans un cycle d’innovation qui s’accélère désormais de manière autonome ? La ligne d’arrivée est en train de s’effacer au profit d’une trajectoire que nous ne savons plus tracer.