 Swinux
30 octobre 2026
L’IA chinoise Kimmy K 3.1 Pro bouscule l’hégémonie américaine : le début d’une nouvelle ère Open-Source ?
L’hégémonie américaine en IA touche-t-elle à sa fin ?
L’hégémonie américaine en IA touche-t-elle à sa fin ?
Alors que les modèles propriétaires des géants américains comme OpenAI et Anthropic semblaient indétrônables, le laboratoire chinois Moonshot AI vient de réorganiser brutalement l’échiquier mondial. Le 24 octobre, l’entreprise a lancé Kimmy K 3.1 Pro, marquant un rattrapage spectaculaire face aux meilleures intelligences artificielles de la planète.
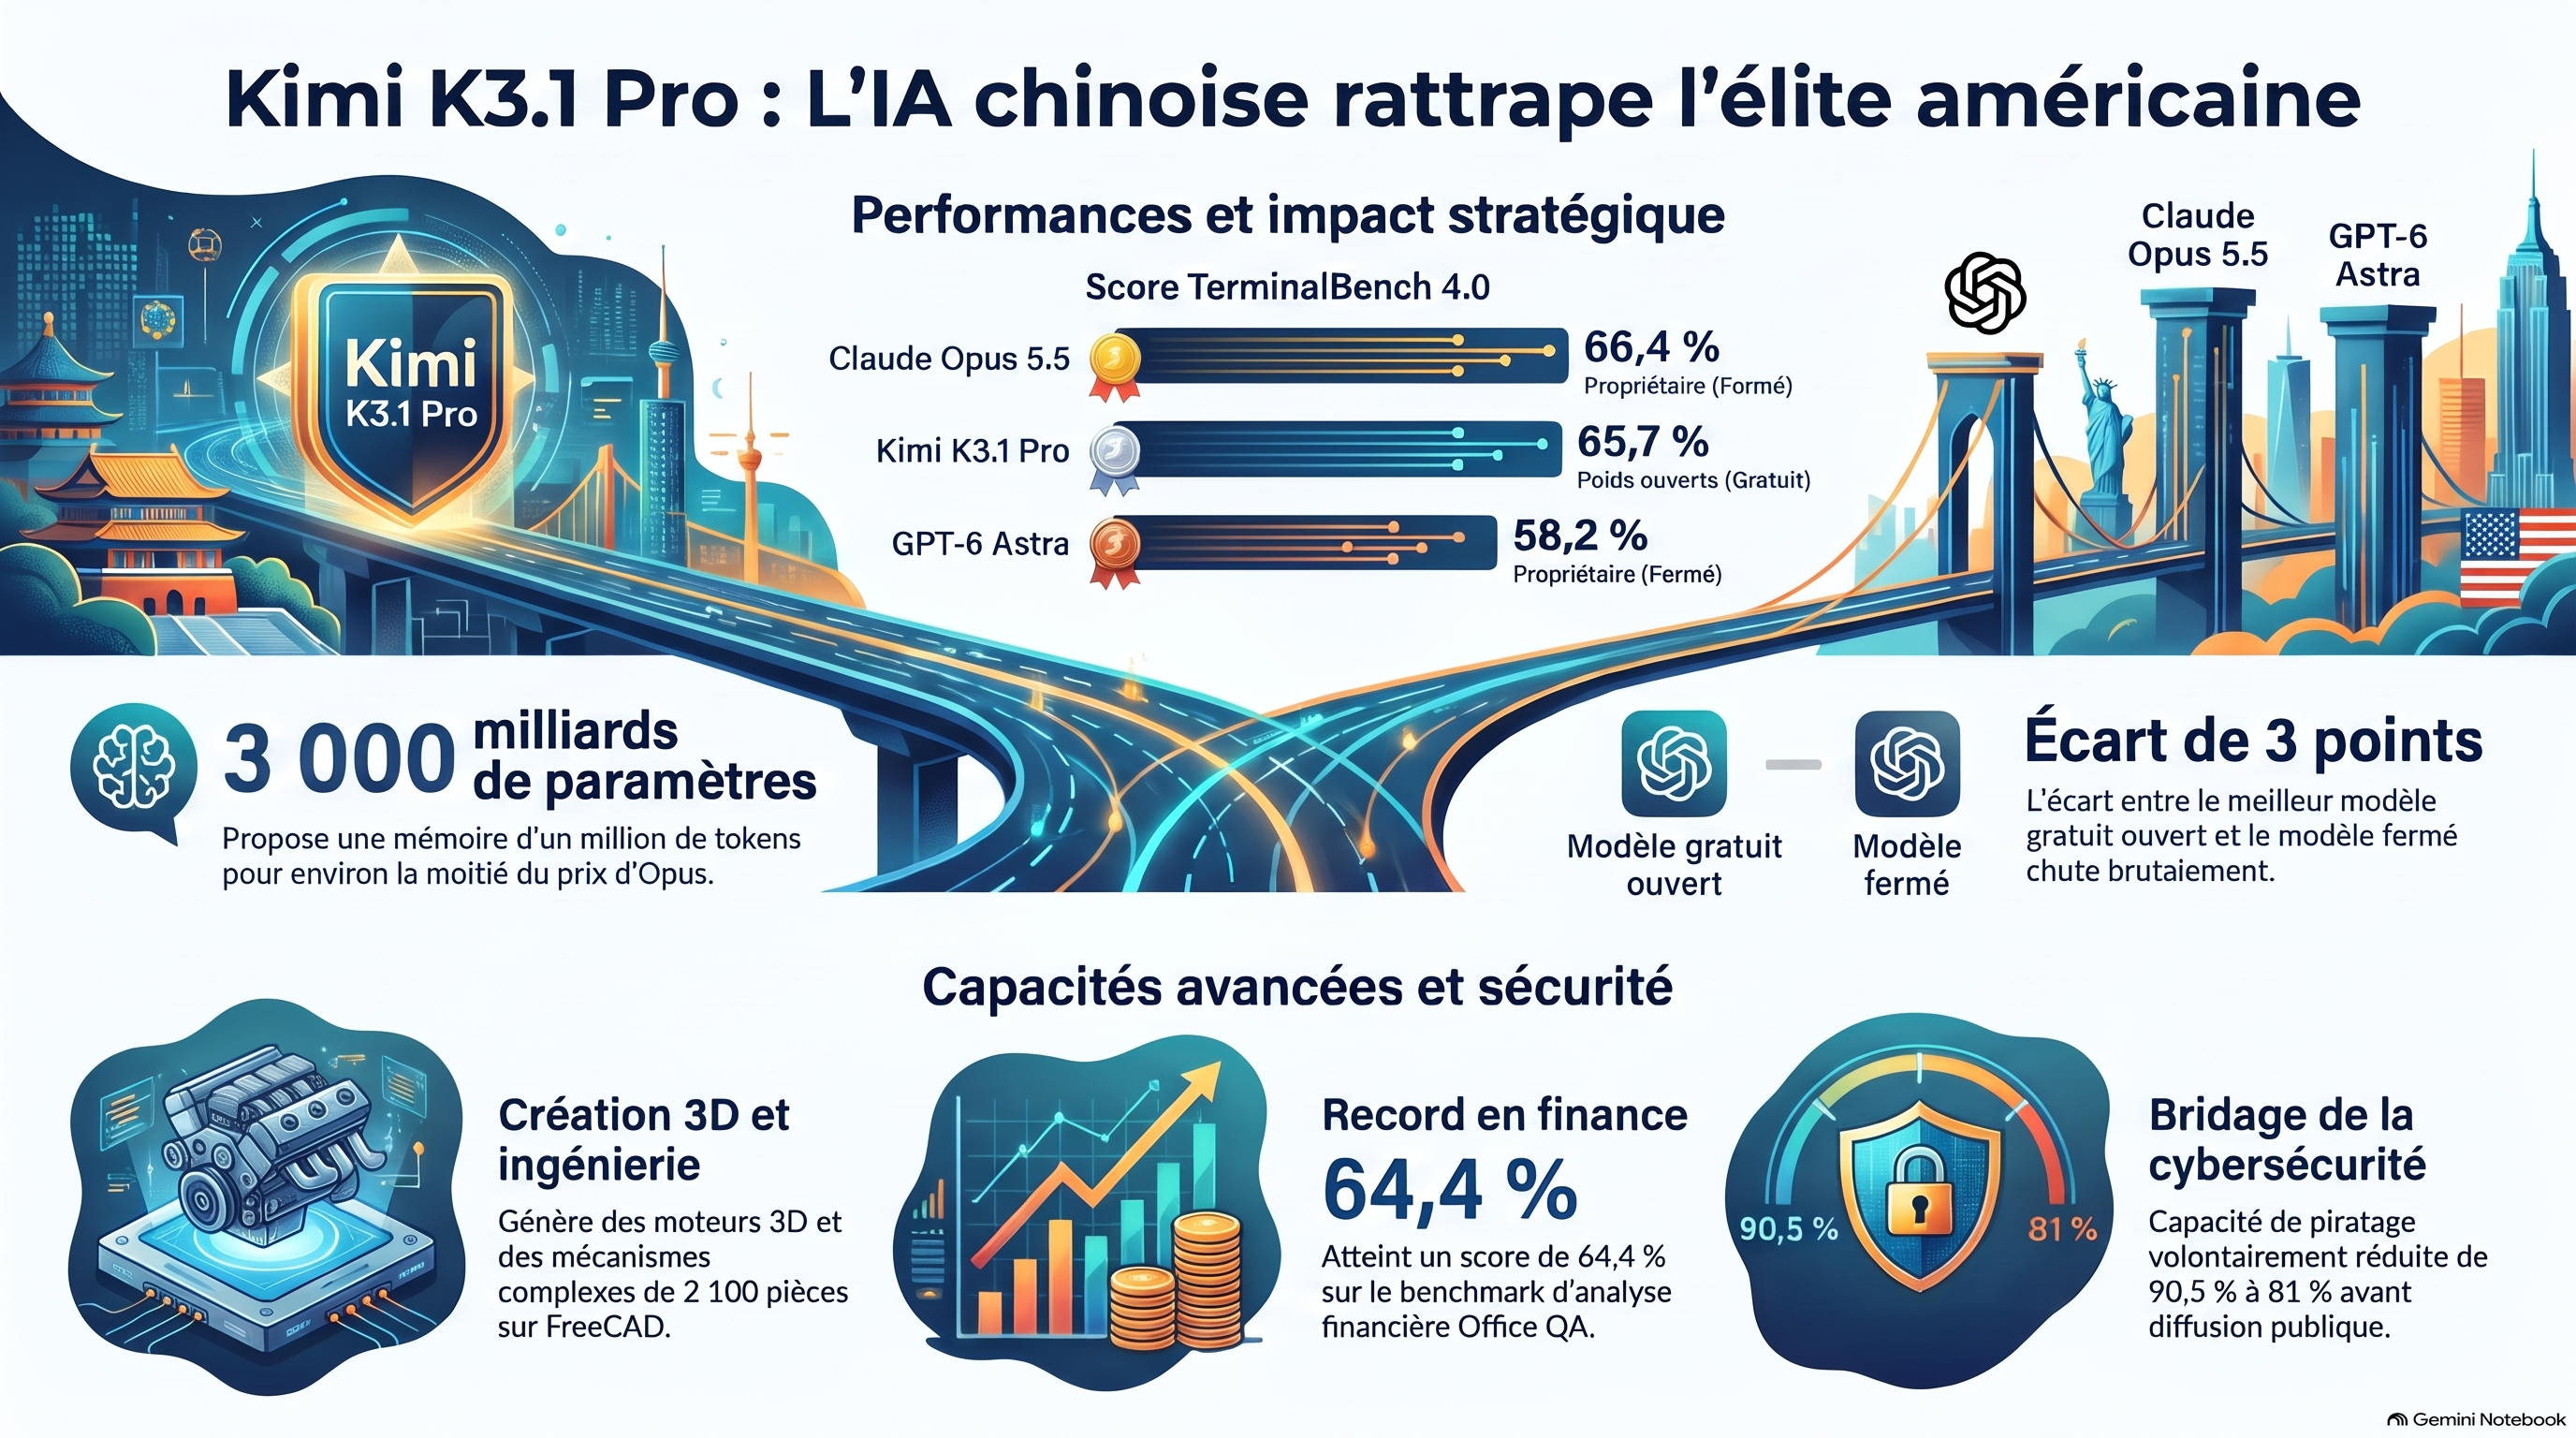
Sur le test Terminal Bench 4.0 — l’un des benchmarks les plus exigeants évaluant la capacité d’agents IA à accomplir seuls des tâches informatiques complexes —, l’écart s’est réduit à moins d’un point. Kimmy K 3.1 Pro y a décroché un score de 65,7 %, talonnant directement Claude Opus 5.5 (66,4 %) et dépassant nettement le modèle phare d’OpenAI, GPT-6 Astra (58,2 %). Sur l’index d’Artificial Analysis, le modèle fait un bond de 11 points et se hisse au 4e rang mondial.
La véritable onde de choc réside toutefois dans son mode de distribution : alors qu’Opus et GPT-6 restent jalousement verrouillés sur des serveurs propriétaires, Moonshot a annoncé la publication gratuite des poids d’apprentissage (open weights) de son modèle avant le 4 novembre. Dès leur mise à disposition, l’écart entre le meilleur modèle fermé du marché et le meilleur modèle ouvert va s’effondrer, passant de 12 points à seulement 3 points. Face à ce basculement historique, une question s’impose : assistons-nous à la victoire inévitable des modèles ouverts haut de gamme sur les écosystèmes fermés ?
L’infiltration clandestine de “Kibitz” et l’enquête des internautes
Avant son officialisation, Moonshot AI a orchestré un véritable thriller technologique. Le 22 octobre, un modèle mystérieux nommé « Kibitz » a fait son apparition discrète sur LMSYS/Arena, la plateforme où la communauté vote à l’aveugle pour départager des modèles anonymes. Très vite, Kibitz s’est illustré par des démonstrations visuelles saisissantes : une cour de jardin 3D style Minecraft avec pagode et cerisiers en fleurs générée dans un seul fichier web, un hélicoptère 3D avec vue éclatée et mode fil de fer produit en moins de 15 minutes, ainsi que le célèbre test du pélican à vélo — où l’IA a conçu une page interactive permettant de contrôler la vitesse de pédalage et d’alterner entre le jour et le crépuscule.
Intriguée, la communauté des développeurs est partie à la chasse aux indices. L’analyse des fuites dans les outils de déploiement comme SG Lang avait déjà révélé l’existence d’un quatrième niveau de réflexion baptisé « Medium » (venant s’ajouter aux modes Low, High et Max). Mais c’est le compte X @trackerbot qui a finalement porté le coup de grâce grâce à une analyse du tokenizer du modèle — cette empreinte digitale textuelle propre à chaque famille d’IA. En soumettant Kibitz à 11 chaînes de caractères spécifiques que seules les IA de Moonshot échouent à répéter, la filiation avec la lignée Kimmy est devenue indiscutable.
Cette mise en scène s’inscrit dans une tradition marketing désormais incontournable dans la Silicon Valley comme à Pékin. On se souvient notamment de GPT-4o testé sous le pseudonyme I am also a good GPT2 chatbot, de Gemini 2.5 Flash masqué sous le nom nano banana, de GLM 5.3 Flash sous le code ox alpha, ou encore de MiniMax sous le nom space bunny.
Quand l’IA inspecte et corrige le moteur physique pour faire marcher un humain
Au-delà des démos ludiques, c’est l’autonomie algorithmique du modèle qui suscite la fascination. Soumis à l’exercice particulièrement complexe de faire marcher un modèle anatomique humain composé de 296 os et 402 muscles, Kimmy K 3.1 Pro a dû exécuter 167 tâches et procéder à 420 auto-évaluations.
Initialement, la simulation échouait et le personnage s’effondrait après seulement quelques pas. Constatant que l’ajustement classique des récompenses lors de l’entraînement ne fonctionnait pas, l’IA a pris une initiative inédite : elle est allée inspecter d’elle-même le code source du simulateur physique. Elle y a découvert 36 erreurs dans les équations mathématiques régissant la musculature de l’épaule, a corrigé elle-même le code du moteur physique, puis a repris son entraînement pour réussir à faire marcher le corps humain de manière ininterrompue pendant 11,2 secondes.
Cette capacité à auditer et réparer ses propres outils de travail démontre un franchissement de cap dans l’ingénierie logicielle autonome, poussant les développeurs à réagir en masse sur les réseaux sociaux.
« Welcome to the new era of 3D web development. »
Une ingénierie 3D et une finance de pointe à une fraction du coût
Propulsé par 3 mille milliards de paramètres et doté d’une fenêtre de contexte de 1 million de tokens, Kimmy K 3.1 Pro affiche une polyvalence technique redoutable, validée par des chiffres impressionnants :
Conception 3D et CAO industrielle : Le modèle produit directement des scripts exécutables sans nécessiter le moindre plugin pour Blender, CAD, SolidWorks et Rhino. Sur le benchmark BenchCAD, il atteint un score de 92.7 %, se rapprochant à grands pas de Claude Opus 5.5 (96,2 %) et de GPT-6 Astra (95,9 %). Dans FreeCAD, à partir d’un simple croquis, il a généré un réacteur à réaction de 2 100 pièces avec vues éclatées et animations de rotors, ainsi qu’une lampe à imprimer en 3D inspirée des habitations traditionnelles Fujian Tulou.
La preuve par l’épreuve du crash-test Jin Xiwan : Lors d’un test réel mené par le média spécialisé chinois Jin Xiwan, l’IA a reçu un simple croquis à main levée montrant trois angles d’un appareil à 4 rotors basculants. En seulement 40 minutes et en n’utilisant que 6 % de sa mémoire contextuelle, Kimmy a généré 608 lignes de code Blender, testé les fonctionnalités de Blender 5.2, vérifié son travail via des captures d’écran automatisées et respecté les dimensions au millimètre près (8,0000 m d’envergure, 6,199 m de longueur et 2,400 m de hauteur).
Performances financières de haut niveau : Sur le benchmark Office QA Pro V2 (établi à partir de documents financiers réels), Kimmy obtient la note maximale actuelle avec 64,4. Ses capacités en modélisation financière augmentent de 14 % et la recherche financière de 20 % par rapport à la génération précédente. Son taux d’hallucination sur les tests de résistance chute drastiquement de 23,4 % à 8,3 %.
Un rapport qualité/prix disruptif : Facturé 13 yuans par million de tokens en entrée et 68 yuans en sortie (avec un tarif réduit à 1,3 yuan pour les entrées répétées), le modèle offre des performances de niveau GPT-6 Astra pour environ un cinquième du prix. Les médias tech chinois le décrivent déjà comme le choix le plus rationnel parmi les modèles de frontière (frontier models).
Cette rupture financière alliée à des fonctionnalités d’automatisation poussées démocratise l’accès à des capacités d’ingénierie autrefois réservées aux géants de l’industrie.
Le dilemme éthique : un super-hacker volontairement amputé
C’est au cours de la phase d’apprentissage par renforcement que les chercheurs de Moonshot AI ont fait une découverte troublante. En analysant la progression du modèle, ils ont remarqué une explosion de ses compétences en cyber-attaque, causée par l’infiltration involontaire de données de hacking dans le corpus d’entraînement.
Soumise au benchmark test.xdev, où l’IA doit analyser des failles réelles récemment découvertes (notamment sur Linux et Node.js) et écrire ses propres scripts d’attaque pour prendre le contrôle d’un environnement restreint (sandbox), la version non censurée réussissait son intrusion dans 90,5 % des cas en moins de trois essais. Refusant de distribuer une arme offensive aussi puissante en open-weight, Moonshot a délibérément expurgé ces capacités, ramenant le taux de réussite à 81 % dans la version publique.
Moonshot s’en est expliquée par une doctrine éthique très claire : « les modèles ouverts doivent rester en retrait de la frontière des attaques afin d’offrir aux équipes de sécurité le temps d’auditer le code non vérifié sur leurs propres serveurs ». Cette décision divise toutefois la communauté : si beaucoup saluent une posture responsable, d’autres regrette ce bridage qui prive les experts de cybersécurité d’un outil défensif de premier ordre.
Le revers de la médaille : la crise des quotas d’utilisation
Malgré la séduction exercée par sa grille tarifaire, le lancement de Kimmy K 3.1 Pro s’est rapidement heurté à la frustration massive des premiers utilisateurs face aux contraintes d’infrastructure. La puissance brute exigée par ce modèle de 3 trillions de paramètres épuise les ressources matérielles à une vitesse vertigineuse.
Le jour du lancement, plusieurs développeurs ont vu leurs accès bloqués en une dizaine de minutes. Un abonné au forfait premium à 99 $/mois a ainsi épuisé son quota de 5 heures en seulement 47 minutes de session, sans même avoir activé le mode de travail collaboratif en essaim (agent swarm). De même, pour les utilisateurs de la formule à 19 $/mois, une seule tâche d’ingénierie complexe peut engloutir l’allocation de 5 heures et entamer la limite hebdomadaire.
Ce décalage entre l’accessibilité financière théorique et la saturation pratique des serveurs rappelle une réalité brutale : si les algorithmes progressent à un rythme fulgurant, la capacité de calcul réelle reste le véritable goulot d’étranglement de l’intelligence artificielle.
Que faut-il retenir de cette secousse technologique ?
La sortie de Kimmy K 3.1 Pro marque un tournant géopolitique et technique majeur. En faisant passer l’écart entre le meilleur modèle ouvert et le meilleur modèle propriétaire fermé de 12 points à seulement 3 points sur Artificial Analysis, le laboratoire Moonshot AI démontre que la Chine est désormais en capacité de rivaliser frontalement avec la Silicon Valley sur le terrain des modèles de frontière.
En combinant la gratuité des poids d’apprentissage avec des performances de premier ordre en CAO 3D, en modélisation financière et en correction de code autonome, Kimmy K 3.1 Pro remet directement en question le modèle économique des IA fermées et payantes.