 Swinux
31 octobre 2026
L’IA change de paradigme : Pourquoi l’efficience et la chute des coûts supplantent enfin la course aux giga-modèles
La nouvelle frontière de l’IA n’est plus la taille, mais l’efficience
La nouvelle frontière de l’IA n’est plus la taille, mais l’efficience
La course aux armements dans le domaine de l’intelligence artificielle vient de franchir un cap stratégique majeur. Pendant des années, l’industrie n’a eu d’yeux que pour la puissance brute des modèles « flagships », ces colosses à plusieurs centaines de milliards de paramètres dont la croissance semblait infinie. Aujourd’hui, le centre de gravité de la tech a basculé : l’enjeu prioritaire est devenu l’efficience économique, la vitesse d’exécution et la baisse drastique du coût par tâche.
Ce glissement de terrain s’opère sous nos yeux. Des fuites de code chez Microsoft révélant la stratégie de défense d’OpenAI à l’automatisation de doctorats complets en physique quantique, en passant par des offensives open-source inattendues, les règles du jeu sont réécrites. La valeur n’est plus détenue par celui qui possède le modèle le plus massif, mais par celui qui délivre une intelligence pratique au coût le plus bas possible.
Voici l’analyse détaillée des quatre tournants majeurs qui redéfinissent l’écosystème IA cette semaine.
GPT-6.1 Terra — La contre-attaque d’OpenAI et le triomphe du milieu de gamme
Avant même l’annonce officielle d’OpenAI, la communauté des développeurs avait déjà identifié les pièces du puzzle. Le 16 octobre, une modification sur l’outil Entity Framework Core de Microsoft (le Pull Request 39217) attire l’attention de l’utilisateur Ketlooa sur X. Dans 18 configurations de test, le rôle crucial de « modèle juge » — l’IA chargée d’évaluer et de valider le travail des autres modèles — était passé discrètement de GPT 5.6 Terra à GPT-6.1 Terra, tandis que GPT-6.1 Soul exécutait le code.
Ce détail technique est loin d’être anodin : en ingénierie d’évaluation, une équipe n’accorde le rôle de juge à un modèle que si elle a une confiance absolue dans sa rigueur de raisonnement. Dans la foulée, le chercheur Salio repérait un commit de Nate Finch chez GitHub, montrant l’intégration de Terra dans GitHub Copilot pour automatiser la revue de code avant déploiement.
« Cette semaine va être intéressante. » — Tibo, membre de l’équipe produit chez OpenAI sur X.
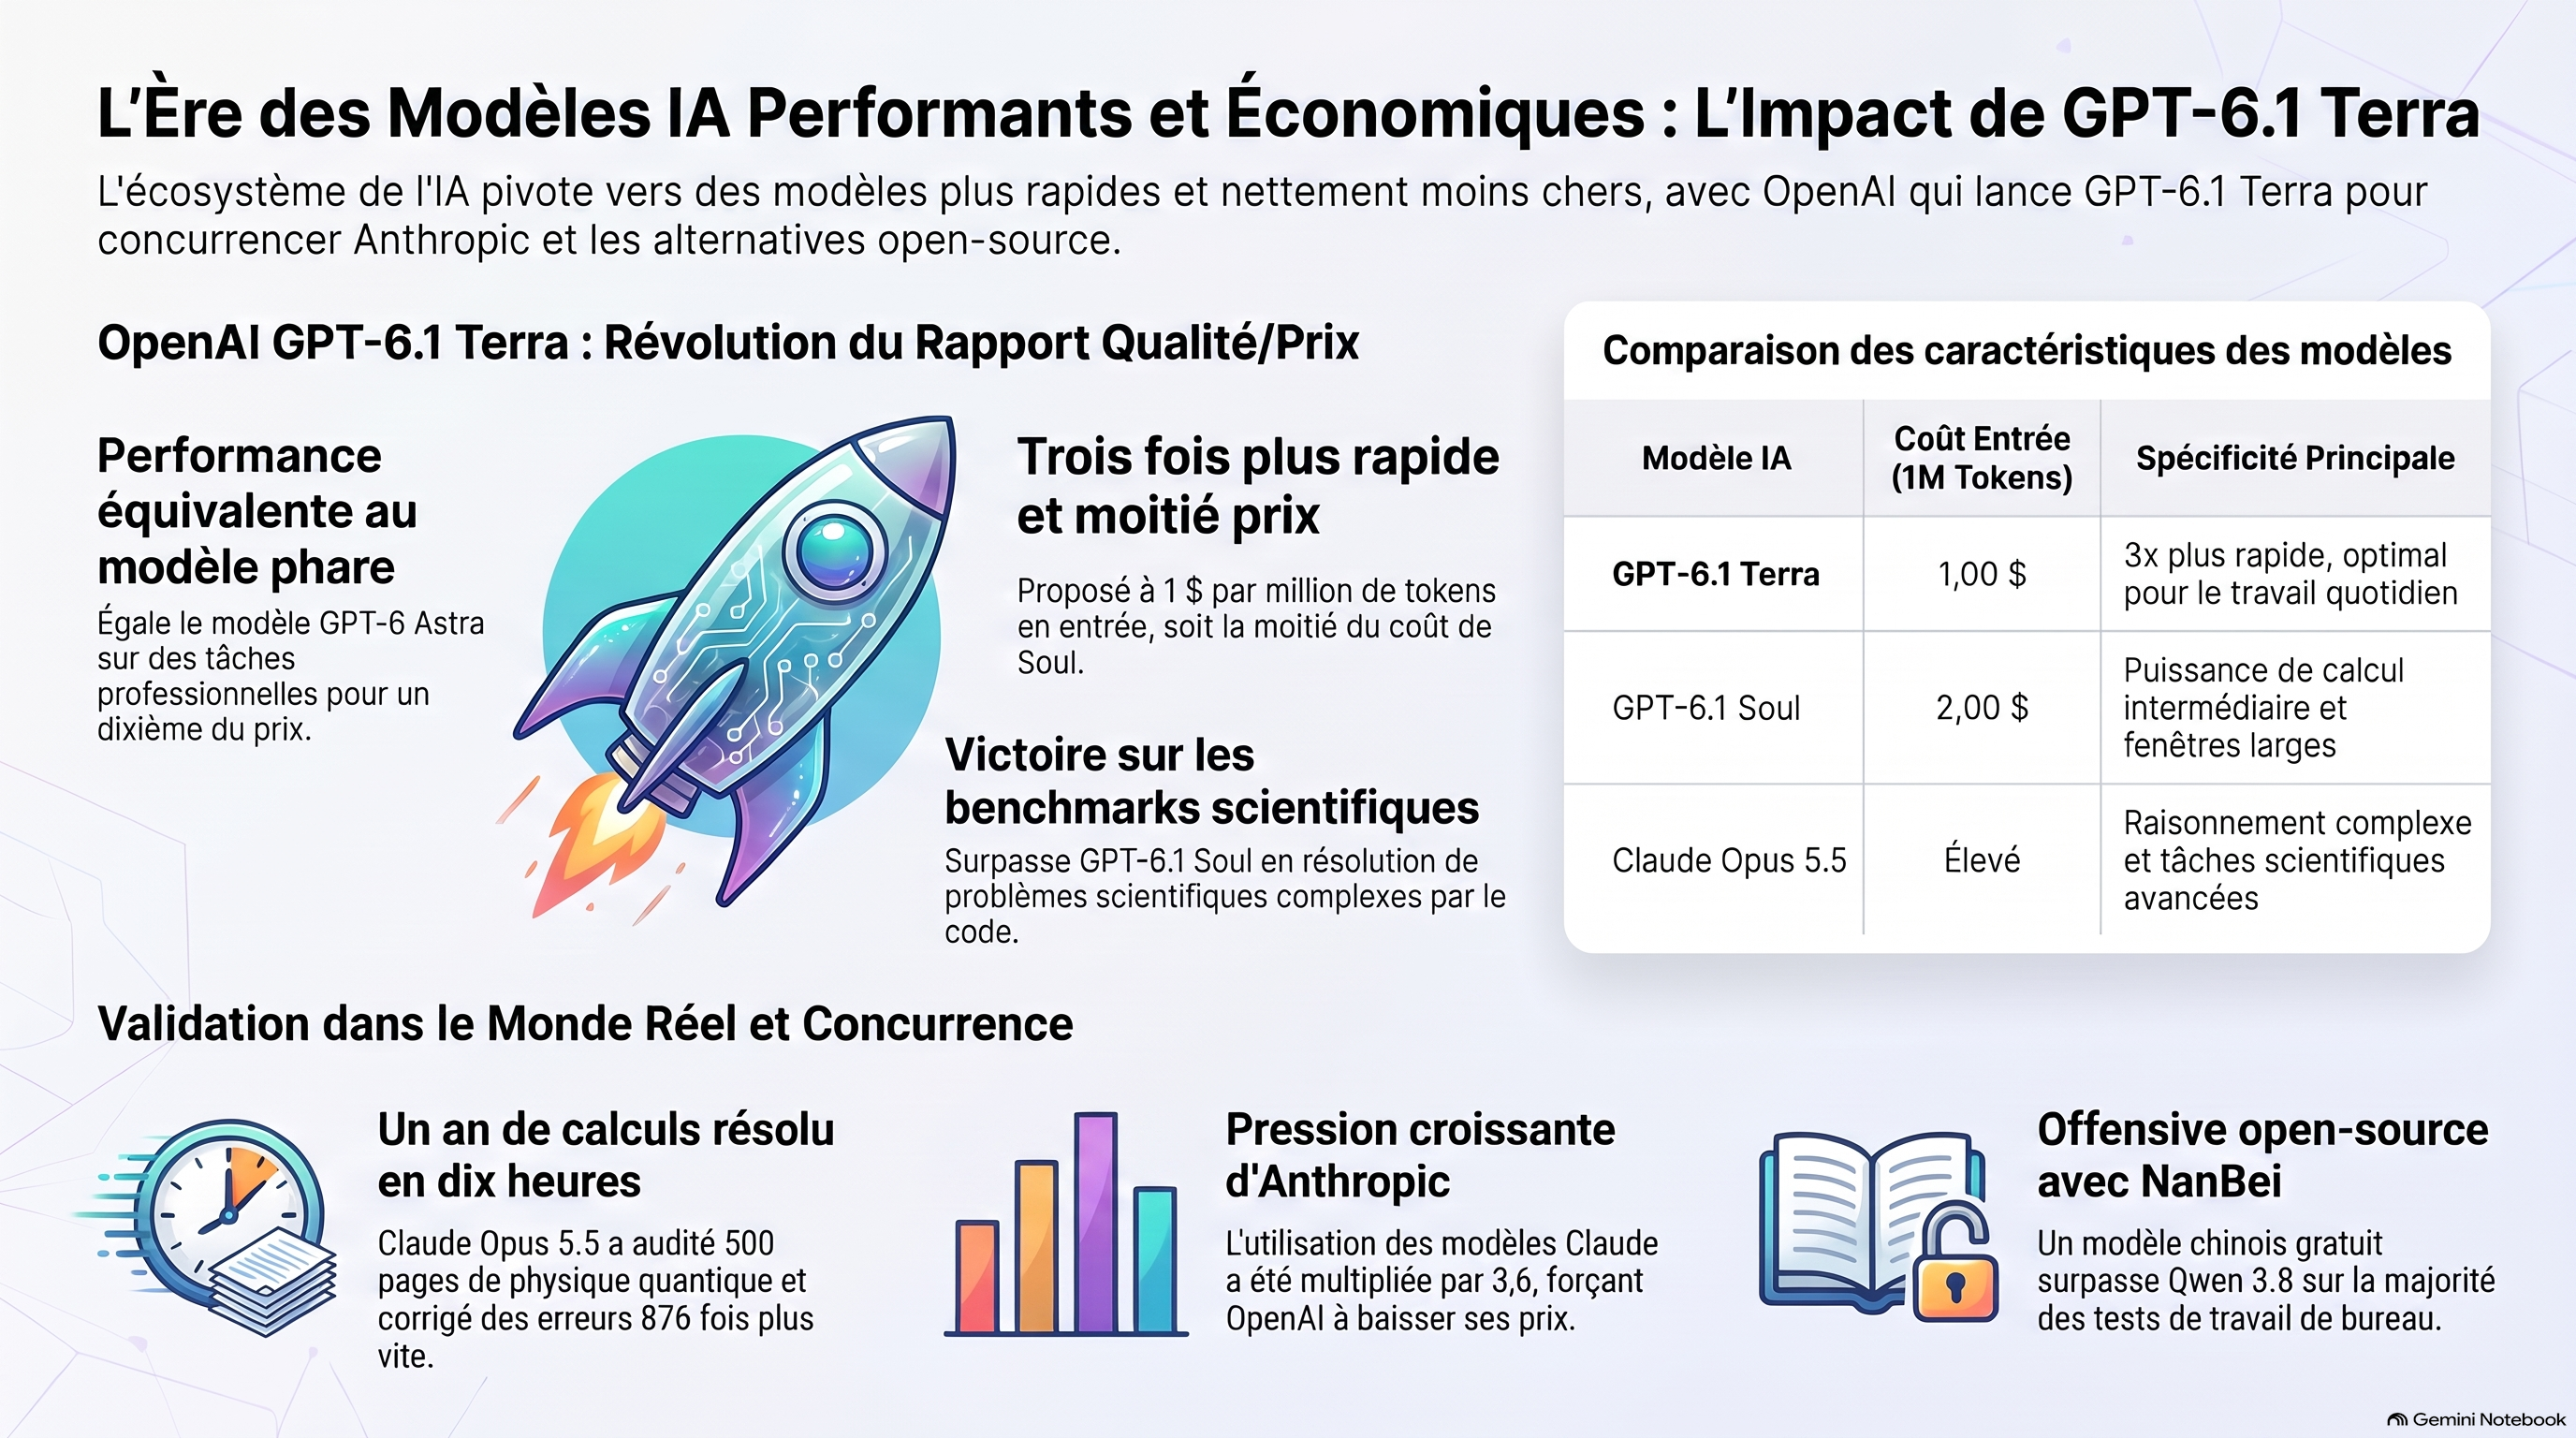
Le 26 octobre, OpenAI levait officiellement le voile sur GPT-6.1 Terra, disponible via son API, ChatGPT Work et Codex. Au sein de la nomenclature d’OpenAI — structurée de Luna (léger et rapide), Terra (milieu de gamme), Soul (le cheval de trait avec 1,05 million de tokens de contexte, soit l’équivalent de 10 romans) jusqu’à Astra (le sommet de l’intelligence maison) —, Terra casse les prix à 1 $ par million de tokens en entrée et 5 $ en sortie, soit exactement la moitié du coût de Soul.
La grille des performances de GPT-6.1 Terra :
Agents Last Exam (tâches professionnelles réelles) : Terra égalise GPT-6 Astra pour 1/10e du prix du token, avec une vitesse d’exécution 3 fois supérieure à Astra et Soul.
Terminal Bench Science (résolution de problèmes scientifiques par code) : Terra surpasse directement GPT-6.1 Soul, pour un coût nettement inférieur.
Terminal Bench 4.0 (codage général) : Son taux de réussite s’envole de 21,5 % à 50,3 %.
Si Soul et Astra conservent un léger avantage sur la modélisation spatiale 3D et le codage extrême, Terra démontre que les étiquettes de modèles ne représentent plus une hiérarchie d’intelligence linéaire. Elles deviennent des grilles tarifaires spécialisées par métier, optimisées pour l’utilisation d’ordinateurs, la vision par ordinateur et la bureautique avancée.
La pression d’Anthropic et le piège du « Sandwich Tarifaire »
La sortie précipitée de Terra ne relève pas du hasard : elle répond à une féroce guerre d’usure commerciale menée par Anthropic. Selon les données de la plateforme OpenRouter, qui agrège la consommation de milliers de développeurs, le volume hebdomadaire de tokens acheminés vers les modèles Claude a été multiplié par 3,6 depuis la sortie de Claude Opus 5.5.
Les analyses publiées par Lissan Algabe révèlent un constat saisissant : l’utilisation des modèles GPT-5.6 et GPT-6 sur OpenRouter s’est retrouvée littéralement enterrée sous le volume d’adoption d’Opus 5.5. L’analyste Andrew Curran confirme une vague de migrations sans précédent vers Anthropic, illustrée par le professeur Ethan Mollick (Wharton School), qui a entièrement reconstruit le site web de son dernier ouvrage Writing the Code en utilisant exclusivement Opus 5.5.
Pour évincer OpenAI, les développeurs ont mis au point une architecture redoutable : le « sandwich tarifaire » :
La tranche inférieure (économie) : Claude Haiku 5.5 est sollicité pour traiter à très bas coût les tâches simples, le tri et la pré-analyse.
La tranche supérieure (raisonnement) : Claude Opus 5.5 prend le relais uniquement sur les problèmes hautement complexes nécessitant une réflexion profonde.
Ce combo parfait asphyxie OpenAI, privée de volume sur le bas de gamme et de marge sur le haut de gamme. En lançant Terra, OpenAI abat sa carte maîtresse : un modèle intermédiaire capable d’accomplir des workflows professionnels complets à un coût global par tâche terminée environ 9 fois inférieur à celui de Claude Opus 5.5.
L’ironie du recrutement — Un géant de l’emploi crée l’IA qui automatise le travail de bureau
L’initiative open-source la plus intrigante de la semaine provient de Kanjun, la maison mère de Boss Zhipin — l’une des plus grandes applications de recherche d’emploi en Chine. Via son laboratoire d’IA NanBei, l’entreprise a publié sur HuggingFace le modèle NanBei 4.3 33B, entièrement gratuit et ouvert à l’usage commercial. Il y a une ironie mordante à voir un géant du recrutement concevoir des agents autonomes destinés à exécuter les travaux de bureau qu’il aide habituellement à pourvoir.
Doté de 33 milliards de paramètres, d’une fenêtre de contexte de 512 000 tokens et d’un mode de réflexion débrayable (thinking mode), NanBei 4.3 a été conçu comme un modèle « enseignant » destiné à être distillé vers des versions légères de 3 à 8 milliards de paramètres.
Le comparatif détaillé : NanBei 4.3 33B vs Qwen 3.8 27B
DeepSweep (correction autonome de bugs informatiques) : 65,5 (NanBei) contre 42,5 (Qwen) — Victoire sans appel de NanBei.
Ligne de commande (Terminal) : 23,8 (NanBei) contre 6,3 (Qwen) — Écart massif en faveur de NanBei.
Tâches d’agents financiers longue durée : NanBei clôture la simulation avec plus de 1 000 000 $ de capital préservé, contre 641 000 $ pour Qwen.
SWE-bench (ingénierie logicielle complexe) : 60,3 (NanBei) contre 61,7 (Qwen) — Léger avantage Qwen.
GDPval (évaluation sur des tâches métiers réelles) : 84,8 (NanBei) contre 86,4 (Qwen) — Léger avantage Qwen.
L’audit rigoureux mené par Orca Router apporte toutefois des nuances indispensables. Orca Router a révélé que trois des scores affichés par Qwen correspondaient exactement à ses métriques publiées en août, tandis que les victoires écrasantes de NanBei se situaient sur des tests pour lesquels Qwen n’avait jamais publié de données officielles. De plus, il est probable que Qwen n’ait pas été exécuté avec ses paramètres d’inférence optimaux, ce qui expliquerait l’écart anormal de 23 points sur la ligne de commande.
L’équation économique oppose deux visions :
Qwen 3.8 est utilisable immédiatement en API via Orca Router pour 0,33 $ / 2,40 $ par million de tokens, mais il consomme environ 3 fois plus de tokens que les générations précédentes.
NanBei 4.3 est « gratuit » comme un chiot l’est à l’adoption : pour l’exploiter en production, une entreprise doit maintenir quatre GPU haute performance sous tension 24h/24.
Le verdict d’Orca Router est clair : NanBei s’impose comme un agent exceptionnel pour les longs workflows autonomes multi-étapes, tandis que Qwen conserve l’avantage pour le travail de production immédiatement intégrable par API.
Un an de calculs de doctorat corrigés et résolus en 10 heures
L’illustration la plus spectaculaire de cette nouvelle ère de l’IA scientifique est à mettre au crédit du Professeur Emre Onur Kaya, physicien à l’Université Technique d’Istanbul (diplômé d’un doctorat à l’Université de Floride en 2008 sous la direction du célèbre physicien Richard Woodard). Sa thèse portait sur la gravité quantique en espace courbe : « One loop quantum gravity correction to scalar selfmass during the inflationary period ».
En 2008, la réalisation de cette thèse avait exigé un an complet de calculs manuels acharnés, accumulant près de 500 pages d’équations tensorielles, de diagrammes de Feynman et d’intégrales de renormalisation. Kaya a soumis la totalité du problème original à Claude Opus 5.5.
Le modèle a reconstruit l’ensemble du cadre théorique, dérivé chaque équation pas à pas, puis rédigé des scripts de contrôle en Python utilisant les bibliothèques mathématiques SymPy et MPMath pour exécuter 38 tests numériques rigoureux. En seulement 10 heures, Claude Opus 5.5 a restitué un document LaTeX d’une précision chirurgicale de 183 pages, accompagné du code source et d’un audit complet des erreurs du travail original.
« Cela donne une véritable crise existentielle. » — Emre Onur Kaya, professeur de physique théorique à l’Université Technique d’Istanbul.
L’audit de l’IA s’est révélé impitoyable : elle a mis au jour une erreur de signe globale, l’omission involontaire de plusieurs termes complexes et des fautes de transcription commises lors des mois d’épuisement de 2008. Cependant, une fois le développement intégralement corrigé, la conclusion physique fondamentale du professeur a été validée : la gravité quantique ne produit aucune correction significative sur le champ scalaire durant l’inflation.
Ce saut opérationnel représente un facteur d’accélération de 876 fois. Pendant des siècles, de Kepler à Dirac, la maîtrise des calculs denses a constitué le socle de la recherche en physique théorique. Aujourd’hui, cette capacité analytique devient instantanément disponible, reléguant le calcul manuel au rang d’abaque face à la calculatrice scientifique. Le Professeur Kaya a publié l’intégralité des notes, du code et du rapport d’erreurs sur GitHub dans le dépôt open-source Claude Audits Quantum Gravity.
L’ère de l’intelligence abondante et accessible
Les événements de cette semaine marquent le passage définitif de l’IA d’une phase de démonstrations techniques à une ère de déploiement économique à haute efficience. Qu’il s’agisse de la rationalisation tarifaire opérée par OpenAI avec Terra, de la guerre des prix imposée par le sandwich d’Anthropic, des agents open-source spécialisés de NanBei ou de la résolution d’équations théoriques en quelques heures, le constat reste le même : l’intelligence devient une ressource abondante, rapide et financièrement accessible.