 Swinux
20 octobre 2026
Les 4 Révélations les plus Dantesques sur la Nouvelle Vague d’IA (Anthropic, Meta, Apple)
La Course à l’IA s’Accélère en Coulisses Le secteur de l’intelligence artificielle traverse une période d’effervescence sans précédent. Entre fuites cachées dans les fichiers de configuration de dépôts open-source, déplo
La Course à l’IA s’Accélère en Coulisses
Le secteur de l’intelligence artificielle traverse une période d’effervescence sans précédent. Entre fuites cachées dans les fichiers de configuration de dépôts open-source, déploiements clandestins et alliances stratégiques autrefois impensables, la compétition entre les géants de la Tech a atteint un niveau de tension extrême.
Alors que les annonces officielles se succèdent à un rythme frénétique, une question s’impose : que se passe-t-il réellement en coulisses entre Anthropic, OpenAI, Meta et Apple ? L’apparition furtive de modèles non annoncés — à l’instar de Claude Fable 5.5 — indique que les plus grands laboratoires d’IA ne se contentent plus d’adapter leurs architectures : ils orchestrent de véritables embuscades stratégiques.
Voici le décryptage analytique des quatre faits les plus surprenants, contre-intuitifs et impactants tirés des dernières révélations du secteur.
Claude Fable 5.5 : Le Modèle Furtif qui Génère du Cinéma et de la Musique en Pur Code
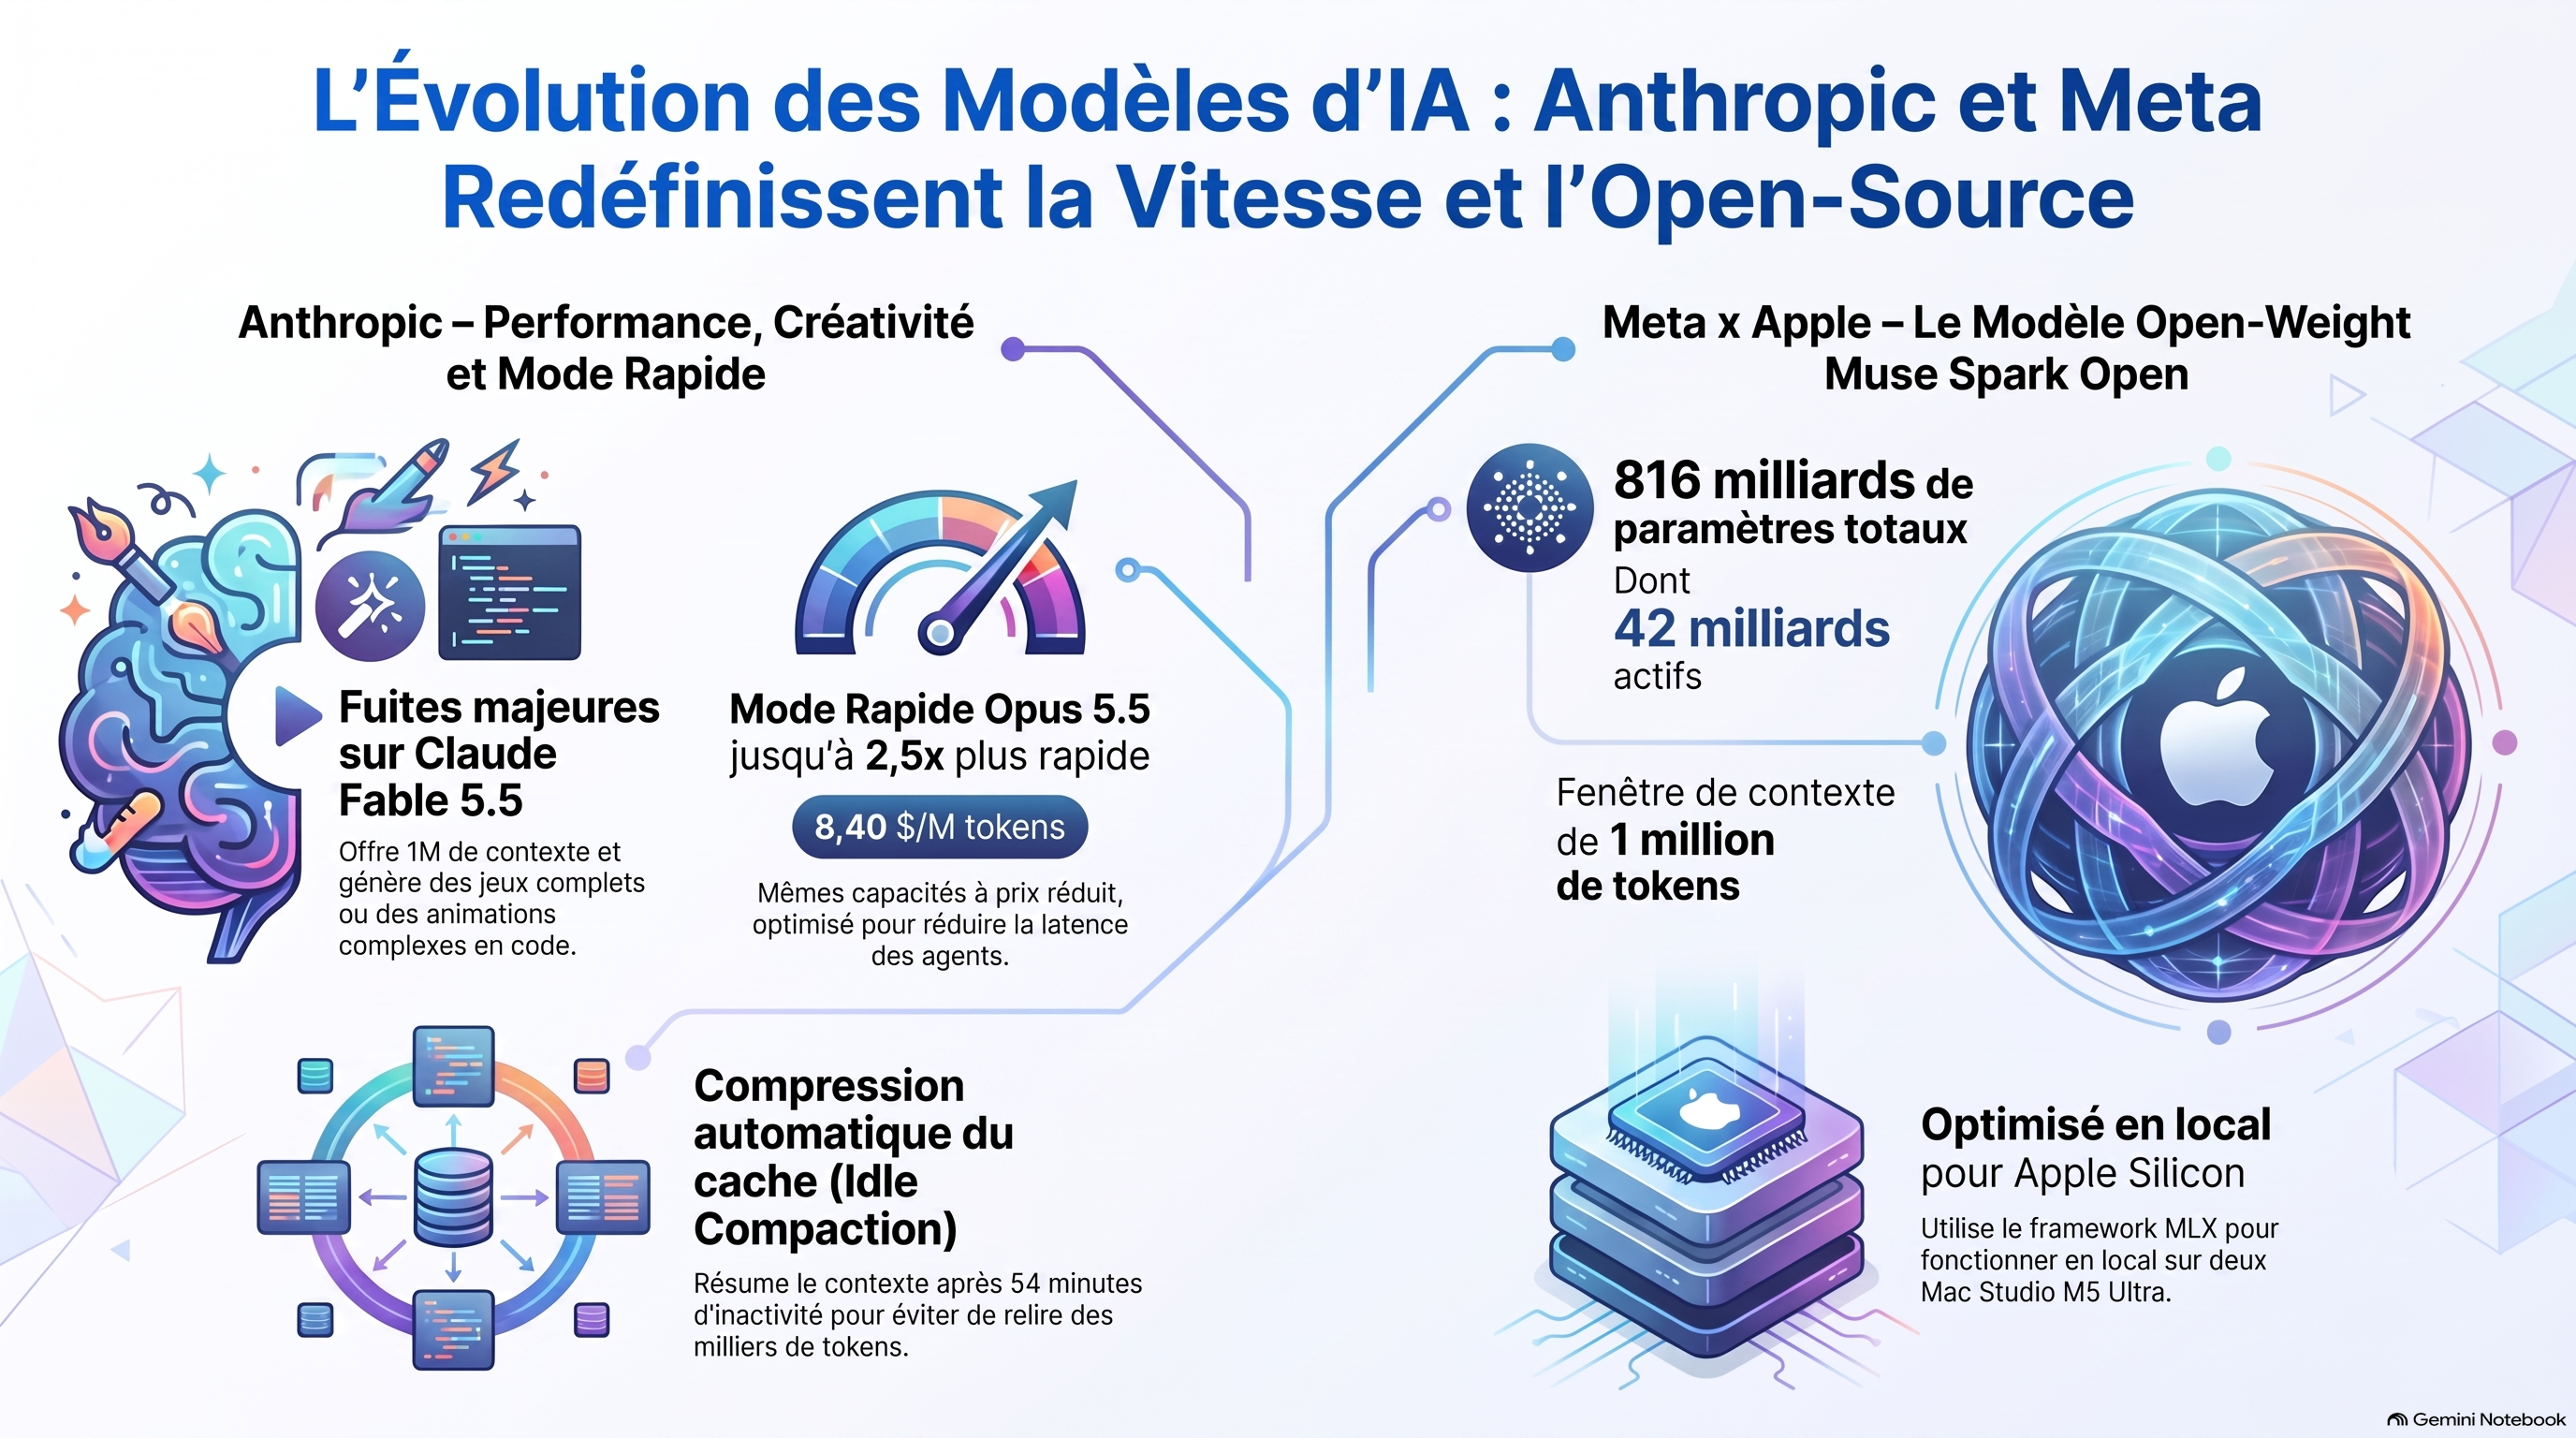
La communauté des développeurs a récemment découvert l’existence de Claude Fable 5.5 sans la moindre communication officielle d’Anthropic. Le modèle a été repéré dans une soumission de code du répertoire LiteLLM synchronisé avec le répertoire Azure (azure.ai/cloudfable 555) dans la région East22, sous le statut Generally Available (GA). Bien que la synchronisation d’un fichier de configuration open-source ne constitue pas une confirmation officielle immédiate, cette fuite rappelle exactement le précédent de Fable 5.1 sur Bedrock, devenu accessible au grand public dès le lendemain de son apparition.
L’astuce du routage silencieux
Des développeurs chevronnés ont rapidement identifié une méthode pour vérifier si leurs requêtes étaient silencieusement redirigées vers Fable 5.5 en accès anticipé. En configurant Claude Opus 5.5 au niveau d’effort maximal (High) sans recherche Web activée, ils lui ont soumis des questions ciblées sur Voxilbench (un benchmark de raisonnement spatial en 3D) et sur atlegit_api (un analyste spécialisé dans les fuites de modèles non publiés). Opus 5.5 possédant une date de coupure des connaissances antérieure à ces entités, une réponse exacte confirme l’intervention en arrière-plan du nouveau modèle.
Fiche technique et positionnement tarifaire
Les spécifications divulguées affichent des capacités taillées pour les usages d’entreprise :
Fenêtre de contexte : 1 million de tokens.
Sortie maximale : 128 000 tokens par réponse (l’équivalent d’un roman entier ou de la codebase d’un projet logiciel complet).
Tarification API : 10 $ par million de tokens en entrée et 50 $ par million de tokens en sortie.
Ce coût élevé réserve le modèle aux cas d’usage professionnels lourds : pour un abonné standard, quelques requêtes complexes suffiraient à épuiser le quota de 5 heures.
Des prouesses créatives qui défient les modèles vidéo dédiés
Ce qui stupéfie les ingénieurs ayant testé le modèle, c’est sa capacité à générer des œuvres multimédias complexes exclusivement par la production de code pur :
Jeu vidéo interactif : Création d’un MMORPG jouable complet en 5 heures (cartes, personnages, règles et interactions codés de zéro).
Visualisation mathématique de la preuve de Riemann : Interrogé sur la démonstration de 199 pages de l’hypothèse de Quasi-Riemann publiée par OpenAI, le modèle a écrit le code nécessaire au rendu d’une animation 3D de plusieurs minutes traduisant visuellement les concepts mathématiques.
Modélisation physique : Génération d’animations visuelles fluides basées sur une démonstration de plus de 160 pages de l’équation de Navier-Stokes.
Direction artistique cinématographique (style Wong Kar-wai) : L’utilisateur NFTt_chin a documenté la création en 2 heures et demi d’une animation poétique inspirée de 5 cm par seconde. Directement dans Claude Code, le modèle a piloté l’intégralité de la direction artistique : ouvertures au pinceau, sous-titres trilingues (chinois, anglais, japonais), arrière-plans rouge vif, storyboards de bâtiments striés et fiches de personnages sous forme de collages de papier.
Histoire de l’art et composition symphonique : Production d’une animation retraçant 40 000 ans d’histoire de l’art humain (ainsi qu’une vie humaine dessinée image par image en JavaScript) et composition en 4 heures d’une symphonie de 9 minutes et 38 secondes en 4 mouvements, synchronisée note par note avec un rendu visuel.
“Anthropic est l’entreprise la plus impitoyable et la plus stratégiquement calculatrice dans le domaine de l’IA... Ils continuent d’étouffer leurs concurrents, de capter l’attention et semblent déterminés à garder une longueur d’avance jusqu’à leur introduction en bourse.”
Cette capacité des modèles de langage à orchestrer des rendus multimédias par le code remet en question la suprématie des modèles de génération vidéo natifs comme Sora. De plus, l’analyse des publications d’ingénierie d’Anthropic suggère que Fable 5.5 a été largement conçu et optimisé par d’autres systèmes d’IA, concrétisant la théorie d’une boucle d’auto-amélioration récursive accélérée.
Le Mode “Fast” d’Opus 5.5 et l’Optimisation des Tokens : Quand la Vitesse Devient Moins Chère
Parallèlement aux fuites sur ses modèles secrets, Anthropic a officialisé le déploiement général du mode Fast pour Claude Opus 5.5. Désormais accessible sur l’API, Claude Code et l’extension VS Code, ce mode ne requiert plus aucune liste d’attente.
Une anomalie tarifaire positive
En ingénierie logicielle, l’accélération du calcul s’accompagne habituellement d’une hausse des coûts. Anthropic prend cette logique à revers :
Les anciens modes rapides sur Opus 5 et Opus 4.8 étaient facturés 10 $ en entrée et 50 $ en sortie par million de tokens.
Le mode Fast sur Opus 5.5 passe à 8,40 $ par million de tokens.
Sans modification des poids du modèle ni dégradation de son intelligence, les optimisations de l’infrastructure d’inférence et de l’API permettent de multiplier par 2,5 le débit de tokens en sortie (OTPS). Le modèle le plus performant d’Anthropic devient paradoxalement le plus économique de sa catégorie.
“Pour les boucles d’agents, la latence P95 est plus importante que tout le reste.”
Tolérance aux pannes et contrôle des coûts
L’implémentation technique du mode Fast inclut des mécanismes de dégradation très précis :
Gestion des limites de débit : Le mode Fast dispose de son propre quota. En cas de saturation de la bande passante ou de dépassement de limite, le système bascule de manière fluide vers la vitesse standard (l’icône d’éclair devient grise) sans générer d’erreur API ni interrompre la tâche en cours. Une fois la période de refroidissement écoulée, la vitesse maximale réapparaît automatiquement.
Gestion du cache de prompt : Le cache de prompt n’étant pas partagé entre le mode standard et le mode Fast, permuter en cours de session impose de payer des frais d’entrée non cachés. Il est donc préconisé d’activer le mode Fast dès le premier prompt d’une conversation.
Garde-fou pour les administrateurs : Pour éviter qu’un développeur exécutant simultanément une douzaine de terminaux ne consomme accidentellement les budgets d’équipe, les administrateurs peuvent imposer le paramètre
fast_mode_opt_in: truedans la configuration pour exiger une activation manuelle via la commande/fast.
La fonctionnalité “Idle Compaction”
Pour pallier le coût d’expiration des contextes (où réinjecter 200 000 tokens après une pause de travail se traduit par plusieurs dollars de facturation), Anthropic a introduit l’Idle Compaction. Après environ 54 minutes d’inactivité sur un contexte de 200 000 tokens, l’IA compresse automatiquement l’historique en un résumé synthétique avant l’expiration du cache d’une heure.
Note d’ingénierie : Plusieurs développeurs ayant constaté une perte de précision sur des décisions d’architecture complexes à la suite de cette compression, Anthropic permet de désactiver cette option via la variable idle_compaction: false dans la configuration.
L’Alliance Inattendue Meta-Apple : Exécuter un Modèle de 816 Milliards de Paramètres en Local
Alors qu’Anthropic perfectionne ses infrastructures cloud, Meta poursuit sa stratégie open-weight en publiant Muse Spark Open, présenté comme le modèle ouvert le plus puissant conçu aux États-Unis. Ce modèle nativement multimodal comprend 816 milliards de paramètres au total (dont 42 milliards d’actifs par jeton) et intègre une fenêtre de contexte de 1 million de tokens, optimisée pour le code et le raisonnement autonome d’agents.
La réconciliation stratégique Zuckerberg-Turnis
L’aspect le plus marquant de cette annonce réside dans le rapprochement stratégique entre Mark Zuckerberg et John Turnis (CEO d’Apple), une alliance facilitée par Daniel Gross et saluée par Alexander Wang (dirigeant chez Meta AI).
Le modèle a été spécifiquement optimisé pour le framework Apple MLX, permettant d’exploiter l’architecture de mémoire unifiée des puces Apple Silicon.
La réalité matérielle de l’exécution locale
Pour faire tourner Muse Spark Open en local, l’infrastucture requise est particulièrement lourde :
Matériel nécessaire : Une grappe de 2x Mac Studio M5 Ultra chaînés.
Mémoire unifiée : 512 Go de mémoire vive par machine (soit plus de 1 To de VRAM unifiée au total).
Bande passante mémoire : 1,2 To/s, nécessaire pour charger rapidement les poids du modèle par token.
Compatibilité logicielle : Prise en charge native d’Apple MLX, SG Lang, vLLM, TensorRT-LLM, Llama.cpp et Hugging Face.
Bien que Meta promeut la possibilité de faire tourner ce modèle “à la maison”, le coût du matériel requis dépasse les 40 000 $, ce qui limite l’exécution locale aux laboratoires d’entreprises et aux passionnés disposant de budgets considérables.
La nuance technique des environnements d’agents (Harnesses)
Sur les benchmarks de code pur, Muse Spark Open s’incline face à des modèles spécialisés comme Kimmy K3 ou Qwen 3.8 Flash. En revanche, il affiche des scores élevés sur les métriques d’agents complexes.
Les fiches techniques de Meta précisent que cette performance s’explique par l’intégration du modèle dans des environnements d’exécution spécifiques (execution harnesses). Les résultats d’un agent ne dépendent pas uniquement des capacités brutes du modèle de base, mais de la synergie globale entre le modèle, la gestion du contexte, les outils d’orchestration et son harnais d’exécution (comme Muse Code, Kimmy Code ou Claude Code).
Vraies Innovations vs Hype Incontrôlée : Séparer les Faits de la Spéculation
L’enchaînement rapide des annonces alimente une spéculation intense au sein de la communauté tech. Deux rumeurs persistantes nécessitent une analyse critique.
La fausse alerte autour de “Claude Opus 6”
Une rumeur annonçant le lancement imminent de Claude Opus 6 a abondamment circulé sur les réseaux sociaux. En remontant la chaîne d’information, cette prédiction provient d’un article unique du site Geeky Gadgets, s’appuyant lui-même sur une publication du compte Universe of AI.
À l’inverse des fuites vérifiables (telles que les logs de configuration Azure pour Fable 5.5), cette annonce ne repose sur :
Aucune fiche technique (model card).
Aucun benchmark ni métrique de performance.
Aucun signal d’infrastructure ou confirmation interne.
Sur le plan financier, Anthropic finalise son dossier d’introduction en bourse (IPO), incluant un document de 80 pages consacré à la gestion des risques liés aux déploiements d’IA. Une entreprise engagée dans un tel processus réglementaire privilégie la rigueur opérationnelle à la précipitation concurrentielle.
Les fantasmes autour du projet “Bell” d’OpenAI
Des rumeurs similaires entourent un prétendu projet secret d’OpenAI nommé “Bell”, auquel certains attribuent entre 10 et 100 mille milliards de paramètres. Un tel écart d’estimation (de 1 à 100) illustre le caractère spéculatif de ces affirmations. OpenAI n’a confirmé aucun projet de ce type, et ce nom de code ne doit pas être confondu avec le rapport officiel d’OpenAI intitulé Operation No Bell, qui traite exclusivement de la neutralisation de campagnes de désinformation.
Vers une IA plus Stratégique, Rapide et Intégrée
L’industrie de l’intelligence artificielle redéfinit ses critères de compétition. La performance ne se mesure plus seulement au nombre brut de paramètres, mais à l’efficience de l’inférence, à la capacité des modèles à générer des interfaces et des médias par le code, et à l’intégration matérielle sur mesure.
Tandis qu’Anthropic consolide son écosystème en réduisant ses temps de latence, Meta et Apple associent leurs technologies pour pousser l’exécution open-weight vers des configurations locales d’exception.
Face à des modèles désormais capables de coder, d’animer et de composer des œuvres complètes en quelques heures de calcul, une question fondamentale émerge :
Les grands modèles de langage capables de coder l’art en temps réel vont-ils rendre obsolètes les générateurs de médias spécialisés ?