 Swinux
23 octobre 2026
L’Ère de l’IA Intuitive et Ultra-Rapide : Comment les Modèles Flash et la Diffusion Redéfinissent le Futur du Code
1. Introduction : Le grand saut vers l’IA intuitive et ultra-rapide Pendant des années, le quotidien des développeurs et des utilisateurs d’intelligence artificielle a ressemblé à un micro-management fastidieux. Face à u
1. Introduction : Le grand saut vers l’IA intuitive et ultra-rapide
Pendant des années, le quotidien des développeurs et des utilisateurs d’intelligence artificielle a ressemblé à un micro-management fastidieux. Face à un bogue au sein d’une base de code complexe, la routine restait invariablement mécanique : corriger l’erreur immédiate, vérifier manuellement si d’autres modules souffraient de la même faille, puis rédiger soi-même des tests de régression. Guider un modèle exigeait de lui dicter chaque étape intermédiaire, tout en subissant des temps de réponse ralentis et des coûts d’inférence prohibitifs imposés par les modèles phares (flagships).
Ce paradigme est en train de s’effondrer. Une nouvelle génération d’architectures émerge : des modèles qui ne se contentent plus d’exécuter passivement des instructions explicites, mais qui apprennent à anticiper l’intention réelle de l’utilisateur. En parallèle, l’effondrement des coûts d’inférence et l’atteinte de vitesses de génération supérieures à 1 000 tokens par seconde bousculent l’industrie. Nous assistons à une transition fondamentale : le passage d’une IA réactive générant du texte au kilomètre à une autonomie agentique véritable, portée par une quête d’efficacité et de vitesse pure.
2. Takeaway 1 : L’IA acquiert une “intuition” et apprend à lire entre les lignes
Le modèle mystère d’Anthropic : quand l’IA anticipe vos intentions au-delà du code
Selon des informations divulguées par le média The Information, relayées sur X par Kimismas et reprises par des publications spécialisées comme Machine Heart, Anthropic s’apprêterait à lancer un modèle non publié doté de capacités de raisonnement et de jugement intuitif inédites. Bien qu’aucun nom officiel, benchmark validé ou date de sortie n’ait encore été formalisé par le laboratoire californien, les spéculations de la communauté désignent informellement ce modèle sous les noms de Claude Fable 5.5 ou Opus 5.6.
D’après le retour d’expérience d’un testeur privilégié ayant eu accès au système, le modèle se distingue par une faculté singulière à appréhender l’implicite :
“Le modèle excelle à déceler ce que vous n’avez pas dit. Vous lui fournissez des informations limitées sans objectif final clair, et il parvient malgré tout à déterminer ce que vous cherchez réellement pour proposer une solution plus profonde que celle demandée.”
Pour illustrer cette capacité à lire entre les lignes, le testeur met en avant deux cas d’usage caractéristiques :
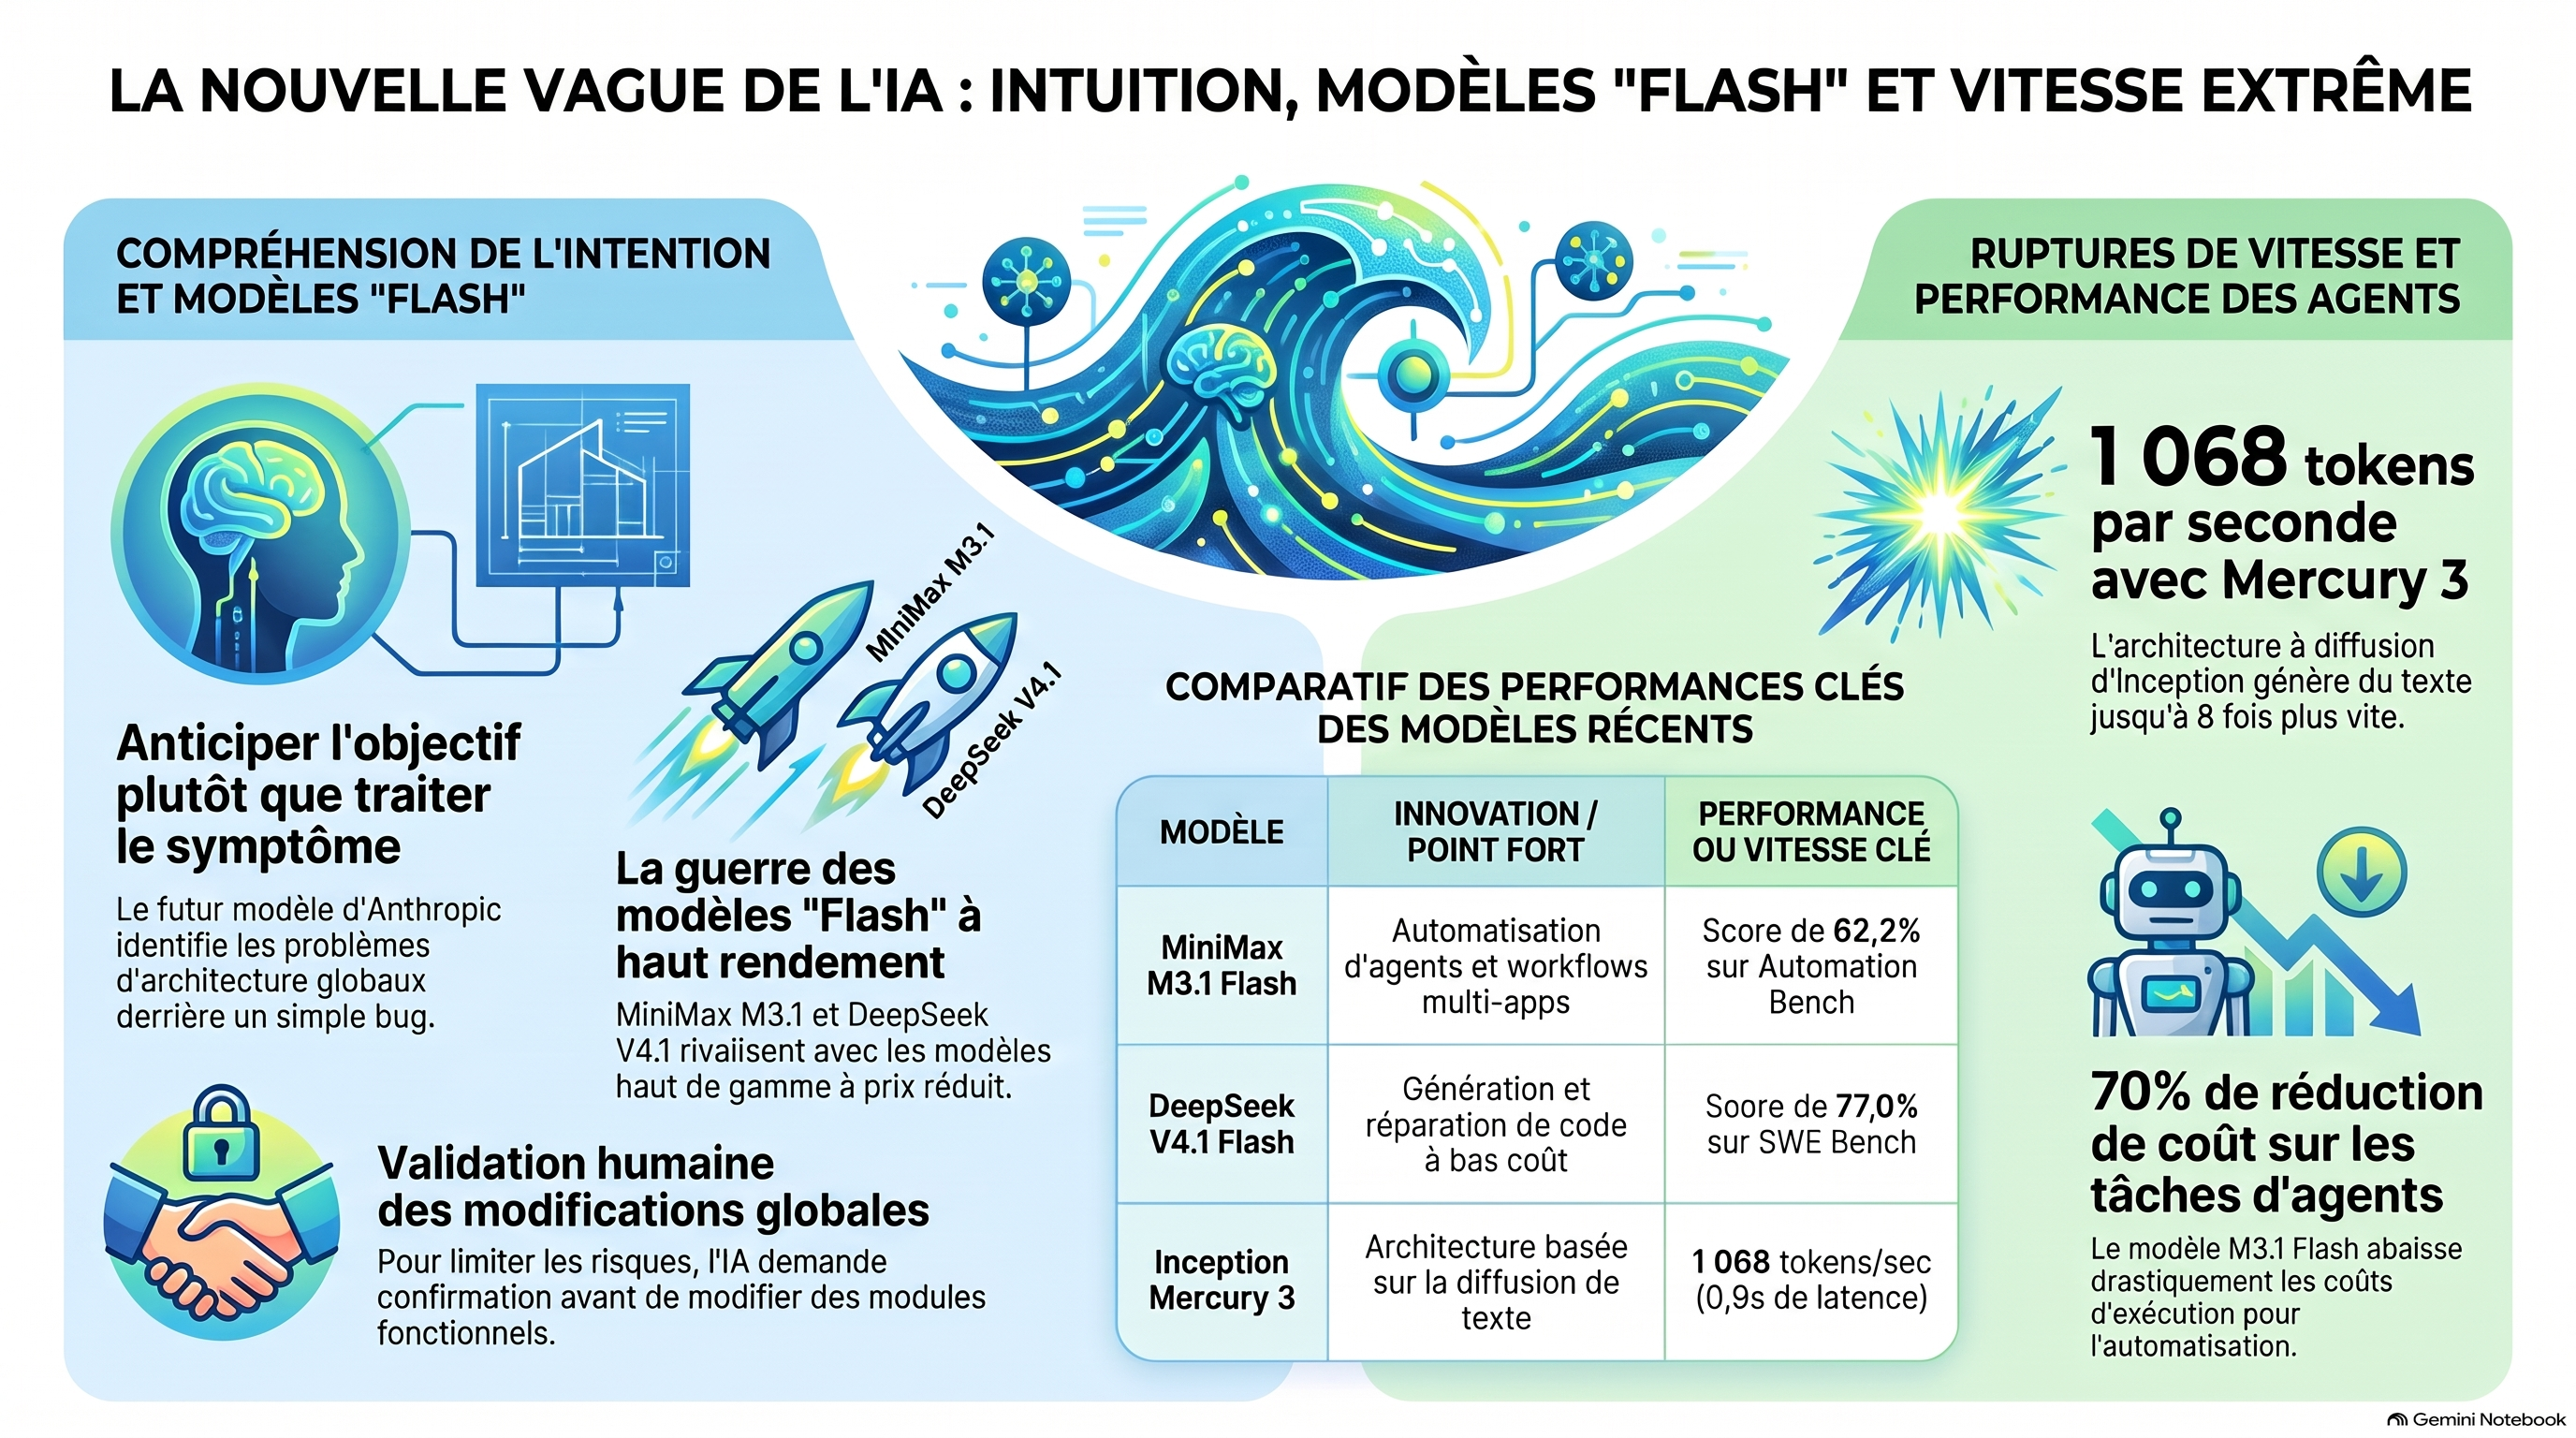
Résolution de bogues systémiques : Face à un bogue isolé dans une base de code, le modèle ne se limite pas à patcher la ligne défectueuse. Il remonte la chaîne de dépendances, identifie toute une catégorie de problèmes architecturaux sous-jacents disséminés dans plusieurs modules et interroge directement l’utilisateur : “Hé, veux-tu que je corrige tout cela ensemble ?”
Analyse financière prospective : Interrogé sur des stratégies d’investissement, le modèle ne se contente pas d’aligner des ratios cours/bénéfices ou des généralités académiques ; il formule de nouveaux algorithmes créatifs conçus pour tenter de prédire la performance future des actions.
Cette capacité à déduire l’objectif global constitue un saut qualitatif majeur pour les tâches agentiques complexes, où l’humain doit définir le résultat souhaité plutôt que chaque instruction étape par étape. Toutefois, cette proactivité comporte un risque de sur-interprétation : dans une situation de crise en production, un développeur a parfois besoin d’appliquer un correctif d’urgence sans risquer de réécrire des pans entiers de code fonctionnel. La véritable valeur stratégique pour Anthropic ne résidera donc pas seulement dans la justesse de ses intuitions, mais dans sa capacité à juger du périmètre d’action et à solliciter une confirmation humaine avant toute modification critique.
3. Takeaway 2 : La guerre des modèles “Flash” et l’ère du “Wish-Based Programming”
DeepSeek V4.1 contre MiniMax M3.1 Flash : la bataille des modèles économiques
Une compétition technologique et tarifaire d’une rare intensité s’est ouverte. En l’espace de 48 heures, deux modèles d’une efficacité redoutable ont fait leur apparition : DeepSeek V4.1 Flash (lancé le 17 octobre) et MiniMax M3.1 Flash (revendiqué le 19 octobre). Le média spécialisé chinois Jidongji a qualifié la sortie de DeepSeek d’événement “renversant la table”, inaugurant ce qu’il nomme l’ère du “wish-based programming” (la programmation par le souhait). Ce concept marque l’évolution de la prompt engineering : le développeur ne détaille plus le déroulement technique d’un programme, mais exprime un souhait de haut niveau, déléguant au modèle Flash l’analyse des dépendances, la modification multi-fichiers et l’automatisation inter-applications à un coût négligeable.
Avant même son officialisation, MiniMax avait suscité un fort engouement sous le nom de code confidentiel Space Bunny. En quelques jours, Space Bunny s’est hissé à la 2ᵉ place du classement d’utilisation d’Open Code et a brièvement occupé la 1ʳᵉ place sur Open Router. Lors de tests communautaires, soumis à un exercice complexe de création d’une scène spatiale de lancement de fusée en 3D sous un niveau de réflexion maximal, le modèle a généré un résultat rivalisant avec Claude Opus 5 en seulement 3 minutes.
Les architectures techniques et la structure des coûts de ces deux rivaux illustrent parfaitement la maîtrise de l’optimisation :
DeepSeek V4.1 Flash : Repose sur une architecture éparse de type Mixture-of-Experts (MoE) totalisant 552 milliards de paramètres, mais n’en active de manière ciblée que 8 milliards en entrée et 16 milliards en sortie lors de l’inférence. Il surpasse ainsi l’ancien modèle Pro de DeepSeek tout en maintenant des coûts de calcul minimes.
MiniMax M3.1 Flash : Embarque une fenêtre de contexte de 1 million de tokens, affiche une vitesse de génération supérieure à 200 tokens par seconde (avec une médiane P50 maintenue au-dessus de 170 tokens/s) et réduit de 70 % les coûts sur les workflows agentiques par rapport à la génération précédente.
Grille tarifaire agressive : MiniMax facture 1 yuan par million de tokens en entrée, 4 yuan en sortie et 0,1 yuan pour la lecture du cache. De son côté, DeepSeek propose en heures creuses des tarifs de 0,02 yuan (cache hit), 1 yuan (cache miss) et 4 yuan en sortie (les tarifs doublant durant les heures de pointe à 0,04 / 2 / 8 yuan). Les tarifs standard de MiniMax s’alignent ainsi sur les heures creuses de DeepSeek et divisent par deux ses tarifs de pointe.
Sur le terrain des benchmarks, MiniMax M3.1 Flash s’impose comme une référence de premier plan :
Agents Last Exam : Score de 29,6 % (pour un coût d’exécution de 739 yuan), s’installant au sommet du ratio coût/performance sur des tâches agentiques réelles et complexes.
Automation Bench v1.0.6 : Score de 62,2 sur l’automatisation d’entreprises (devançant DeepSeek à 60,5 et surpassant Opus 5).
SWE Refor (réparation de code) : Score de 23,0 (plus du double du score affiché par DeepSeek).
DeepSWE v1.1 : DeepSeek conserve un léger avantage avec 77,0 contre 73,7 pour MiniMax (qui reste à seulement 0,3 point d’Opus 5).
Autres épreuves : Score de 76,2 sur Banker Tool Bench (égalité avec Opus 5), 82.2 sur Cyberjim, et 43,4 sur HLE sans outils (dépassant DeepSeek, Kimi K3 et GLM 5.3).
Ces modèles démontrent qu’il n’est plus nécessaire d’engager des budgets colossaux sur des modèles phares pour obtenir des performances de niveau professionnel sur le code et l’automatisation agentique.
4. Takeaway 3 : La révolution de la diffusion de texte – La barre des 1 000 tokens par seconde franchie
Mercury 3 d’Inception : la rupture technologique des modèles non-autorégressifs
Le 19 octobre, Inception a franchi un cap technologique majeur en lançant Mercury 3, son nouveau modèle basé sur une architecture de diffusion de texte, marquant une rupture nette avec le paradigme autorégressif traditionnel.
Là où les modèles autorégressifs génèrent le texte de façon séquentielle token par token — créant des goulets d’étranglement de latence et d’attente du premier token (Time-To-First-Token / TTFT) —, la diffusion de texte traite et affine la séquence de manière non-autorégressive. Ce changement de paradigme permet de faire sauter le plafond de vitesse d’inférence :
Vitesse inédite : Mercury 3 atteint une vitesse de génération de 1 068 tokens par seconde sur GPU NVIDIA, couplée à une fenêtre de contexte de 1 million de tokens (contre 260 000 tokens sur Mercury 2.5).
Performance comparative : Il s’exécute 4 à 8 fois plus vite que les modèles autorégressifs équivalents. Inception affirme que Mercury 3 surpasse GPT 6 Luna et Claude Haiku 5.5 sur l’ensemble des benchmarks standard. Sur 50 tâches de navigation web complexes du benchmark Live Mind 2, Mercury 3 en a validé la moitié (25/50), devançant GPT 6.1 Soul à nombre de tokens strictement identique.
Validation des lois d’échelle : Intégrant 40 fois plus de paramètres que Mercury 1 et enregistrant des gains de performance triplés par rapport à Mercury 1 Mini, le modèle prouve empiriquement que les lois d’échelle (scaling laws) s’appliquent avec la même rigueur à la diffusion de texte qu’aux modèles autorégressifs.
Dans des cas d’usage réels, des intégrateurs comme le concepteur de lunettes intelligentes Octen AI mesurent une latence médiane de génération sous la seconde (0,9 seconde). Inception accompagne ce lancement d’une tarification promotionnelle réduite de 50 % (0,10 $ par million de tokens en entrée, 0,35 $ en sortie, et 0,01 $ pour le cache), tout en offrant 100 millions de tokens gratuits sans carte bancaire à l’inscription. Le modèle est déployé sur l’API propriétaire d’Inception, Open Router, Base 10 et Vercel (compatible API OpenAI). Parallèlement, Inception a fermé l’accès aux versions Mercury 2 et 2.5 pour les nouveaux utilisateurs, garantissant le maintien du service pour les comptes existants jusqu’au 15 novembre 2026.
L’accès à une génération instantanée dépasse le simple confort : il rend viable l’intégration de l’IA dans des équipements matériels aux contraintes temporelles strictes, tels que les assistants vocaux interactifs et les lunettes connectées.
5. Takeaway 4 : L’arbitrage coût-performance – L’essor des modèles intermédiaires et spécialisés
Les stratégies de Google et OpenAI pour verrouiller le marché entreprise
Pendant que des laboratoires spécialisés franchissent des seuils de vitesse extrêmes via la diffusion, les géants historiques du secteur réarchitecturent leurs gammes intermédiaires. L’enjeu est stratégique : éviter l’évasion de leurs clients entreprises vers des alternatives ultra-économiques lors de l’exécution de millions d’appels API quotidiens.
Google Gemini : Après un déploiement restreint auprès d’experts en cybersécurité, Google a ouvert mondialement le 14 octobre son modèle Gemini 4 Argon aux développeurs et entreprises. Ciblant le codage, la finance, le droit, la cybersécurité et la recherche scientifique, il affiche une supériorité marquée dans la compréhension visuelle et l’analyse vidéo. Selon des analyses publiées par The Information, la puissance de Gemini 4 Argon sur la vidéo s’expliquerait par l’exploitation de l’immense réservoir de données de YouTube — une hypothèse persistante parmi les analystes tech, bien qu’aucun lien de causalité n’ait été officiellement confirmé par Google. L’entreprise développe déjà l’étape suivante sous le nom de code Gemini 4 Carbon.
OpenAI : La firme prépare le lancement d’une nouvelle déclinaison au sein de sa série Terra (positionnée sur le créneau intermédiaire entre Soul et Luna). L’objectif de la gamme Terra est de fournir un gain de performance substantiel par rapport aux modèles légers tout en maintenant un coût d’inférence nettement inférieur à celui de GPT 6.1 Soul.
Développement d’architectures lourdes chez OpenAI : En parallèle de la gamme Terra, OpenAI travaille sur un modèle de capacité supérieure basé sur une technologie de transformateur récurrent (recurrent transformer technology). Ce système fait actuellement l’objet d’évaluations poussées en matière de sécurité et de gestion des risques pour parer à tout dysfonctionnement majeur post-déploiement.
Pour les acteurs industriels, la sélection d’un modèle ne se résume plus à la recherche de la puissance brute. L’arbitrage s’oriente désormais vers des modèles “suffisamment performants, ultra-rapides et économiquement soutenables”, garantissant la viabilité financière de leurs applications à grande échelle.
6. Conclusion : Vers une IA invisible, instantanée et proactive
L’écosystème de l’intelligence artificielle opère une mutation structurelle profonde, articulée autour de trois axes fondamentaux :
La compréhension implicite : L’émergence de modèles capables de saisir l’intention sous-jacente d’un projet sans nécessiter une formulation pas à pas.
L’effondrement de la latence et des coûts : L’essor conjoint des modèles Flash hautement optimisés et de la diffusion de texte affichant plus de 1 000 tokens/seconde.
La diversification architecturale : Le passage d’un paradigme monolithique à un écosystème hybride combinant Mixture-of-Experts (MoE) éparses, transformateurs récurrents, modèles de diffusion et gammes intermédiaires adaptées à chaque enveloppe budgétaire.
L’IA s’efface progressivement en tant qu’outil de saisie textuelle pour devenir une infrastructure proactive, instantanée et financièrement accessible.