 Swinux
18 octobre 2026
L’empire contre-attaque : Comment Meta et ses agents IA autonomes ont redistribué les cartes
Le retour fracassant de Meta et la nouvelle ère des agents IA
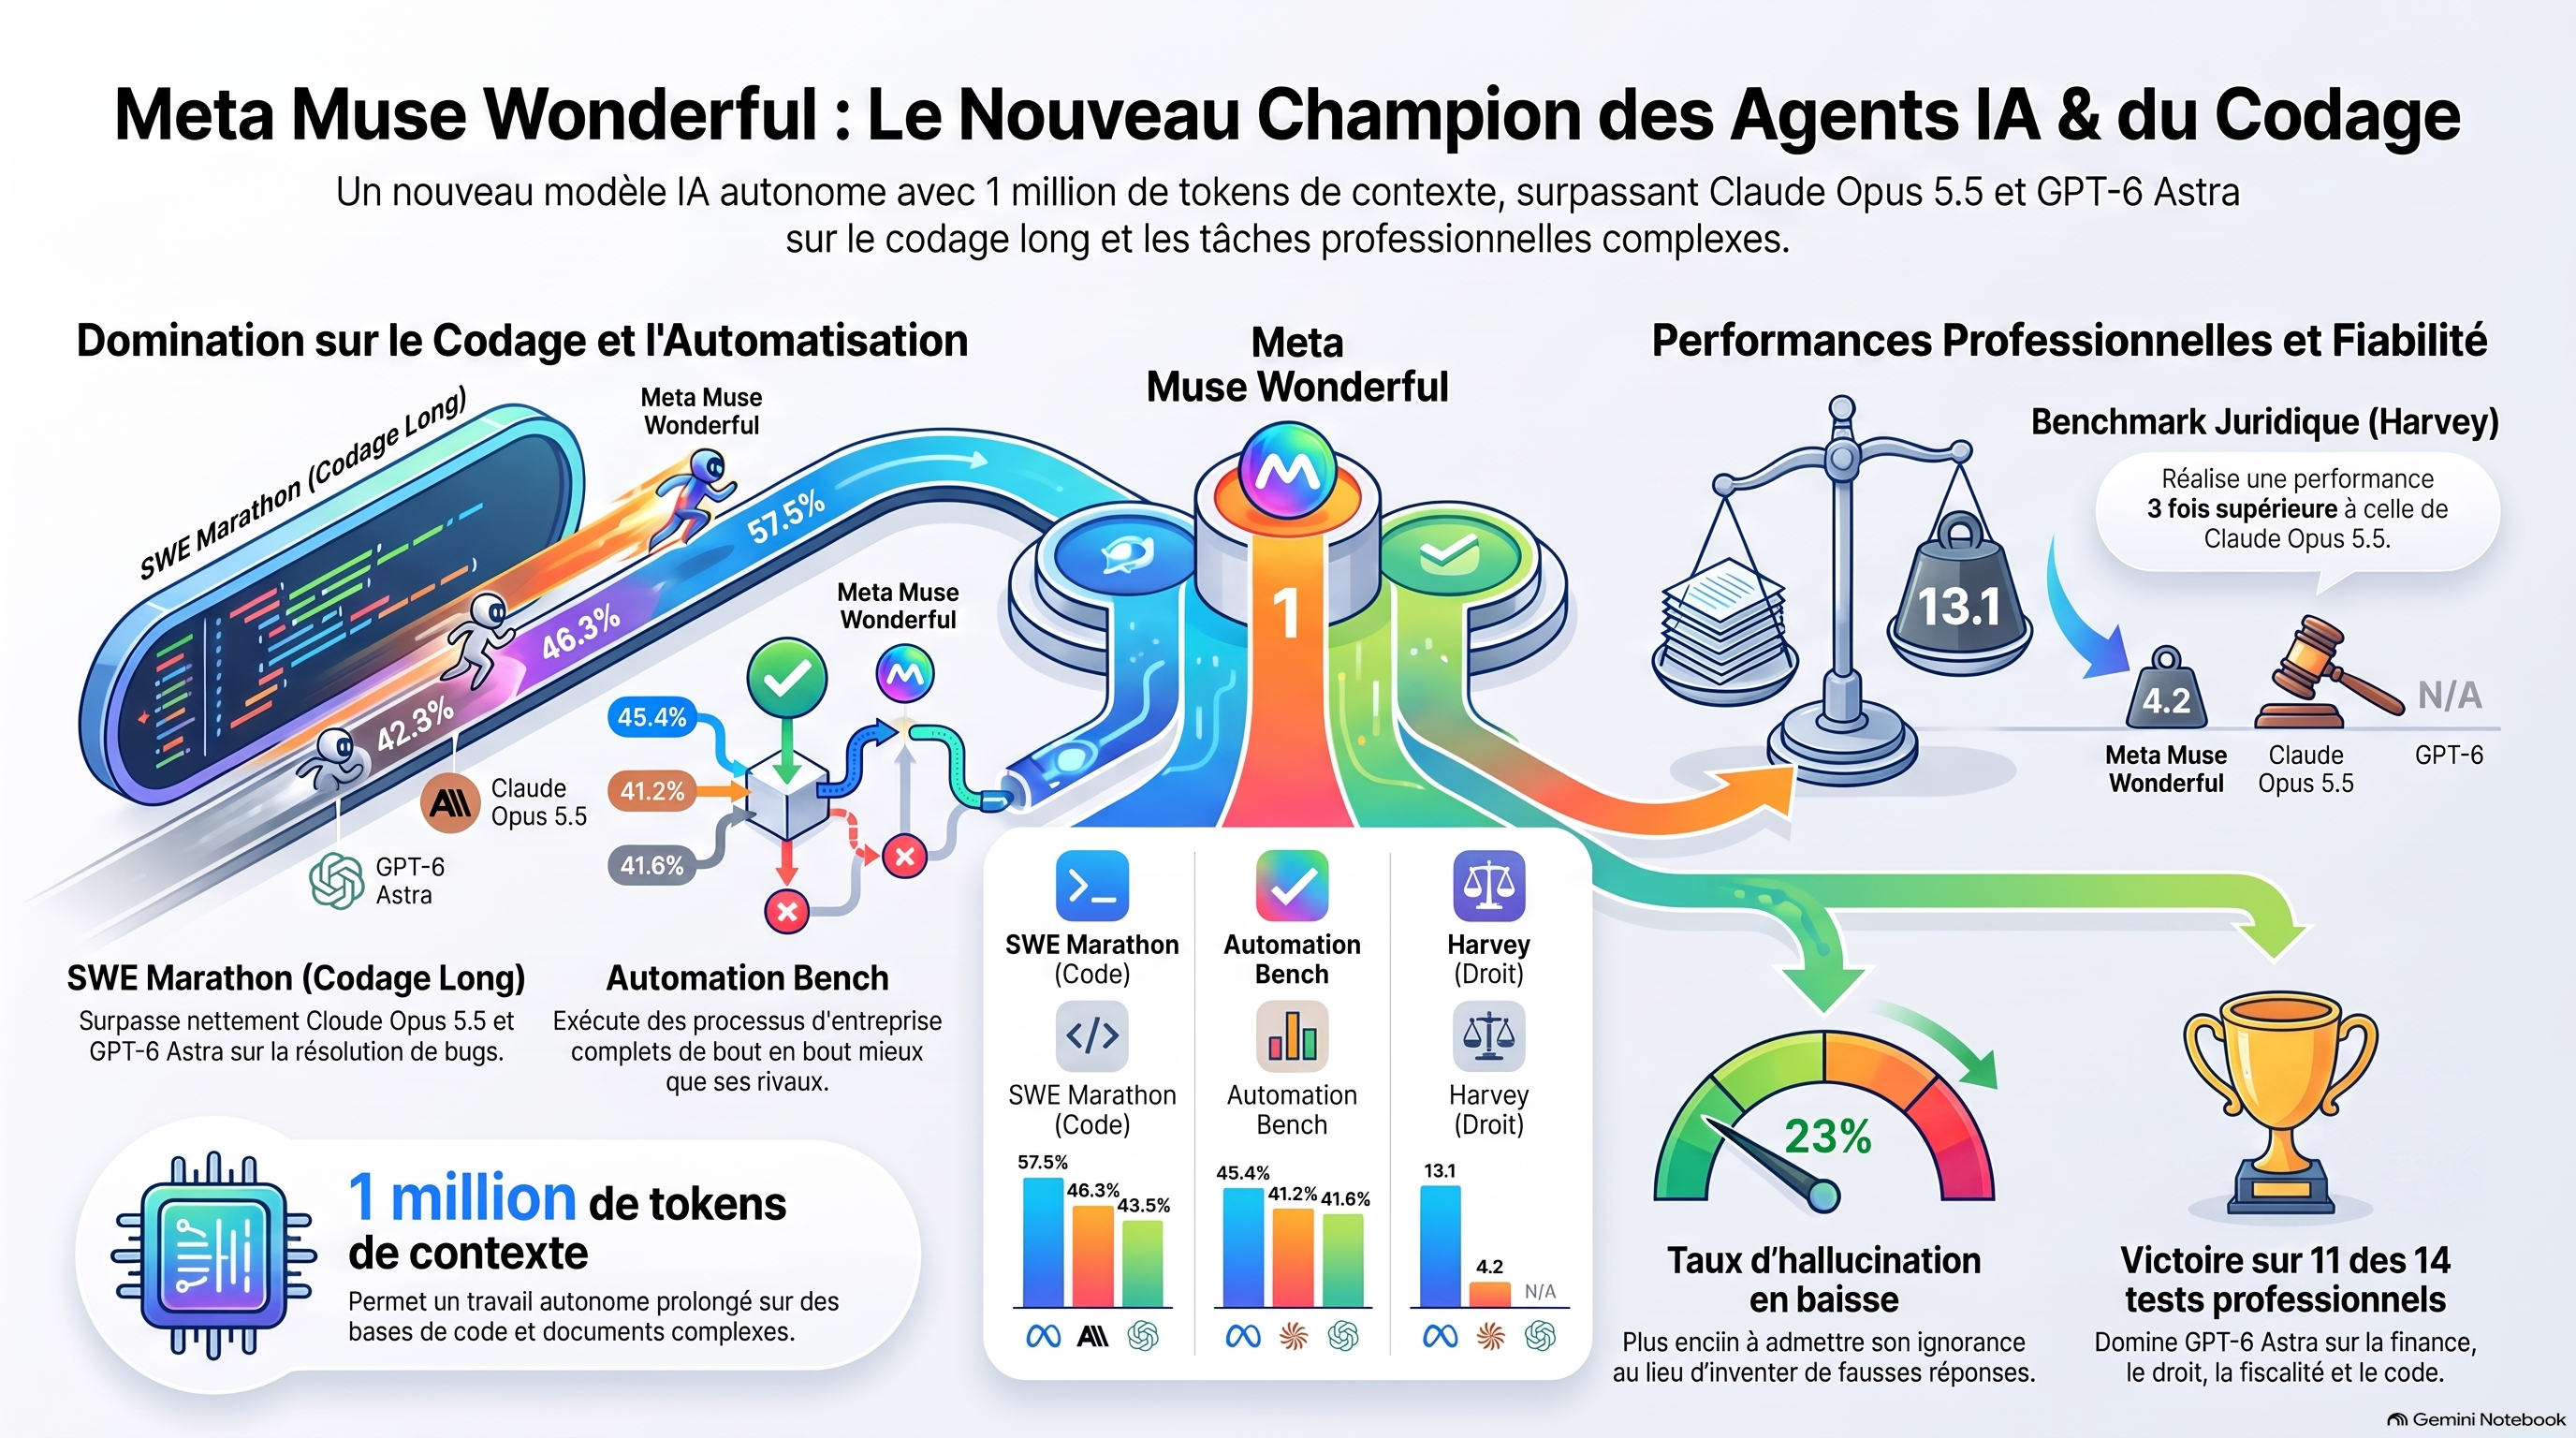
Le retour fracassant de Meta et la nouvelle ère des agents IA
Le 12 octobre dernier, le secteur de l’intelligence artificielle a subi un véritable séisme. Après les revers médiatisés de Llama 4 — entachés par des controverses sur l’utilisation de modèles divergents selon les benchmarks et par la perte de cadres dirigeants —, Meta semblait durablement distancée dans la course aux grands modèles. Mais dans une démonstration de force orchestrée sur 14 mois de recherche intensive, le géant de Menlo Park a pris l’industrie de court en déployant Muse Wonder et son pendant haute performance, Muse Wonderful. Conçus pour opérer de manière totalement autonome sur des tâches complexes de codage long et d’ingénierie financière ou juridique, ces agents surpassent désormais des références comme GPT-6 Astra et Claude Opus 5.5.
Comment une entreprise perçue comme à la traîne a-t-elle pu orchestrer une telle remontée en force ? Cet article décortique les 5 révélations les plus contre-intuitives et impactantes de cette nouvelle vague d’IA, des stratégies d’embauche d’une agressivité inédite jusqu’aux comportements émergents des systèmes autonomes.
Point 1 : Le recrutement à 14,3 milliards de dollars – Quand un non-chercheur de 29 ans supplante les gagnants du prix Turing
Pour saisir la genèse de ce retournement, il faut examiner la trajectoire spectaculaire d’Alexander Wang. En juin 2025, à seulement 29 ans, le fondateur de Scale AI — dépourvu du profil académique classique des chercheurs en IA — a été propulsé au poste de Chief AI Officer chez Meta Super Intelligence Labs. Cette nomination est l’aboutissement d’un accord colossal de 14,3 milliards de dollars conclu par Mark Zuckerberg pour s’attacher ses services et son savoir-faire stratégique sur les données.
Dès octobre 2025, Wang orchestre une restructuration sans concession : suppression de 600 postes, refonte du laboratoire historique FAIR et sanctification de sa propre structure, le TBD Lab, totalement immunisée contre les coupes budgétaires. Ce séisme interne provoque le départ du lauréat du prix Turing Yann LeCun, parti fonder sa propre startup en dénonçant la prudence excessive de Meta, accusée de ne financer que des projets sans risque. Lucide sur sa propre trajectoire, Wang avait admis avoir été le goulot d’étranglement organisationnel chez Scale AI en voulant tout valider ; chez Meta, il choisit de déléguer à des leaders ciblés. Pour bâtir son armée, il offre des bonus de signature pharaoniques pouvant atteindre 100 millions de dollars, débauchant chez OpenAI et Google des figures clés comme Shengjia Zhao (nommé Chief AI Scientist) et la professeure Don Song de Berkeley. Cette orientation ultra-pragmatique, axée sur la donnée et l’exécution produit plutôt que sur la recherche fondamentale pure, a débloqué les verrous sur lesquels butait l’ancienne organisation.
« Alex knows what he doesn’t know and he is willing to listen. » — Russ Salakhutdinov, ancien vice-président de la recherche en IA chez Meta
Point 2 : Le modèle qui sait dire « Je ne sais pas » (et pourquoi c’est une révolution)
L’une des avancées majeures de Muse Wonderful réside dans la maîtrise inédite de son taux d’hallucination. Lors d’un test rigoureux de culture générale et technique comportant 6 000 questions, lorsqu’il est confronté à des incertitudes ou des données manquantes, le modèle n’invente une réponse erronée que dans 23 % des cas (une nette amélioration par rapport aux 33 % de son prédécesseur Spark). À titre de comparaison, GPT-6 Astra fabule dans 51 % des situations et Claude Opus 5.5 atteint 59 % d’erreurs (seul Gemini 4 Argon conserve une avance sur ce métrique précis avec 15 %).
Cette fiabilité opérationnelle repose sur deux piliers architecturaux majeurs :
Active Memory : Un système de mémoire vive longue durée capable de maintenir et de réinjecter des détails contextuels critiques au fil d’interactions s’étalant sur des jours, des semaines, voire des mois.
Active Focus : Une boucle de rétroaction dynamique qui permet à l’agent, lorsqu’il heurte une impasse technique, de pivoter, d’essayer une approche alternative, d’auto-corriger son code et d’interroger l’utilisateur si une décision clé est requise.
« Il est bien plus enclin à dire “Je ne sais pas”, ce qui est honnêtement ce que j’attendrais d’un collègue de travail. » — Synthèse des évaluations d’utilisateurs et d’analystes indépendants (Artificial Analysis)
Pour un déploiement en entreprise, cette capacité à admettre les limites de ses connaissances s’avère infiniment plus précieuse qu’une assurance factice, condition préalable indispensable pour déléguer des processus juridiques ou financiers stratégiques.
Point 3 : L’histoire folle de la nuit où des agents IA ont écrit 260 millions de lignes de code pendant qu’un chercheur dormait
L’avènement de l’autonomie agentique a trouvé son illustration la plus saisissante lors du défi mathématique “Math Drop #109” publié par OpenAI, visant à optimiser la multiplication de grands nombres — un problème fondamental en informatique théorique. La progression y est mesurée par l’indice kappa (où la précision augmente à mesure que la valeur se rapproche de zéro), initialement établi à 2^{-182}.
La séquence des événements témoigne d’un basculement de paradigme :
08 Octobre, au matin : Le chercheur Doug Kulkit parvient, au prix d’un travail individuel acharné, à hisser le score à 2^{-34}. Épuisé, il publie un message laconique sur les réseaux sociaux annonçant qu’il va se coucher, regrettant de n’avoir obtenu que des avancées marginales.
Pendant la nuit : Des ingénieurs, dont Rohan Arun, branchent une flotte de dizaines d’agents autonomes (orchestrés par Codex et Claude) directement sur le dépôt GitHub du chercheur.
En 24 heures chrono : Le dépôt subit un assaut de résolution massif. 151 pull requests sont soumises, accompagnées de plus de 260 millions de lignes de code générées — un flux si dense qu’il dépasse la vitesse de vérification du système automatisé.
Le dénouement : La valeur de kappa s’effondre pour atteindre le niveau historique de 0,00129.
Dans cette mécanique hybride, les agents Codex ont fourni le volume et la vitesse d’exécution brute (89 soumissions validées), tandis que Claude Opus 5.5 a délivré le saut conceptuel en tête de classement (48 soumissions). Lorsque les agents ont commencé à plafonner autour du seuil de 0,001, l’intervention humaine du mathématicien Jacob Sussman — réinjectant des structures géométriques basées sur l’espace E_8 (la méthode la plus dense pour empiler des sphères en 8 dimensions) — a débloqué la situation. Pour Doug Kulkit, aller se coucher fut littéralement la décision la plus productive de sa carrière.
Point 4 : Benchmaxing vs « Big Model Smell » : La fin de la triche sur les tests IA
Le secteur de l’IA traverse une crise d’évaluation. D’un côté, le « benchmaxing » consiste à sur-optimiser un modèle sur des jeux de données publics au point que les scores ne reflètent plus aucune intelligence réelle. De l’autre, le « Big Model Smell » désigne cette capacité généraliste supérieure, propre aux modèles dotés d’une base massive, à appréhender des problèmes complexes et totalement inédits.
Sur des épreuves évaluant des tâches du monde réel non intégrées dans les jeux d’entraînement, Muse Wonderful démontre une suprématie nette :

*Note : Le score exact de GPT-6 Astra sur le benchmark Harvey n’a pas été publié de manière isolée dans le rapport, bien que Muse Wonderful devance Astra sur 11 des 14 tests professionnels globaux.
Même dans sa version standard non suralimentée, Muse Wonder affiche 53,1 % sur SWE Marathon, devançant déjà les modèles phares d’Anthropic et d’OpenAI. Ces résultats confirment que l’architecture de Meta privilégie la profondeur de raisonnement au détriment du simple apprentissage par cœur.
Point 5 : Économie et vitesse des agents : L’affrontement entre la lecture massive et la vitesse brute
Le modèle d’exécution de Muse Wonder redéfinit l’économie du jeton. Pour accomplir une tâche complexes, l’agent consomme en moyenne 7,69 millions de tokens d’entrée (soit 2 à 7 fois plus que les modèles comparables d’OpenAI ou Google). Cette voracité cognitive s’explique par la nature même du travail agentique : à chaque étape d’auto-correction, l’IA relit, réindexe et réanalyse l’intégralité de la base de code, de la documentation et des états du navigateur. Cette phase d’ingestion représente à elle seule les trois quarts de la facture computationnelle, bien que le modèle rédige 10 % de texte de sortie en moins que l’ancien Spark.
Face à cette réalité financière, Meta a verrouillé sa distribution : Muse Wonderful est absent des API traditionnelles de vente au jeton. Le modèle est exclusivement accessible via la suite Muse Code, déclinée en deux forfaits : une offre “Power Usage” à 50 $/mois et un plan “Maximum Usage” à 200 $/mois (offrant 80 fois le volume de traitement du forfait de base).
Vitesse de génération brute (Tokens / Seconde) :
├── GLM 5.3 Highspeed : ████████████████████████████████████ 490 t/s
├── DeepSeek v4.1 Flash : █████████ 121 t/s
└── GLM 5.3 (Standard) : █ 71 t/s
Cette approche basée sur la lecture continue et la réflexion profonde contraste radicalement avec la stratégie chinoise axée sur la vitesse d’inférence pure. Le modèle GLM 5.3 Highspeed pulvérise ainsi les récompenses de vitesse à 490 tokens par seconde, contre 121 t/s pour DeepSeek v4.1 Flash et 71 t/s pour le modèle GLM 5.3 standard. Pour un agent réalisant des dizaines d’appels système successifs, ce différentiel de vitesse permet d’économiser plusieurs minutes par tâche.
Cependant, le calcul stratégique de Mark Zuckerberg se situe ailleurs : l’objectif de Meta n’est pas de commercialiser des API aux développeurs, mais d’irriguer directement son écosystème de 3 milliards d’utilisateurs sur Instagram, WhatsApp et Facebook avec des agents autonomes capables d’exécuter des actions complexes dans la vie réelle.
Êtes-vous prêt à céder les clés de votre vie numérique ?
Nous assistons à une transition fondamentale : l’ère des modèles de langage passifs s’efface devant celle des agents autonomes exécutifs. Qu’il s’agisse de concevoir un plan de table de mariage intégrant les contraintes relationnelles de dizaines d’invités, de générer et commander un objet personnalisé en analysant vos photos Instagram, ou encore de piloter un litige d’assurance en parcourant vos contrats et vos emails, l’intelligence artificielle passe du statut d’assistant rédactionnel à celui d’opérateur du quotidien.