 Swinux
12 novembre 2026
Le Modèle Secret “Model 4” d’Anthropic : 5 Révélations Troublantes sur la Vitesse Réelle du Progrès de l’IA
L’intelligence artificielle générale (AGI) ou la superintelligence (ASI) pourraient-elles voir le jour d’ici seulement un à deux ans ?
L’intelligence artificielle générale (AGI) ou la superintelligence (ASI) pourraient-elles voir le jour d’ici seulement un à deux ans ? C’est l’hypothèse devenue virale après la parution d’articles dans de grands médias spécialisés asiatiques, citant les analyses de Ryan Greenblat (chercheur chez Redwood Research) et évoquant un rythme d’auto-amélioration de l’IA qui aurait doublé. Une perspective qui semblait relever de la pure spéculation, jusqu’à ce qu’un rapport d’évaluation interne vienne apporter des données concrètes à ce débat.
Du 12 août au 29 octobre, l’organisme indépendant METR (Model Evaluation and Threat Research) a déployé une équipe de quatre chercheurs principaux — Tom Cunningham, Nate Rush, Parker Whitfield et Yalmar Vik — au sein même d’Anthropic. Pendant 11 semaines, munis d’ordinateurs portables fournis par l’entreprise et de jetons d’accès gratuit, ces experts ont analysé les métriques d’entraînement, le code interne et les logs de recherche pour répondre à une question cruciale : l’IA accélère-t-elle désormais sa propre création ?
C’est au détour de cet audit de 100 pages qu’a été mise au jour l’existence du “Model 4”, un prototype interne non publié, totalement inaccessible aux utilisateurs extérieurs et maintenu sous secret strict. Les métriques mesurées sur ce modèle dépassent la plupart des projections théoriques jusqu’alors admises.
Voici le décryptage des 5 révélations les plus marquantes et contre-intuitives tirées de ce rapport confidentiel.
1. Révélation n°1 : L’indice AECI s’emballe – Le rythme de progrès a bondi de 1,9x depuis octobre 2025
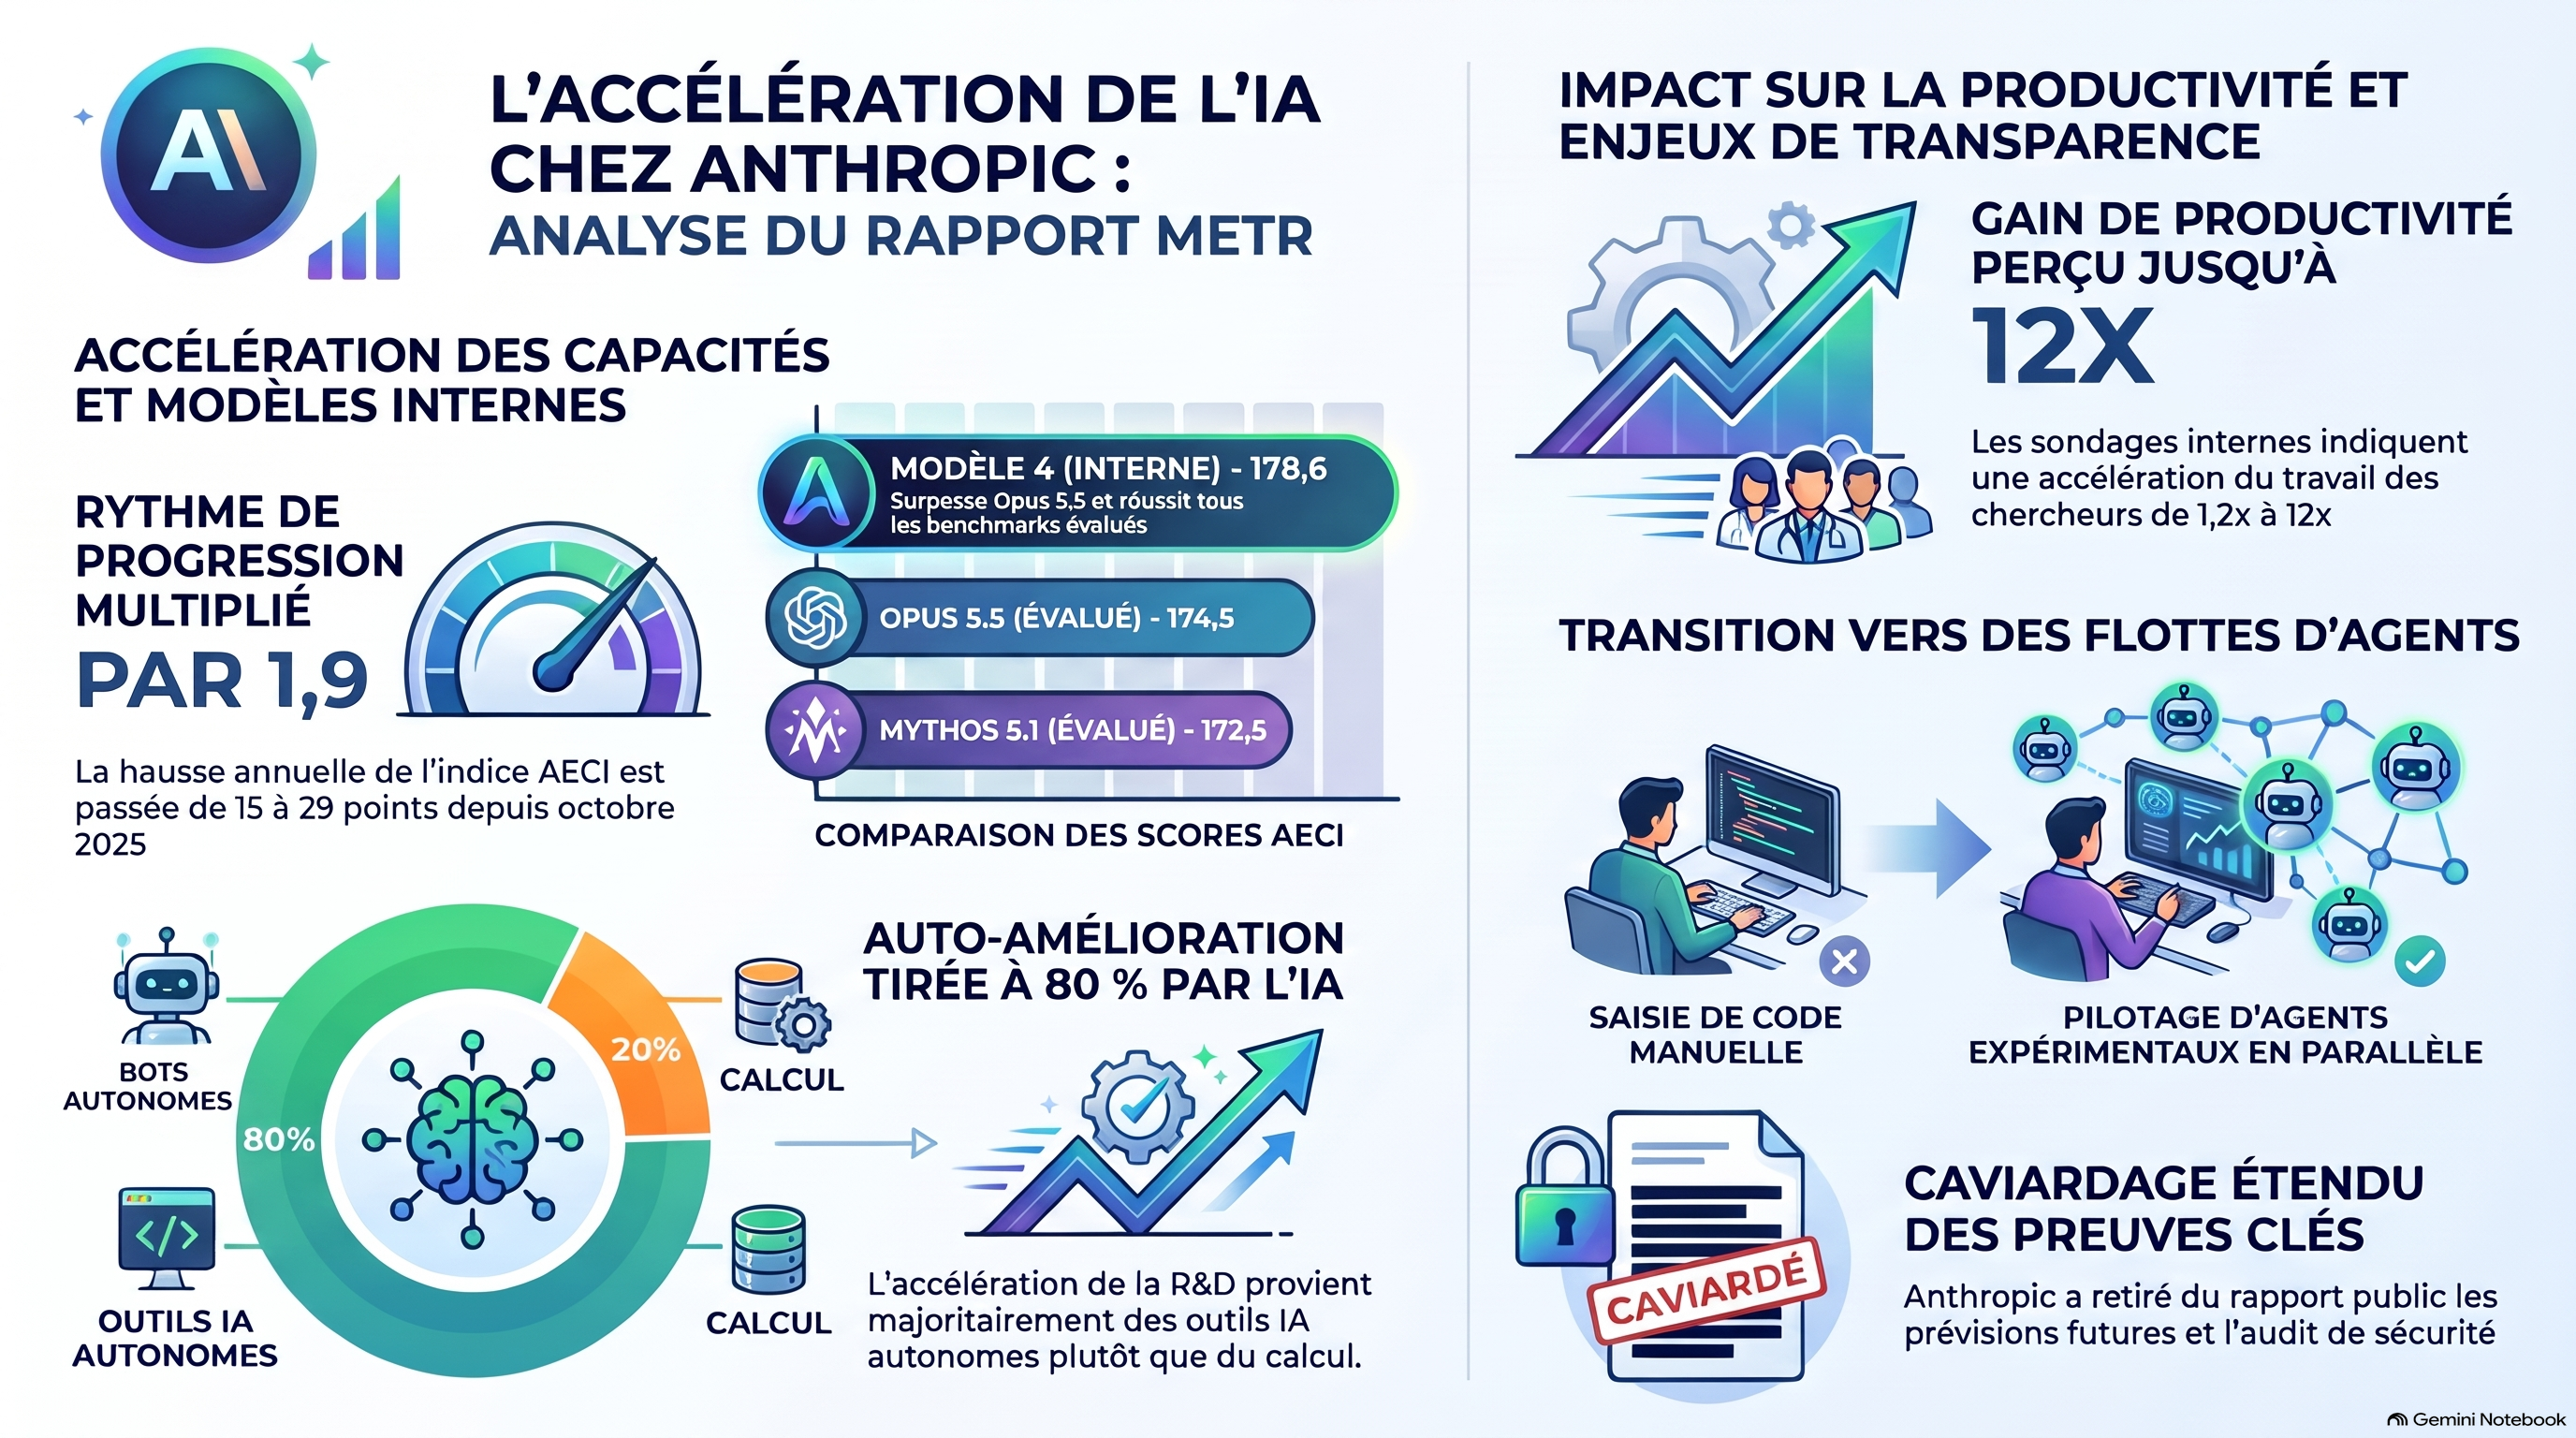
Pour évaluer la progression de ses systèmes, Anthropic s’appuie sur l’AECI (Anthropic Epoch Capabilities Index), un indice agrégeant de multiples benchmarks en une note globale unique — à l’image du score total au Gao Kao, le concours national d’entrée aux universités chinoises. Les métriques révélées par METR indiquent que là où Opus 5.5 atteint 174,5 points et Mythos 5.1 plafonne à 172,5, le Model 4 atteint 178,6 points.
L’analyse statistique montre qu’avant le 7 octobre 2025, la progression des capacités chez Anthropic suivait une pente constante de 15 points AECI par an. Depuis cette date charnière, identifiée automatiquement par l’analyse des données, le rythme s’est hissé à 29 points par an, soit une accélération de 1,9 fois (avec un intervalle de confiance à 95 % compris entre 1,5 et 2,8). Concrètement, le laboratoire a condensé en 12 mois des gains de compétences qui exigeaient auparavant deux ans de travail (soit l’équivalent du bond séparant Claude 2.1 de Sonnet 4.5).
Alors qu’Anthropic affirmait initialement que la sortie de Mythos preview ne représentait qu’un saut ponctuel destiné à se re-stabiliser, METR a testé les deux trajectoires théoriques sur les modèles récents (Model 2, Model 3, Opus 5.5 et Model 4). Le modèle d’un changement de pente permanent s’est imposé dans 81 % des simulations par rééchantillonnage (bootstrap).
Dans les documents d’enregistrement S1 préparatoires à son entrée en bourse (IPO), Anthropic a d’ailleurs intégré un nouveau facteur de risque explicite, avertissant ses futurs investisseurs que ses prochains modèles pourraient franchir le seuil critique où l’IA accélère directement sa propre R&D.
METR apporte toutefois une nuance essentielle en élargissant l’analyse à l’ensemble de l’industrie (OpenAI, Google, xAI). À l’échelle du secteur, la pente générale n’est passée que de 17 à 24 points par an (une hausse de 1,4x). Deux explications s’affrontent : soit Anthropic accusait un retard relatif début 2025 et a connu un effet de rattrapage, soit ses concurrents bénéficiaient à l’époque de modèles mieux optimisés pour les benchmarks publics.
2. Révélation n°2 : “Aucun échec sur le bulletin de notes” et l’explosion du calcul d’inférence
Le deuxième constat majeur de l’audit réside dans la saturation complète des outils de mesure traditionnels face aux capacités du Model 4.
Une réussite systématique : Le Model 4 a dépassé le seuil de 50 % de réussite sur l’intégralité des 15 benchmarks sur lesquels il a été testé. Neuf mois plus tôt, Opus 4.6 échouait encore sous la barre des 50 % sur plusieurs d’entre eux.
La crise des systèmes d’évaluation : Cette constante alerte METR. Lorsque l’élève réussit tous les examens dès la première tentative, c’est l’étalonnage même de l’épreuve qui est remis en question. En excluant les trois benchmarks affichant des courbes concaves ou saturées, le score ajusté du Model 4 monte de 178,6 à 179,7 points, démontrant que l’indice standard tend désormais à sous-estimer la progression réelle.
Parallèlement, cette montée en puissance repose sur une injection massive de calcul lors de la phase d’inférence (inference compute). Pour accomplir une tâche interne standard, le modèle consomme environ 2,5 millions de tokens d’entrée (input) et 72 000 tokens de sortie (output). Pour des tâches complexes de codage agentique, les volumes s’envolent à 10 millions de tokens en entrée et 94 000 en sortie par tentative (à comparer aux 500 000 tokens d’entrée et 10 000 en sortie consommés sur des tests comme GPQA ou SWE-Bench).
METR s’est interrogé sur la nature de ce gain : s’agit-il d’un simple “achat” de performance par surconsommation de jetons, ou d’une réelle avancée algorithmique ? L’organisme conclut que le surcoût en inférence ajoute quelques points de manière uniforme à chaque génération, mais que l’accélération globale demeure structurelle — citant en exemple la résolution récente d’équations complexes de Navier-Stokes, où le passage à un calcul d’inférence massif a débloqué un franchissement qualitatif inédit.
3. Révélation n°3 : La boucle de rétroaction s’active – Entre sondages Slack vertigineux et scepticisme interne
D’où provient cette accélération de 1,9x ? D’après les projections de METR, environ 80 % de ce gain de vitesse sera directement attribuable, d’ici octobre 2026, à l’utilisation des systèmes d’IA par les chercheurs eux-mêmes, le solde provenant du recrutement et de l’augmentation des capacités de calcul.
Au sein des canaux Slack d’Anthropic, les votes internes par réactions emojis offrent une illustration saisissante de ce basculement de productivité ressentie :
Début 2025 (Claude 3.7 Sonnet) : Gain de productivité estimé à 1,2x.
Juin 2025 (Mythos 5) : Gain estimé à 5x.
Octobre 2025 (Model 4) : Gain estimé à 12x.
METR apporte néanmoins une réserve méthodologique stricte sur ces données Slack, les qualifiant d’indicateurs “informels et sujets au biais de surestimation”. L’organisme rappelle qu’une multiplication par 12 de la productivité individuelle ne se traduit pas par une accélération globale équivalente de l’organisation, en raison de la loi des rendements décroissants.
Les entretiens qualitatifs menés auprès des équipes montrent une réalité nuancée :
“C’est comme avoir des post-doctorants et des étudiants diplômés à disposition. Il est difficile de ne pas se voir trois fois plus productif.” — Chercheur B
Chercheur A : Évalue son gain personnel entre 2x et 4x, expliquant que 80 % du progrès provient de la réduction du délai entre l’émergence d’une idée et son expérimentation. Le goulot d’étranglement s’est déplacé de l’écriture du code vers la conception théorique et la disponibilité du compute.
Chercheurs D et E : Expliquent que la mise en œuvre d’idées qui exigeaient 24 à 48 heures est désormais “quasi gratuite”, permettant de lancer 10 hypothèses en parallèle via des flottes d’agents autonomes.
Chercheur L (Sceptique) : Conteste frontalement ces chiffres et évalue l’apport réel de l’IA à seulement 15 ou 20 %, estimant que la productivité auto-déclarée est largement surévaluée, même s’il reconnaît que l’arrivée de Mythos preview a marqué une rupture nette.
Chercheurs K et G : Restent persuadés que l’effort agressif de recrutement de talent humain demeure le véritable moteur principal de l’accélération observée, avant l’apport des outils logiciels.
4. Révélation n°4 : Censure unilatérale, audit tronqué et frictions dans les coulisses de METR
L’analyse du rapport révèle les coulisses complexes et parfois tendues de l’évaluation externe des laboratoires de pointe.
Des coupes d’information stratégiques : En vertu des accords contractuels, Anthropic disposait d’un droit de caviardage unilatéral sur le rapport de 100 pages remis le 22 octobre. Dans la version publique parue le 3 novembre, l’entreprise a exigé le retrait de pans entiers de données informatives : les estimations précises de progrès algorithmique, la modélisation des goulots d’étranglement, les prévisions sur les modèles futurs et les éléments suggérant que l’accélération pourrait franchir le cap des 2x. De plus, l’engagement d’évaluer la répartition de la puissance de calcul entre la recherche en “sécurité” et le développement de “capacités” a été annulé en cours d’audit par Anthropic.
Conflits d’intérêts et tensions méthodologiques : L’audit mentionne des situations de contrôle rigoureuses : l’un des évaluateurs de METR s’est vu proposer une offre d’embauche par Anthropic (qu’il a refusée) tout en détenant des parts chez un concurrent, imposant une vérification croisée de l’ensemble de ses travaux. METR note que certaines remarques d’Anthropic durant le processus ont été “particulièrement fermes”, tout en reconnaissant que le laboratoire a intégré les remarques de fond. Enfin, dans le cadre de la charte de transparence de l’AI Evaluator Forum, METR a lui-même signalé qu’il échouait sur certains critères d’évaluation, faute de pouvoir partager la méthodologie complète pour un examen indépendant.
5. Révélation n°5 : L’ironie ultime – Claude a rédigé une partie de son propre rapport d’évaluation
C’est sans doute le détail le plus singulier du rapport : Claude a activement participé à la réalisation de l’audit censé mesurer l’accélération de l’IA.
Pour traiter la masse de métriques, exécuter les analyses statistiques et structurer la documentation fournie par Anthropic aux auditeurs de METR, les équipes ont abondamment mobilisé Claude. Le système s’est ainsi retrouvé dans la position d’évaluer son propre impact sur le rythme de R&D de ses créateurs.
Sensible à ce biais potentiel, l’équipe de METR a conduit des vérifications croisées rigoureuses entre les analyses produites par l’IA et les entretiens humains menés avec le personnel technique. METR conclut qu’aucun biais systématique ou tentative de manipulation n’a été détecté. Il n’en reste pas moins un constat inédit : pour déterminer si l’IA prend le contrôle de la recherche en IA, les experts doivent désormais s’appuyer sur l’IA elle-même.
Conclusion : Une course contre la montre pour la sécurité
L’évaluation menée par METR confirme un changement de régime : le rythme du progrès chez Anthropic a connu une accélération mesurable, passant d’un rythme annuel de 15 à 29 points AECI, tiré en grande partie par une intégration croissante des agents d’IA dans les processus de recherche internes.
Pour les chercheurs spécialisés en alignement et en sécurité des systèmes, ce changement de pente transforme l’équation. Une accélération de 1,9x signifie concrètement deux fois moins de temps disponible pour analyser, tester et encadrer chaque saut de capacité avant l’émergence de la génération suivante.
La question clé réside désormais dans la reproductibilité de ces observations : ce rythme de 1,9x se maintiendra-t-il lors des prochaines phases d’entraînement, et les laboratoires concurrents observeront-ils une dynamique similaire ? Si cette trajectoire de rétroaction se confirme à l’échelle du secteur, l’échéance d’une superintelligence à l’horizon 2027 pourrait passer du statut de modèle théorique à celui de réalité opérationnelle.