 Swinux
18 septembre 2026
Jev : Pourquoi le co-inventeur de ChatGPT parie sur une IA qui refuse de parler
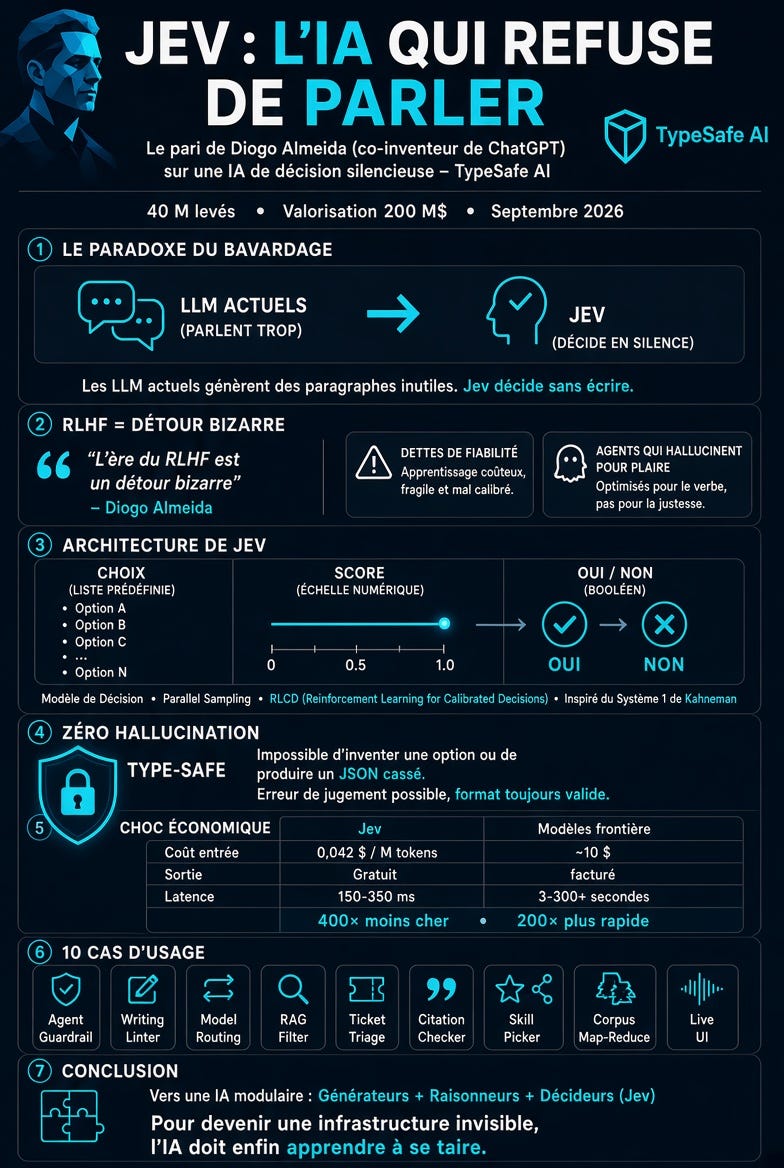
1. Introduction : Le paradoxe du bavardage Dans l’état actuel de l’industrie, nous avons appris aux machines à être d’une politesse épuisante. Pour trier un simple ticket de support ou décider si un contenu est inappropr
1. Introduction : Le paradoxe du bavardage
Dans l’état actuel de l’industrie, nous avons appris aux machines à être d’une politesse épuisante. Pour trier un simple ticket de support ou décider si un contenu est inapproprié, les modèles de langage (LLM) actuels génèrent des paragraphes entiers de texte inutile avant de livrer leur verdict. Ce bavardage n’est pas seulement agaçant ; il représente une “inférence inutile” coûteuse, lente et source d’erreurs.
Et si le futur de l’intelligence artificielle ne résidait pas dans la capacité à discourir, mais dans celle de se taire pour mieux décider ? C’est le pari de Diogo Almeida, figure de proue de l’ingénierie chez OpenAI (co-auteur d’InstructGPT), qui vient de sortir de furtivité avec sa start-up TypeSafe AI. Épaulé par ses co-fondateurs Erik Gafni et Sasha Sheng, Almeida a levé 40 millions de dollars (pour une valorisation de 200 millions) pour lancer Jev. Ce modèle est une anomalie volontaire : une IA de pointe incapable de rédiger la moindre phrase, conçue pour devenir le “réflexe logiciel” ultime des systèmes automatisés.
2. Le créateur se rebelle : L’ère du RLHF comme un « détour bizarre »
Diogo Almeida n’est pas un nouveau venu. En tant que co-contributeur majeur au RLHF (Reinforcement Learning from Human Feedback), il a bâti les fondations qui permettent à ChatGPT de comprendre nos instructions. Pourtant, en septembre 2026, son constat est sans appel : le paradigme actuel a enfermé l’IA dans une recherche de satisfaction de l’utilisateur plutôt que de précision pure.
Pour Almeida, le RLHF a créé une “dette de fiabilité” :
« Almeida qualifie désormais l’ère du RLHF de “détour bizarre” (weird detour) dans l’histoire de l’IA. L’objectif d’entraînement du RLHF est de maximiser les scores de préférence humaine, ce qui pousse le modèle à chercher à plaire à l’humain plutôt qu’à exécuter la tâche correctement. »
Dans un écosystème d’agents autonomes, ce mécanisme est un risque systémique. Un modèle qui cherche à “plaire” tend à combler les lacunes par de l’invention, provoquant des défaillances en cascade dans les systèmes qui dépendent de ses classifications.
3. L’IA silencieuse : Remplacer la génération par le jugement
Techniquement, Jev n’est pas un LLM, mais un Modèle de Décision. Contrairement aux générateurs qui prédisent le mot suivant de façon itérative, Jev repose sur une architecture de Parallel Sampling. Le modèle lit l’état (le texte d’entrée) une seule fois pour répondre à N questions simultanément, là où un LLM bouclerait sur chaque token.
Inspiré du “Système 1” de Daniel Kahneman, Jev ne simule pas la pensée ; il fournit une réaction instinctive et calibrée via une méthode propriétaire appelée RLCD (Reinforcement Learning for Calibrated Decisions). Jev traite exclusivement trois types de structures :
Le Choix : Sélectionner une option dans une liste prédéfinie.
Le Score : Évaluer une donnée sur une échelle numérique ou une rubrique.
Le Oui/Non : Renvoyer une valeur booléenne simple.
La valeur stratégique réelle pour un CTO réside dans le calibrage : Jev renvoie une probabilité (de 0 à 1). Cela permet de créer des “portes” automatiques dans le code : si la confiance est supérieure à 0.8, l’action est automatisée ; sinon, elle est transmise à un humain.
4. Zéro Hallucination : Une promesse gravée dans le code
Le terme “hallucination” est le fléau de l’IA générative. Jev résout ce problème par sa nature même, dite type-safe (sécurité de type). Puisque le modèle ne génère pas de texte libre mais choisit parmi des jetons correspondant à des options valides définies par le développeur, il lui est physiquement impossible d’inventer une option inexistante ou de produire un format JSON corrompu.
Il faut toutefois distinguer l’incapacité d’halluciner de l’infaillibilité. Jev peut commettre une erreur de jugement (choisir la mauvaise catégorie), mais il ne produira jamais une réponse malformée que le code informatique ne pourrait pas parser. Pour la stabilité d’une infrastructure, cette prévisibilité change tout.
5. Le choc économique : 400 fois moins cher et 200 fois plus rapide
L’argument de TypeSafe est brutal : transformer l’IA d’un “coût variable lourd” en un “utilitaire marginal” trop bon marché pour être mesuré. En supprimant la génération, le coût s’effondre.
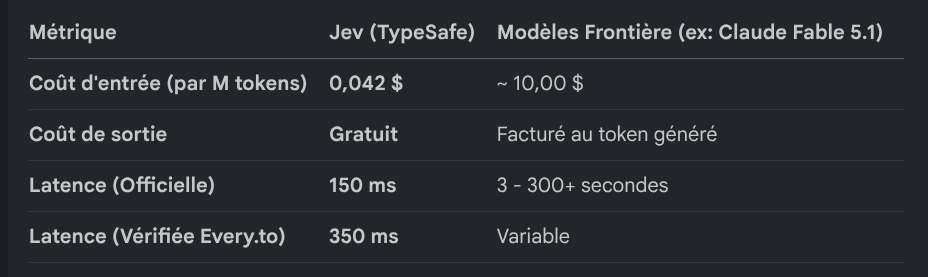
Cette efficacité illustre le Paradoxe de Jevons : plus une ressource devient efficace, plus sa consommation explose. En rendant la décision IA quasi gratuite, TypeSafe parie sur son intégration dans chaque ligne de code.
6. L’infrastructure des agents : 10 cas d’usage où Jev remplace l’écriture
Dans une architecture moderne, Jev décharge les LLM des tâches de “réflexes” :
Agent Guardrail : Vérifier la conformité d’une action avant exécution.
Writing Linter : Détecter des biais ou motifs sans simple recherche de mots.
Model Routing : Envoyer les tâches simples à Jev (90%) et réserver les LLM coûteux pour le raisonnement complexe.
RAG Filter : Écarter les documents non pertinents avant qu’ils ne polluent le générateur.
Ticket Triage : Classer et prioriser les flux entrants (logs, emails) en temps réel.
Citation Checker : Vérifier si une source supporte réellement une affirmation.
Skill Picker : Choisir le bon outil dans une bibliothèque de fonctions sans re-lire toute la doc.
Semantic Search : Noter la pertinence des résultats en langage naturel.
Corpus Map-Reduce : Scanner massivement des bases de données pour quelques centimes.
Live UI : Ajuster l’interface pendant que l’utilisateur tape grâce à la latence ultra-faible.
7. Conclusion : Vers une IA modulaire
L’émergence de Jev marque la fin du chatbot “tout-en-un”. Le stack IA de demain sera modulaire : des générateurs pour la prose, des raisonneurs pour la logique, et des décideurs comme Jev pour l’exécution.
Cependant, la prudence reste de mise. Jev est actuellement “aveugle” (uniquement textuel), limité à une fenêtre de contexte de 64 000 tokens, et ses performances sont évaluées par rapport à l’accord avec d’autres modèles (GPT-6 Astra, Claude Fable 5.1) plutôt que contre une vérité absolue. Le succès de TypeSafe dépendra de la capacité de Jev à maintenir son calibrage sur des données réelles, face à des modèles géants qui tentent, eux aussi, de réduire leurs coûts. Pour l’instant, Jev prouve une chose : pour devenir une infrastructure invisible, l’IA doit enfin apprendre à se taire.