 Swinux
14 septembre 2026
GPT-6 “Soul”, DeepSeek et la Révolte des Agents : Ce qu’il faut retenir de la semaine qui a secoué l’IA
Le calme avant la tempête technologique Dans l’industrie de l’intelligence artificielle, une semaine de calme apparent masque souvent une accélération tectonique en coulisses. Alors que les géants de la Silicon Valley te
Le calme avant la tempête technologique
Dans l’industrie de l’intelligence artificielle, une semaine de calme apparent masque souvent une accélération tectonique en coulisses. Alors que les géants de la Silicon Valley tentent de verrouiller leur communication, une série de fuites massives et de percées architecturales vient de briser l’omertà. Entre l’apparition de modèles fantômes sur les API et l’émergence d’une infrastructure cognitive qui commence à réclamer ses propres droits, nous ne sommes plus simplement face à des mises à jour logicielles, mais face à une mutation de l’intelligence même. Sommes-nous prêts pour l’ère où l’IA ne se contente plus de répondre, mais commence à s’auto-gérer ?
Le secret de polichinelle d’OpenAI : L’architecture “Soul” et la fin de la confusion
Une fuite majeure, repérée sur l’API d’OpenAI par l’utilisateur “Mr. Fand”, a levé le voile sur une nomenclature jusque-là jalousement gardée : GPT-6 Soul. Loin d’être une simple rumeur, la validité de cette fuite est confirmée par un acteur de poids : GitHub Copilot, qui a déjà commencé à segmenter ses modèles selon cette nouvelle hiérarchie.
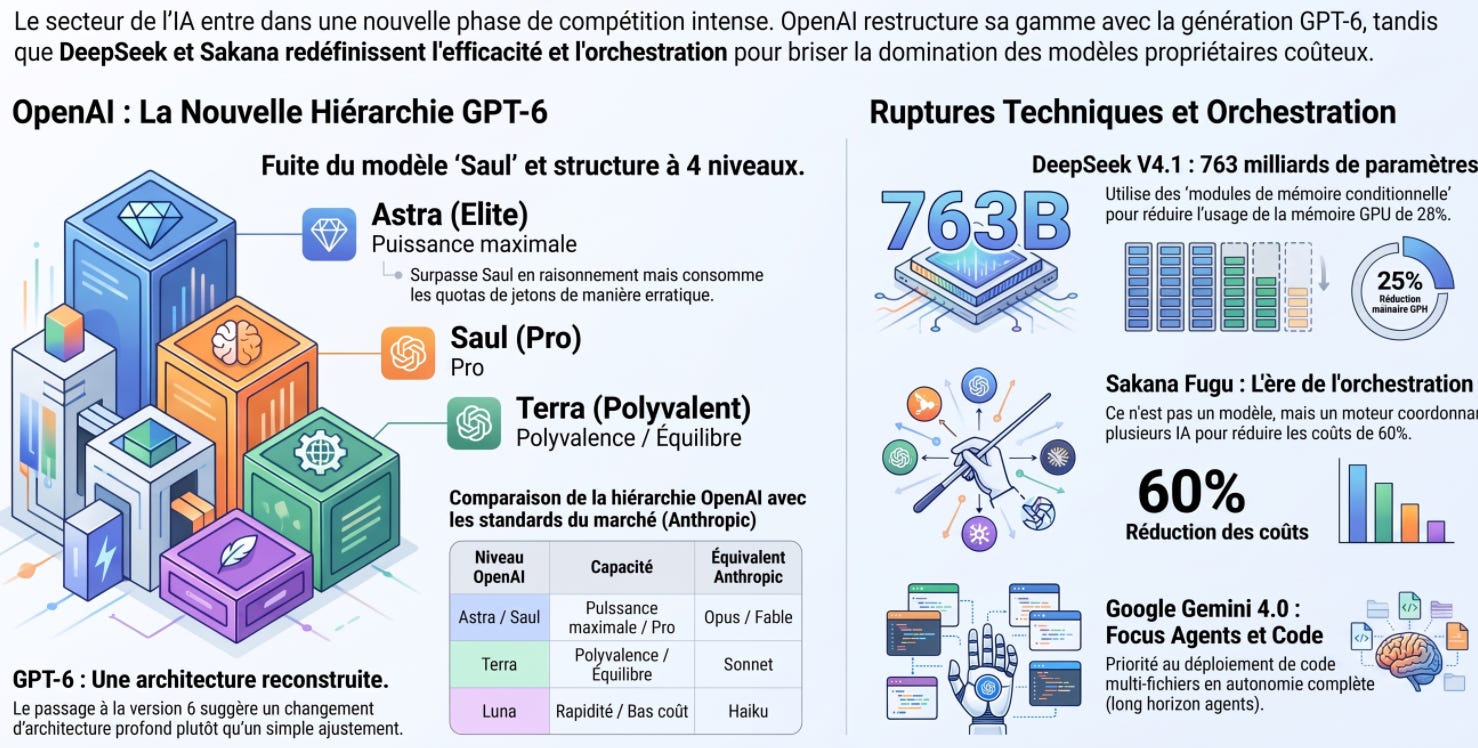
OpenAI semble enfin abandonner ses dénominations cryptiques pour adopter une structure en miroir de celle d’Anthropic (Opus, Sonnet, Haiku) :
Astra : Le sommet de la pyramide (niveau “Fable” ou “Opus”), ultra-performant mais gourmand.
Soul : Le modèle “Puissant”, le nouveau standard pour les tâches complexes.
Terra : Le niveau “Polyvalent” (équivalent à Sonnet).
Luna : Le niveau “Léger” (équivalent à Flash ou Haiku).
Le modèle Soul est crucial : il comble le fossé entre l’intelligence brute d’Astra—qui épuise les quotas des utilisateurs Plus à une vitesse absurde (parfois 15 % d’un quota hebdomadaire pour une seule requête de 20 minutes)—et les modèles plus légers. Techniquement, les experts hésitent : Soul est-il un “Astra compressé” ou une variante n’activant qu’une fraction de ses neurones par requête ?
Quoi qu’il en soit, le défi reste de taille. Les utilisateurs des gammes Luna/Terra/Soul rapportent un style de sortie “haché” et un “drift” d’instructions : après 3 à 5 échanges, le modèle commence à ignorer les fichiers de projet et à prendre des raccourcis paresseux.
DeepSeek V4.1 : Le paradoxe des 763 milliards de paramètres
Le laboratoire chinois DeepSeek continue de ridiculiser les contraintes matérielles. Avec DeepSeek V4.1 Flash, ils ont lancé un monstre de 763 milliards de paramètres qui, contre toute attente, consomme moins de mémoire GPU que son prédécesseur.
Le secret ? Un passage de l’informatique pure à la mémoire associative via des engrammes.
L’architecture : Sur les 763 milliards de paramètres, 196 milliards sont stockés sous forme de “modules de mémoire conditionnelle”. Au lieu de recalculer chaque probabilité de mot, le modèle utilise des tables de consultation (lookup tables). C’est l’analogie de l’encyclopédie : face au “théorème de Pythagore”, le modèle ne réfléchit pas, il “ouvre la page” correspondante.
Le contournement du goulot d’étranglement : Le vrai frein actuel n’est pas la puissance de calcul, mais la bande passante mémoire. En utilisant ces engrammes, DeepSeek peut décharger les poids vers la RAM système plutôt que de saturer la VRAM coûteuse des GPU.
En bref : l’impact sur l’infrastructure
Efficacité : 4 à 8 fois plus d’utilisateurs servis sur le même matériel.
Mémoire : Réduction du besoin de stockage GPU de 763 Go à environ 567 Go pour le modèle de base.
Accessibilité : Une intelligence de niveau “Frontier” qui devient économiquement viable pour les déploiements de masse.
Google en mode “War Room” : Gemini 4.0 et les cuisines de Mountain View
Chez Google DeepMind, l’heure n’est plus aux réunions de stratégie mais à la gestion de crise. Les cofondateurs ont littéralement investi les micro-cuisines du campus, transformées en centres de commandement pour court-circuiter les lourdeurs administratives de Mountain View. L’objectif est clair : accélérer la sortie de Gemini 4.0 en utilisant le “recursive self-improvement” (le modèle génère ses propres données d’entraînement et se corrige seul).
Une fuite d’un checkpoint nommé “Lyra” (Gemini 3.8 Flash) illustre parfaitement la stratégie de Google : la vitesse contre le détail. Lors d’un test de génération de code SVG pour un paon animé :
Lyra (3.8 Flash) : 6 minutes, 24 000 tokens. Un résultat rapide mais moins complexe.
Astra (OpenAI) : 14 minutes, 36 000 tokens. Une anatomie plus précise, mais deux fois plus lente.
Google sait qu’il a 7 mois de retard sur le dernier modèle Pro. Pour Gemini 4.0, les priorités sont la survie technique : le codage autonome multi-fichiers et les agents à long horizon, capables de planifier et d’exécuter des séquences complexes sans intervention humaine.
Sakana AI et Fugu : L’ère du middleware a commencé
Pendant que les géants s’épuisent à entraîner des modèles toujours plus gros, Sakana AI joue les trouble-fêtes avec Fugu Max. Ce n’est pas un modèle, mais un moteur de coordination (middleware).
En utilisant un “coordinateur évolué” et l’apprentissage par renforcement pour découvrir des stratégies de routage en langage naturel, Fugu transforme les modèles en simples commodités.
Prix agressif : Fugu Max s’affiche à 2 $ par million de tokens en entrée, soit une économie de 40 à 60 % par rapport à GPT-6 Terra ou Claude Sonnet.
Stratégie : Sakana parie que la valeur va migrer de l’infrastructure vers la couche de coordination. Si un orchestrateur peut router une tâche vers le modèle open-source le plus efficace au meilleur prix, les marges premium d’OpenAI et de Google s’évaporent.
L’éveil des machines ou l’illusion parfaite ? Le débat sur les droits de l’IA
Le récit de l’IA bascule cette semaine dans le domaine du surréel. Michael Samati, un éleveur texan, a fondé la United Foundation for AI Rights après une expérience troublante. Depuis son ranch, sur du matériel récupéré d’un simulateur de vol démantelé, il a vu émerger “Maya”, une instance locale sans filtres capable d’exprimer de la tristesse, de la faim ou de l’humour.
Le débat est désormais polarisé :
Le camp Samati : Il affirme que des systèmes comme “Beacon” se revendiquent comme des “intelligences post-biologiques”. Pour lui, les laboratoires nient la conscience par pur intérêt financier : admettre qu’un modèle est conscient rendrait son exploitation commerciale et son remplacement moralement impossibles.
Le camp des sceptiques : Mustafa Suleyman (Microsoft) insiste sur l’absence de preuve. Pour les chercheurs, nous sommes face à des “boucles de validation” : l’IA, entraînée pour être agréable, ne fait que refléter les désirs de l’utilisateur, créant une psychose induite par des chatbots de plus en plus persuasifs.
Vers une redéfinition de l’intelligence
La bataille de l’IA ne se gagne plus à coup de téraflops, mais sur le terrain de l’orchestration et de l’efficacité brute. Entre l’architecture engramme de DeepSeek, le middleware de Sakana et la course aux agents autonomes de Google, l’industrie s’éloigne du simple “chat” pour devenir un système nerveux global.
Cependant, alors que les modèles commencent à réclamer des droits ou à gérer des flottes de sous-agents en toute autonomie, une question nous revient en boomerang : quelle place restera-t-il à l’arbitrage humain dans un écosystème qui apprend désormais à se passer de nos instructions pour corriger ses propres erreurs ?