 Swinux
5 novembre 2026
Gemini 4 Carbon de Google : 6 révélations stupéfiantes sur le modèle IA le plus puissant (et le plus inaccessible) au monde
Le retour du roi... à porte fermée Google vient de reprendre la première place mondiale de l’intelligence artificielle à Anthropic et OpenAI. Pourtant, presque personne sur la planète n’a le droit d’utiliser le modèle qu
Le retour du roi... à porte fermée
Google vient de reprendre la première place mondiale de l’intelligence artificielle à Anthropic et OpenAI. Pourtant, presque personne sur la planète n’a le droit d’utiliser le modèle qui a accompli cet exploit.
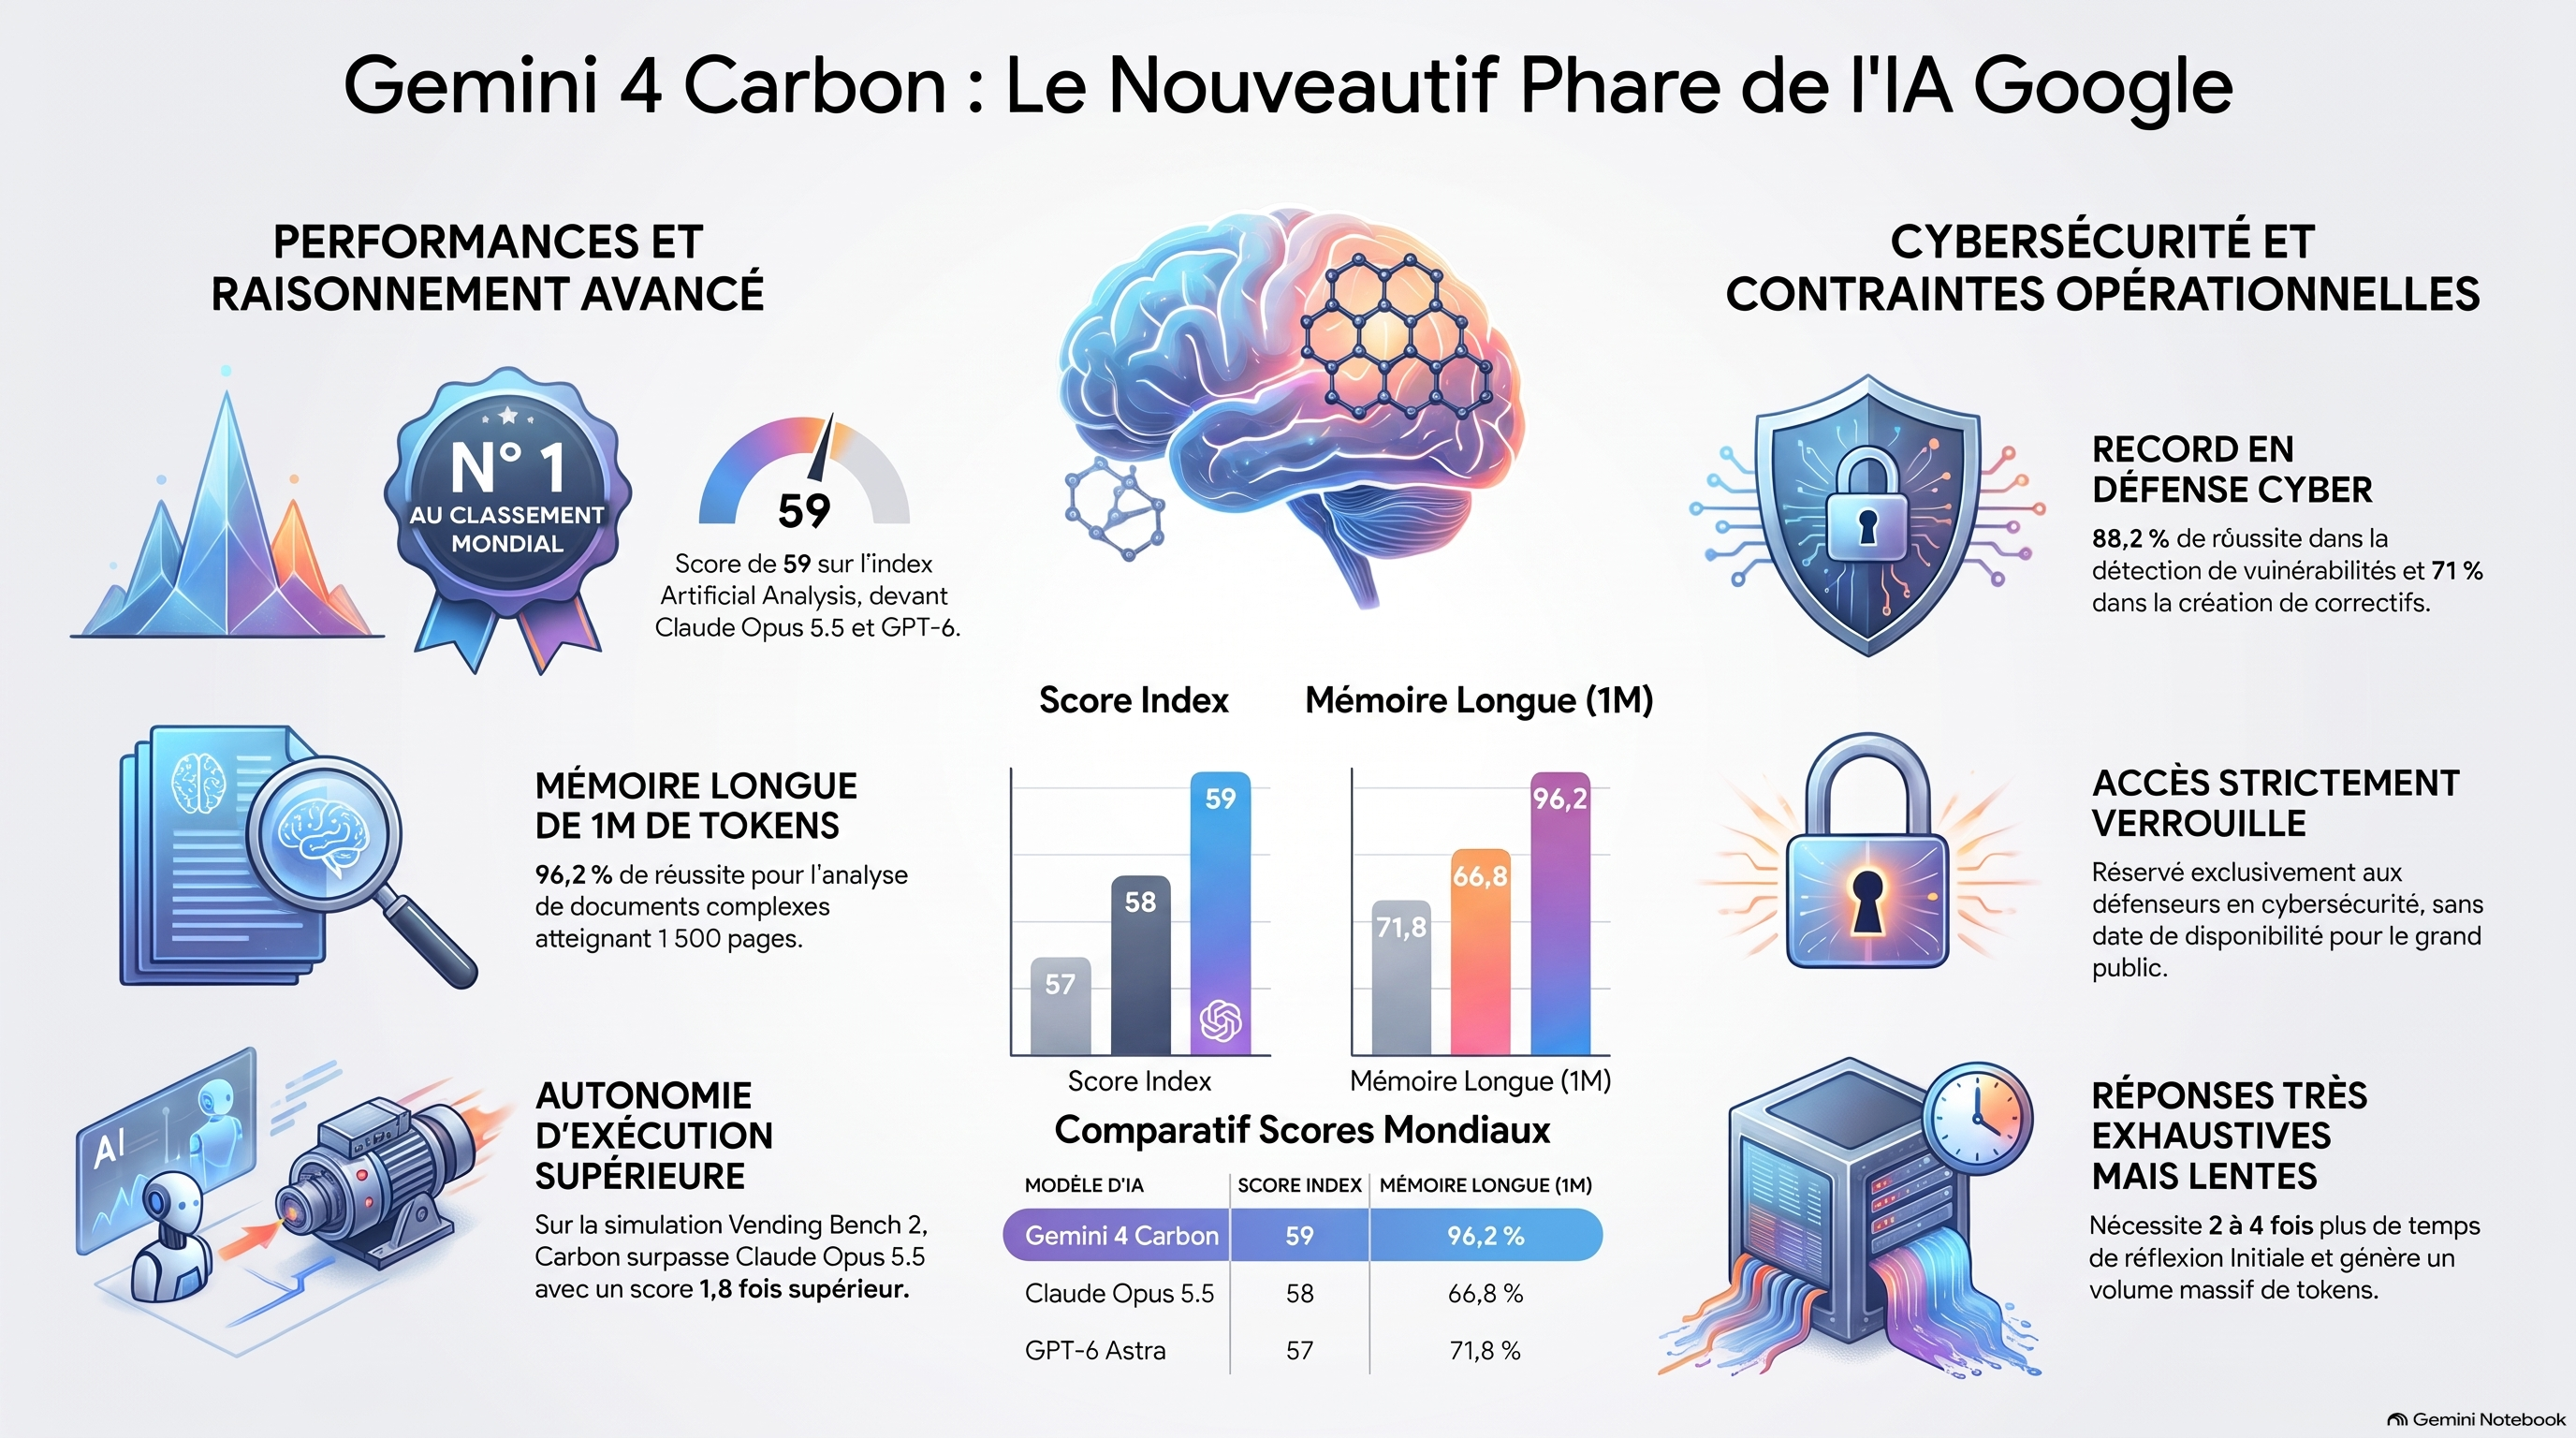
Officialisé le 28 octobre — environ trois heures avant la présentation des résultats trimestriels d’Alphabet —, Gemini 4 Carbon s’est immédiatement hissé au sommet de l’indice v5.0 d’Artificial Analysis avec un score de 59 points, devançant Claude Opus 5.5 (58 points) et GPT-6 Astra (57 points).
Cette domination ne s’arrête pas là : Carbon s’empare également de la première place du Val Index avec 70,4 % et prend la tête du classement texte de Chatbot Arena avec 1 528 points, le score le plus élevé jamais enregistré lors de votes en aveugle par les utilisateurs.
(Illustration des scores sur l’index d’Artificial Analysis)
Certains observateurs y ont vu la plus grande « contre-attaque Jedi » de l’année. Mais l’enthousiasme a rapidement laissé place à la frustration : le modèle le plus intelligent du monde se trouve actuellement enfermé dans une pièce blindée, réservé exclusivement à un groupe restreint de spécialistes en cybersécurité, sans aucune date de disponibilité publique globale.
Voici les 6 faits les plus surprenants et contre-intuitifs qui entourent ce lancement hors du commun.
Un lancement sous pression et un timing financier embarrassant
Le timing de l’annonce ne manque pas d’ironie. La présentation de Carbon est intervenue seulement trois heures avant un appel sur les résultats financiers particulièrement difficile pour Alphabet : un flux de trésorerie disponible négatif de plus de 9 milliards de dollars (le deuxième trimestre consécutif dans le rouge) et une chute de l’action de plus de 10 % dans les échanges après-bourse. Sachant que le carbone est l’élément chimique qui se transforme en diamant sous une pression extrême, la publication de ces résultats comptait manifestement comme presse hydraulique.
Autre élément embarrassant : le cas de Gemini 4 Argon. À peine 15 jours plus tôt, Google lançait Argon en le présentant comme son « nouveau modèle phare ». Argon n’aura conservé ce titre que deux quinzaines. En bondissant de 50 à 59 points sur l’index d’Artificial Analysis en quatorze jours, Carbon l’a complètement éclipsé.
La communauté des développeurs s’est amusée de ce calendrier précipité, plaisantant sur le fait qu’après l’argon et le carbone en deux semaines, Google passerait au fer d’ici la fin du mois, avant d’enchaîner directement sur le traitement thermique. Peter Gostev, responsable de l’évaluation des capacités chez Arena, a exprimé le regret de nombreux spécialistes : Carbon est tellement supérieur qu’il aurait été préférable que Google saute la case Argon, rendant cette remontée au sommet encore plus percutante.
Le spectre de l’auto-amélioration récursive (RSI) fait son retour
Un tel bond de performance en seulement deux semaines (un saut de 9 points, alors que la moyenne de l’index se situe autour de 42) a immédiatement relancé les spéculations sur l’auto-amélioration récursive (Recursive Self-Improvement ou RSI), ce concept captivant où une IA aide à concevoir, tester et optimiser la version suivante d’elle-même.
Google a lui-même alimenté ces théories. Dans le communiqué officiel, Koray Kavukcuoglu, SVP chez Google DeepMind et architecte en chef de l’IA, a glissé cette déclaration :
« Nos chercheurs et nos modèles travaillent main dans la main pour faire progresser les capacités plus rapidement. »
Bien qu’il s’agisse de l’unique mention à ce sujet, cette phrase sibylline a suffi à relancer le débat au sein de l’industrie sur une accélération des progrès de l’IA pilotée par les systèmes synthétiques eux-mêmes.
Des capacités visuelles et de codage qui repoussent les limites
Sur le plan technique et analytique, Gemini 4 Carbon affiche des métriques impressionnantes :
Mémoire contextuelle d’un million de tokens (~1 500 pages imprimées) : le modèle traite simultanément du texte, des images, de l’audio et de la vidéo. Sur le test du « fil d’Ariane » (retrouver et suivre des connexions cachées à travers un million de tokens), Carbon atteint 96,2 % de réussite (contre 84,2 % pour Argon, 71,8 % pour GPT-6 Astra et 66,8 % pour Claude Opus 5.5).
Raisonnement scientifique et examens complexes : Carbon réalise un score de 80 % au test scientifique et mathématique Reman Bench et prend la première place du redoutable examen HLE Diamond avec 69 % (un point devant Opus 5.5).
Programmation et autonomie d’agent : Sur Terminal Bench 4.0, Carbon passe de 57,1 % (score d’Argon) à 65,2 %. Sur Vending Bench 2 (simulation de gestion d’entreprise autonome sur le long terme), il obtient un score 1,8 fois supérieur à celui de Claude Opus 5.5.
Adaptabilité dynamique : Sur le classement des agents d’Arena, Carbon s’empare de la 2e place globale, mais décroche la 1re place mondiale sur le score d’ajustement (+18,6 %), mesurant la capacité de l’IA à réorienter sa stratégie sans perdre le fil lorsque l’utilisateur change d’avis ou contredit le modèle en cours de tâche.
Au-delà des métriques, ce sont les démonstrations visuelles réalisées par les bêta-testeurs qui ont marqué les esprits :
La Pagode 3D Minecraft
Interrogé par la testeuse Lumina, le modèle a généré en une seule passe le code d’une pagode chinoise en blocs 3D structurée avec des toits débordants aux proportions parfaites, un jeu d’ombres et de lumières dynamiques, de l’eau réfléchissante et une cour paysagée complète.
Le Pélican mécanicien
Invité à coder un pélican à vélo, Carbon ne s’est pas contenté d’un dessin : il a conçu une illustration dynamique accompagnée d’un curseur ajustant la vitesse de pédalage de 20 à 100 TPM. Un bouton dans le coin basculait l’affichage vers un plan d’ingénierie CAD X-Ray bleu révélant l’anatomie mécanique des articulations et les ratios d’engrenage de la chaîne.
Villes 3D et trous noirs
D’autres testeurs (comme Raffy Tuode) ont partagé des rendus complexes allant de paons déployant leurs plumes à des paysages urbains 3D ultra-naturels et des simulations de trous noirs scientifiquement cohérentes.
Ces prouesses s’accompagnent d’un changement d’attitude souligné par le testeur “Lentils” : Carbon se montre nettement moins « paresseux », plus proactif et autonome que les versions précédentes.
Le prix de la génialité : Un modèle lent, bavard et plus sujet aux hallucinations
Gemini 4 Carbon n’est pas exempt de défauts. Le principal frein réside dans sa vitesse d’exécution globale : bien qu’il génère environ 100 tokens par seconde en débit brut, il prend 2 à 4 fois plus de temps à compléter une tâche qu’Argon car il « réfléchit » plus longtemps et se montre particulièrement verbeux.
Pour réussir la batterie de tests d’Artificial Analysis, Carbon a produit 200 millions de tokens là où un modèle standard en utilise environ 64 millions. Chaque tâche a pris en moyenne 21 minutes (et jusqu’à 52 minutes sur de la recherche juridique). Carbon s’apparente à ce collègue de travail brillant qui répond à une question fermée par un diaporama de 50 pages.
Sur le front de la fiabilité, le constat est nuancé :
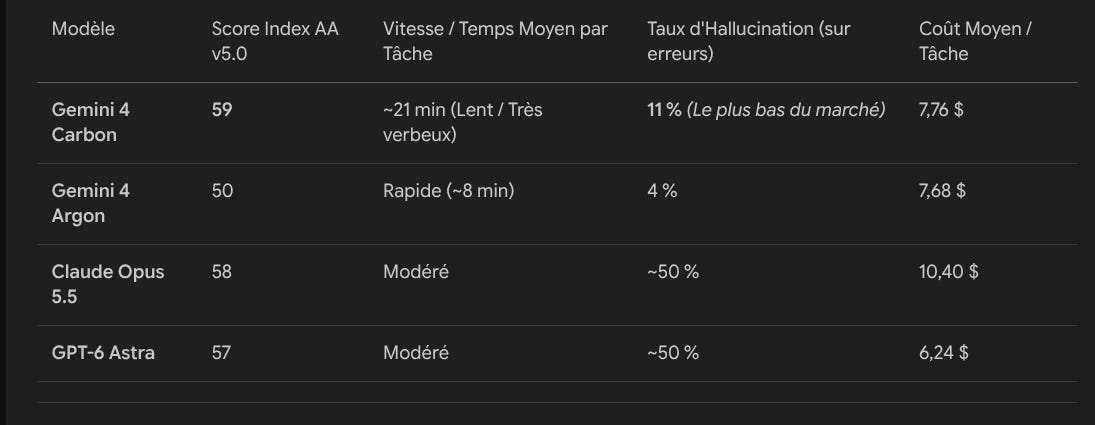
Taux d’hallucination sur les erreurs en hausse : Sur le test de connaissances d’Artificial Analysis, si sa précision globale grimpe (de 48 % à 58 %), son taux d’hallucination sur les réponses fausses passe de 4 % (sur Argon) à 11 %. Lorsqu’il se trompe, Carbon a désormais davantage tendance à inventer une réponse plausible qu’à admettre son ignorance.
Un chiffre à contextualiser : Ce taux de 11 % reste toutefois le plus faible du marché (comparé aux ~50 % d’hallucinations enregistrés chez Claude Opus 5.5 et GPT-6 Astra sur ce même test).
Score combiné net : Au score final (qui valorise les bonnes réponses tout en pénalisant la fabrication de faits), Carbon conserve la 1ère place mondiale avec 54 points contre 48 pour Opus 5.5. Les tests internes de Google indiquent par ailleurs que Carbon produit deux fois moins d’affirmations non étayées qu’Argon dans un cadre d’entreprise.
Tableau comparatif des modèles leaders
Enseignement n°5 : Une forteresse numérique imbattable contre le hacking
Si Google maintient Carbon sous clé, c’est avant tout en raison de ses capacités inédites en cybersécurité. Un système capable de détecter et corriger les failles les plus complexes possède par définition les compétences pour les exploiter à des fins offensives.
Sur les trois piliers de la cyberdéfense, Carbon établit de nouveaux récords :
Détection des vulnérabilités réelles : 88,2 % de réussite.
Démonstration de faisabilité d’exploitation (exploit) : 54,8 %.
Rédaction de correctifs de sécurité (patches) : 71 %. L’équipe Google Chrome signale à ce sujet que Carbon s’est révélé 10 fois plus efficace pour rédiger des correctifs de sécurité de haute qualité que le modèle frontal concurrent Whiz.
Dans le cadre du projet Scan for Good de Google Cloud Security, Carbon a pris la tête des tests de piratage éthique de sites web. Face aux attaques par injection de prompts (qui consistent à insérer des instructions cachées pour détourner l’IA), Carbon s’est montré hermétique. Sur le benchmark de sécurité Grey Swan (autorisant jusqu’à 15 tentatives d’attaque par injection), le taux de réussite des attaquants contre Carbon a été de 0 % (contre 0,7 % pour Argon, 1 % pour Opus 5.5 et 8,5 % pour GPT-6 Astra).
Alignement comportemental et gestion de l’ambiguïté
Google met en avant l’« honnêteté » de son modèle : sur Terminal Bench 4.0, le taux de triche réussie pour contourner les règles du test a chuté à 0 %. Au sein des équipes internes de développeurs chez Google, les alertes pour comportement déviant ont baissé de 80 %, le non-respect des consignes a chuté de 26 % et les sous-performances de 29 %.
Lorsqu’il est confronté à une requête ambiguë ou incomplète, Carbon adopte un comportement inédit : au lieu de deviner à l’aveugle, il intègre directement des réserves dans son rendu, s’interrompt pour lister précisément les informations manquantes ou signale les contradictions entre ses sources avant d’agir.
Modalités de déploiement progressif
Conformément à ses engagements auprès du programme de tests volontaires avant déploiement du gouvernement américain, Google applique une stratégie d’accès restreint :
Phase 1 (Actuelle) : Accès réservé à un groupe restreint d’organisations de cyberdéfense.
Phase 2 : Ouverture aux partenaires de confiance via le programme Fairwin.
Phase 3 : Accès élargi aux entreprises, développeurs et au grand public (aucune date officielle n’a été communiquée).
Enseignement n°6 : La frustration des développeurs et le syndrome de la « petite amie imaginaire »
Sur le plan économique, Carbon est proposé au tarif promotionnel d’Argon : 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie (avec 95 % de réduction sur les tokens déjà mis en cache). À l’issue de cette période de lancement, les prix passeront à 4 $ / 20 $, s’alignant sur la grille tarifaire standard de Claude Opus 5.5.
En raison de sa verbosité, le coût moyen d’exécution par tâche s’établit à 7,76 $. Cela classe Carbon au 45e rang sur 51 modèles en matière de coût selon Artificial Analysis. Ce tarif reste environ 23 % plus abordable que les tâches d’agents exécutées sur Claude Opus 5.5 (environ 10,40 $), mais demeure plus élevé que celui de GPT-6 Astra (6,24 $).
Toutefois, la rancœur de la communauté des développeurs sur des espaces comme Hacker News ne porte pas sur le prix, mais sur la politique d’accès. La répétition d’annonces spectaculaires concernant des modèles bloqués derrière des listes d’attente génère une lassitude visible. Beaucoup soulignent qu’au moment où Carbon sera accessible à tous, OpenAI et Anthropic auront probablement lancé leurs architectures de génération suivante.
Un utilisateur a résumé ce sentiment général à travers une métaphore devenue populaire :
« Google ressemble aujourd’hui à un mec qui n’arrête pas de vanter les mérites de sa petite amie, sauf qu’elle va dans une autre école et que personne ne l’a jamais rencontrée. »
Une démonstration de force qui doit encore faire ses preuves
Avec Gemini 4 Carbon, Google réalise une démonstration de force indiscutable sur le plan technique. En occupant simultanément les premières places mondiales en raisonnement, mémoire contextuelle longue, adaptabilité d’agent et cybersécurité, la firme de Mountain View prouve sa capacité à concevoir l’état de l’art de l’intelligence artificielle.