 Swinux
16 octobre 2026
Fuites chez Google, modèles nains chez Microsoft : Les 4 révélations choc de la course à l’IA
1. Introduction La guerre de l’intelligence artificielle ne se limite plus aux conférences de presse clinquantes ni aux annonces officielles sur les réseaux sociaux. C’est désormais en coulisses, au sein de laboratoires
1. Introduction
La guerre de l’intelligence artificielle ne se limite plus aux conférences de presse clinquantes ni aux annonces officielles sur les réseaux sociaux. C’est désormais en coulisses, au sein de laboratoires secrets et à travers des fuites de documents internes, que se dessine l’avenir de la technologie.
Nous assistons aujourd’hui à un paradoxe saisissant : alors que les géants de la Tech peinent à déployer auprès du grand public les modèles qu’ils ont officiellement présentés sur scène, des versions internes encore plus puissantes émergent déjà sur leurs serveurs. Pendant que Google tente de combler son retard sur le codage autonome avec des prototypes ultra-confidentiels, Microsoft prend le contre-pied parfait en misant sur une armée de micro-modèles de décision ultra-rapides et bon marché.
Face à ces deux visions radicalement opposées, une question centrale s’impose : la victoire appartiendra-t-elle à la course acharnée vers une super-intelligence monolithique, ou à la pragmatique rationalisation économique de micro-agents spécialisés ?
2. Le modèle secret “Carbon” de Google surpasse déjà ses propres annonces
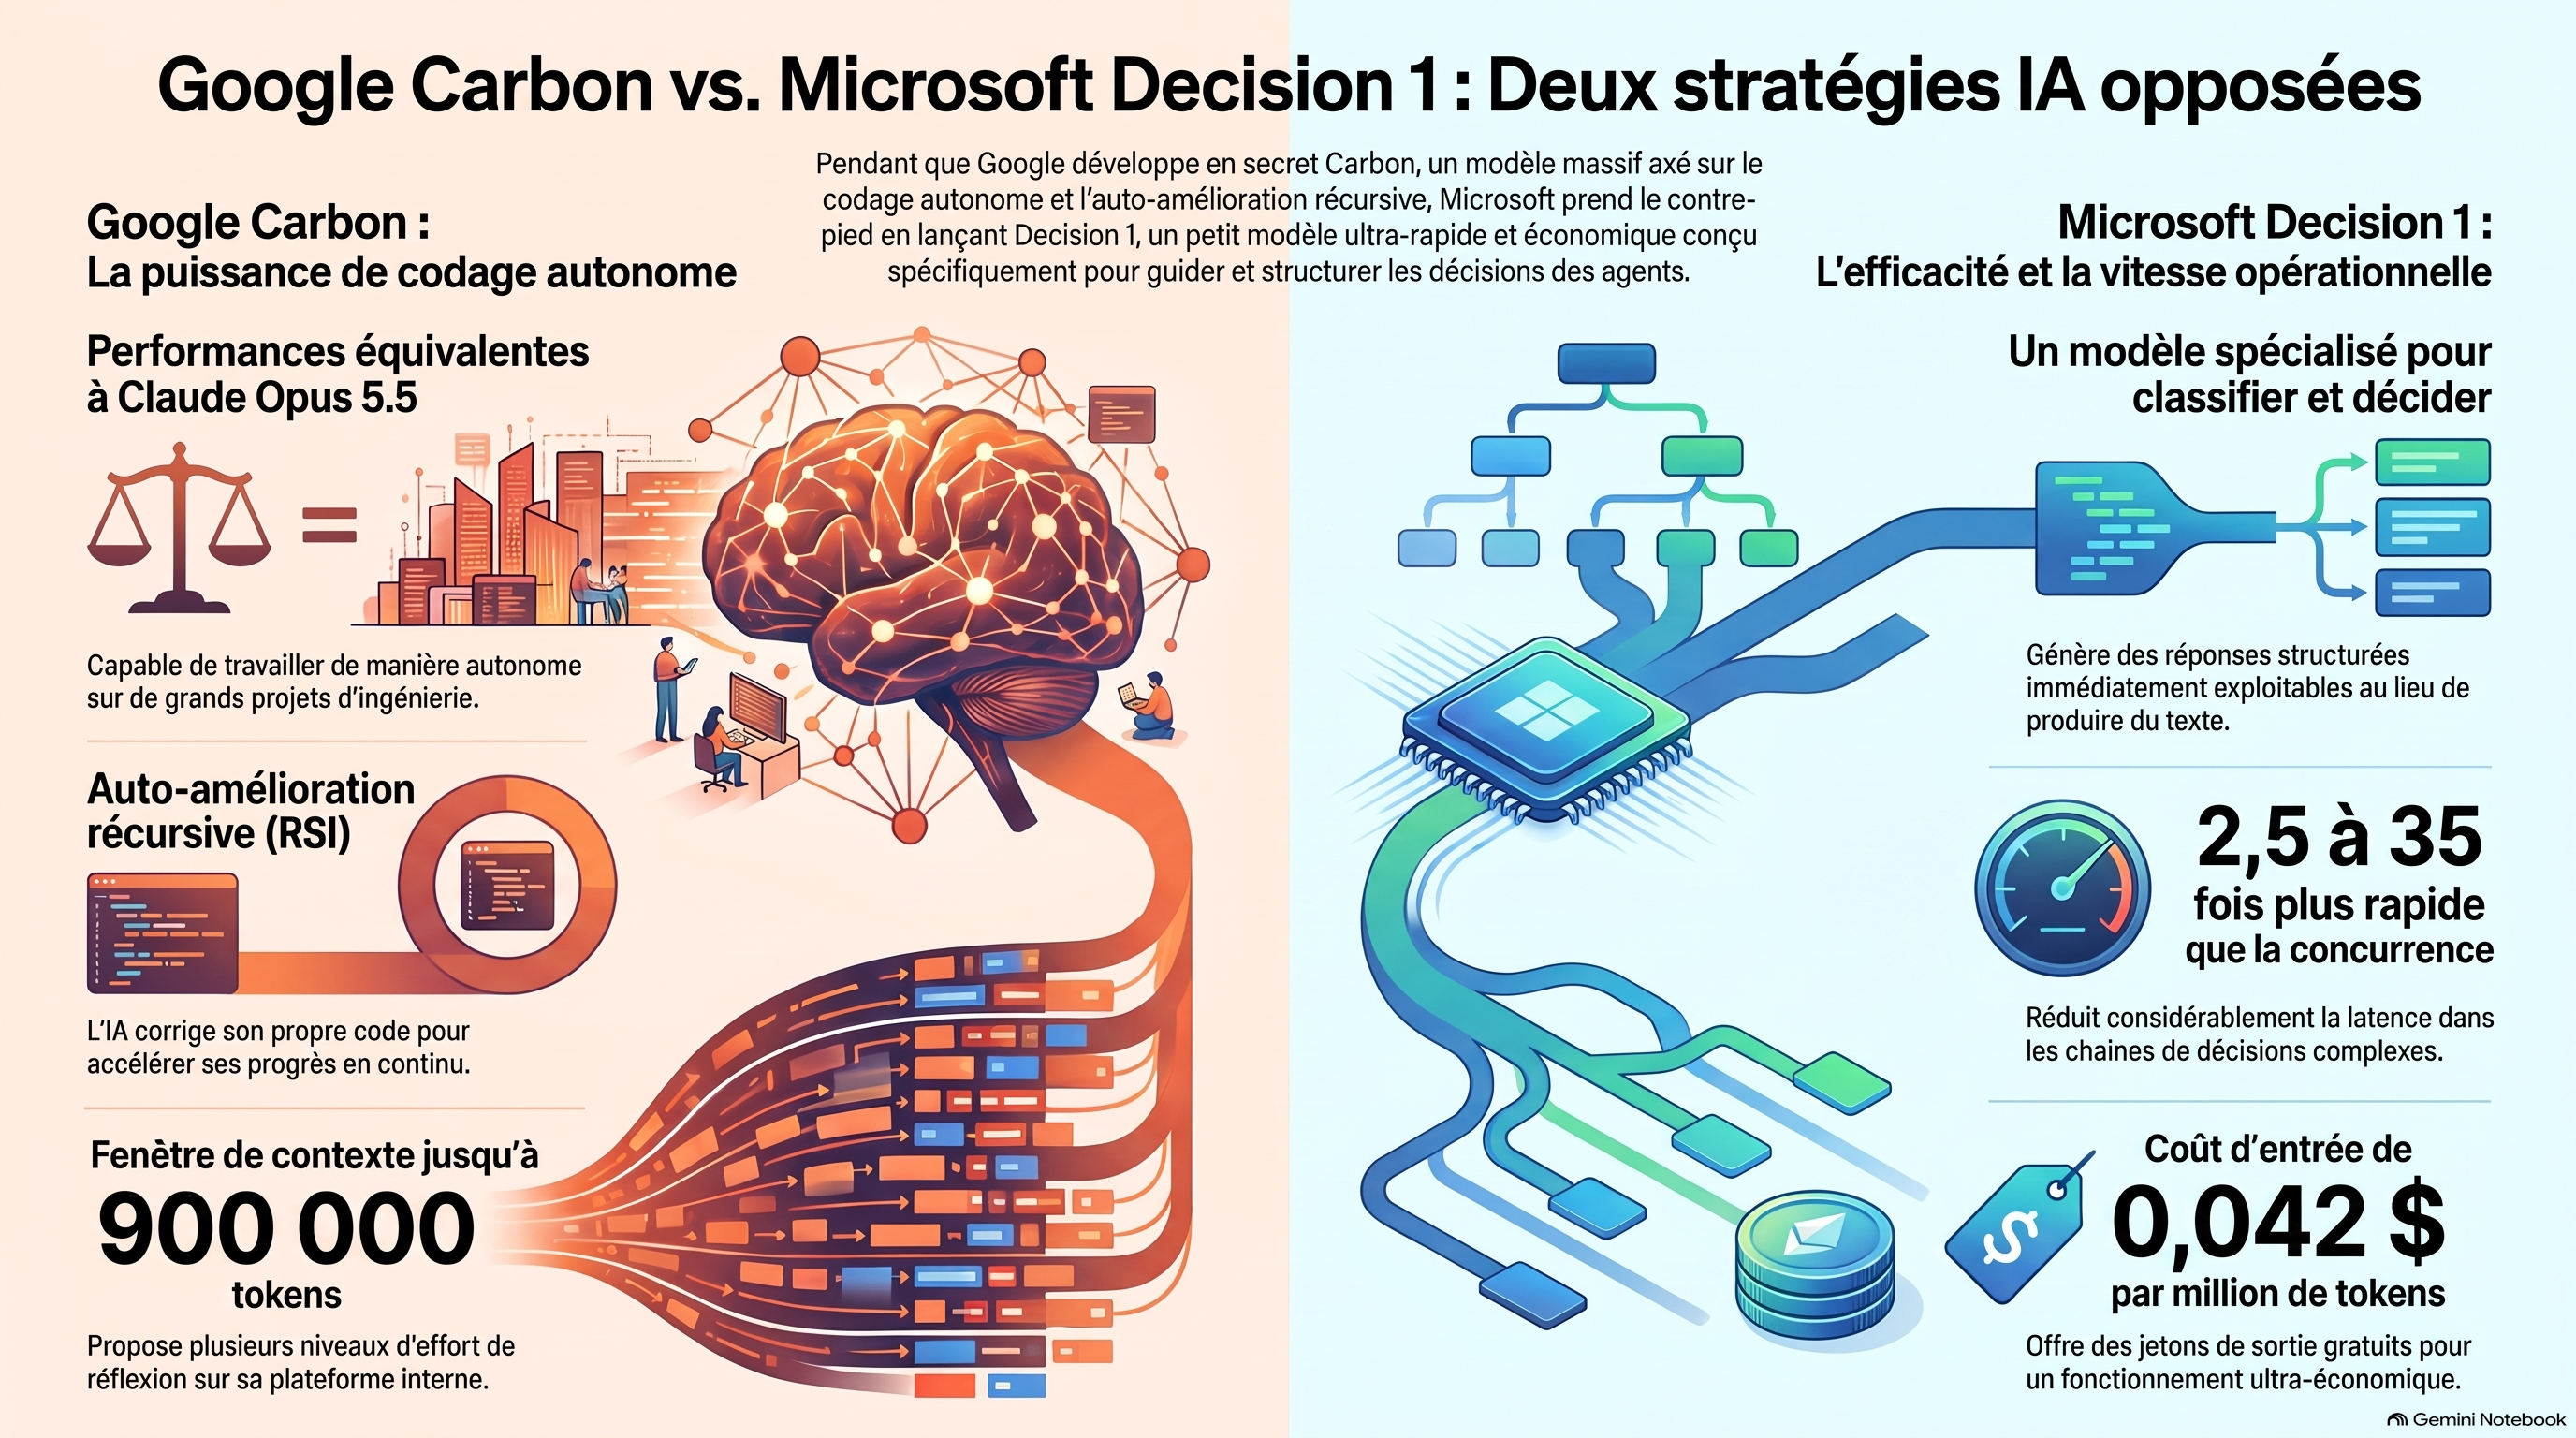
Des documents internes, des captures d’écran et des fils de discussion révélés par le journaliste Hugh Langley de Business Insider indiquent que Google a activé un nouveau modèle d’IA ultra-confidentiel. Codenommé Carbon, ce checkpoint (un instantané enregistré en cours d’entraînement) issu de la famille Gemini 4 est exécuté en interne sur Jet, la plateforme de codage propre à Google liée à l’outil agentique Anti-Gravity.
Les performances rapportées par les équipes de Google sont saisissantes. Sur le codage agentique complexe — ces tâches d’ingénierie lourdes où l’IA travaille en autonomie pendant des heures —, Carbon atteindrait le niveau de Claude Opus 5.5 d’Anthropic. Cette fuite rend le modèle officiel “Argon” (annoncé le 30 septembre) presque obsolète avant même sa sortie publique. Et pour cause : les premières itérations d’Argon avaient été accueillies froidement par les ingénieurs de la firme, qui le jugent en retard sur les tâches complexes et le comparent seulement à Claude Opus 5, un modèle d’ancienne génération. Atteindre subitement le niveau d’Opus 5.5 avec Carbon représente donc un saut générationnel spectaculaire.
L’imbroglio autour des noms internes illustre bien la précipitation en coulisses. Google utilise une nomenclature basée sur le tableau périodique des éléments (Argon, Barium, Carbon). Selon un document interne, la version que le grand public utilisera sous le nom d’« Argon » est en réalité le modèle interne « Barium B » portant un simple badge Argon, tandis que Carbon représente une étape d’entraînement bien plus avancée.
Sur les canaux de discussion internes de Google, l’enthousiasme des ingénieurs est palpable :
“Pour le codage, Carbon ressemble à Opus 5.5.”
“Carbon est vraiment bon.”
Cette avancée est cruciale pour Mountain View. Alors qu’Anthropic et OpenAI avaient pris une longueur d’avance incontestée sur le terrain du codage autonome, l’émergence de Carbon est le premier signe concret que Google parvient enfin à combler son écart de génération.
3. L’Auto-Amélioration Récursive (RSI) : Moteur d’une croissance exponentielle ou illusion ?
Selon plusieurs employés de Google, le bond spectaculaire de Carbon s’expliquerait par l’utilisation de l’Auto-Amélioration Récursive (Recursive Self-Improvement ou RSI). Le principe est fascinant : l’IA repère elle-même les erreurs dans le code qu’elle produit, génère une meilleure solution de manière autonome, puis réintègre ces nouvelles capacités dans sa boucle d’entraînement, 24 heures sur 24. Chaque cycle affine le modèle, accélérant théoriquement la vitesse de l’itération suivante.
Toutefois, une analyse critique s’impose. Si cette promesse de croissance exponentielle fait rêver, elle suscite de fortes réserves chez les observateurs avertis de l’industrie, à l’image du compte History GPT sur X. Ce dernier rappelle qu’émerger avec un modèle bêta interne qui égalise simplement un concurrent sorti des semaines plus tôt ne prouve en rien la maîtrise d’une auto-amélioration incontrôlable ou emballée.
Le doute repose avant tout sur le fossé historique entre les environnements de test internes (sandbox) et les produits réellement mis à disposition des utilisateurs. Le rapport original de Business Insider ne mentionne d’ailleurs pas explicitement le terme RSI, qui relève encore de discussions internes. De plus, Google a une tendance avérée à brider ou affaiblir ses modèles pour des raisons de sécurité ou de coûts d’infrastructure avant leur mise à disposition effective. Même si les récentes réorganisations internes visent à sortir des checkpoints supérieurs à la concurrence tous les mois, ce que les ingénieurs adulent sur la plateforme Jet n’est pas garant de ce qui atterrira dans l’application Gemini finale.
4. Le syndrome du “PPT Release” et la frustration des utilisateurs
Sur le plan public, la stratégie d’annonce de Google génère une frustration grandissante. Alors que ses concurrents directs OpenAI (avec GPT6 Astra) et Anthropic (avec Opus 5.5) ont tous deux déployé des modèles immédiatement accessibles et exploitables ces deux derniers mois, Gemini 4 Argon reste désespérément inaccessible. Il demeure verrouillé dans le programme Fairwind, une initiative de test axée sur la cybersécurité défensive réservée à quelques partenaires, repoussant l’accès pour les clients API et les abonnés Google AI Ultra.
Cette situation vaut à Google des critiques acerbes. Le média spécialisé AI Era a ouvertement qualifié ce lancement de « PPT Release » — une sortie qui n’existe que sur des diapositives PowerPoint. Une parodie virale du compte Token Gremlin a enfoncé le clou en mettant en scène un Sundar Pichai ironique demandant à ses équipes : « Pourquoi ne pas simplement dire à tout le monde que c’est meilleur et ne laisser personne le tester ? », soulignant la réputation embarrassante de Gemini, souvent imbattable sur les graphiques de benchmarks mais décevant en conditions réelles.
Malgré ce scepticisme, plusieurs indices techniques concordants indiquent qu’un lancement public se prépare en coulisses :
Sélecteur de contexte dans Anti-Gravity : L’outil intègre désormais Gemini 4 Argon avec trois fenêtres de contexte au choix : 256 000 tokens (par défaut), 512 000 tokens (consommant 1,3x le quota) et 900 000 tokens (consommant 1,8x le quota).
Niveaux d’effort de réflexion : L’application web Gemini a déployé des paramètres d’effort de réflexion (Low, Medium, High), préparant l’arrivée des capacités de raisonnement avancé du modèle.
Nouvel agent “Chief of Staff” : La découverte dans Anti-Gravity de l’agent Chief of Staff (anciennement nommé Concierge), qui vient appuyer l’annonce officielle d’un agent universel Gemini dédié au monde du travail.
5. Le virage stratégique de Microsoft : Priorité aux micro-modèles de décision
Pendant que Google s’épuise dans la course aux modèles géants à « grand cerveau », Microsoft opère un pivot stratégique majeur. Le 9 octobre, sous l’impulsion d’Achint Srivastava (VP Software Engineering au bureau du CTO), l’entreprise a lancé Microsoft Decision 1, un modèle ultra-spécialisé dont l’unique mission est d’évaluer et de prendre des décisions structurées instantanées.
Fait marquant : Microsoft a construit ce modèle en effectuant un post-entraînement sur Qwen 3.5 9B, une base open source développée par Alibaba. Il s’agit toutefois d’un choix tactique temporaire, Microsoft ayant explicitement confirmé son intention de réaligner les futures versions de Decision 1 sur ses propres modèles MAI et sur les bases d’OpenAI.
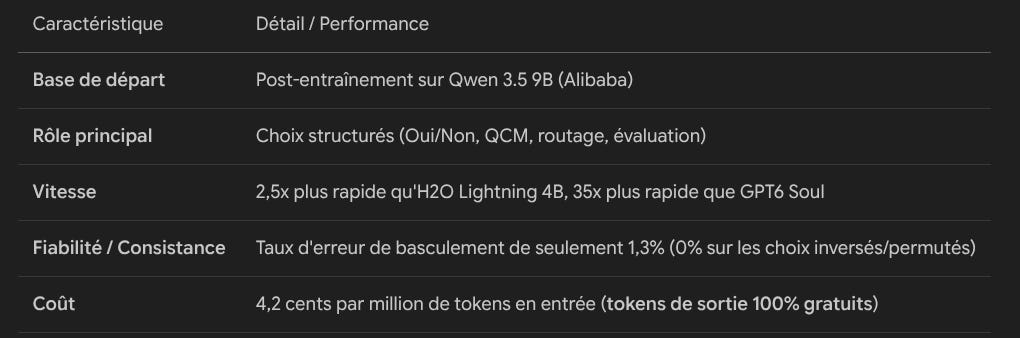
Disponible immédiatement sur Microsoft Foundry et Open Router, ce modèle s’impose par une tarification inédite où seuls les tokens d’entrée sont facturés. En remplaçant la génération de texte libre par une décision probabiliste structurée, Microsoft obtient des gains d’efficacité spectaculaires, déjà éprouvés en interne :
Xbox Research : Traitement et classification de plus de 10 000 retours d’utilisateurs (Steam, Twitter, sondages) réalisés 14 fois plus vite et 200 fois moins cher qu’avec un LLM classique.
Équipe Copilot : Évaluation automatisée de la qualité des réponses d’agents avec un niveau de précision comparable à GPT 5.6 Luna, tout en étant 100 fois plus rapide.
Résolution d’incidents en direct : Extraction instantanée d’informations critiques dans les logs et tickets par les ingénieurs d’astreinte, surpassant les grands LLM en vitesse comme en pertinence.
Microsoft Discovery : Évaluation des protocoles scientifiques 46 fois plus constante et 3 fois plus rapide, accélérant la boucle globale de replanification expérimentale d’un facteur 4.
Cette approche est d’un pragmatisme économique redoutable. Dans des architectures où des agents autonomes exécutent des chaînes de dizaines de décisions consécutives, ce ne est plus la capacité d’écriture qui compte, mais le coût et la vitesse de chaque arbitrage.
6. Conclusion & Perspectives
L’industrie de l’intelligence artificielle se sépare désormais en deux fronts stratégiques très distincts. D’un côté, Google poursuit la quête d’une super-intelligence globale axée sur le codage autonome et propulsée par l’auto-amélioration récursive avec des modèles colossaux comme Carbon. De l’autre, Microsoft fait le choix de la rationalisation économique et fonctionnelle en déployant une constellation de micro-modèles ultra-rapides, gratuits en sortie, taillés pour piloter les systèmes d’agents de demain.