 Swinux
28 octobre 2026
DeepSeek v4.1 Flash et l’IA chinoise : Le séisme open-source qui secoue les géants de la Silicon Valley
1. Introduction : Le braquage du week-end Pendant que la Silicon Valley dormait sur ses certitudes et ses investissements colossaux en GPU, l’écosystème chinois de l’intelligence artificielle préparait dans l’ombre une o
1. Introduction : Le braquage du week-end
Pendant que la Silicon Valley dormait sur ses certitudes et ses investissements colossaux en GPU, l’écosystème chinois de l’intelligence artificielle préparait dans l’ombre une onde de choc majeure. Le samedi 17 octobre — un jour totalement inhabituel pour le laboratoire basé à Hangzhou, qui ne publie quasiment jamais le week-end —, DeepSeek a discrètement mis en ligne la mise à jour « v4.1 Flash 1017 ». En apparence, une simple incrémentation datée. En réalité, un coup de maître stratégique.
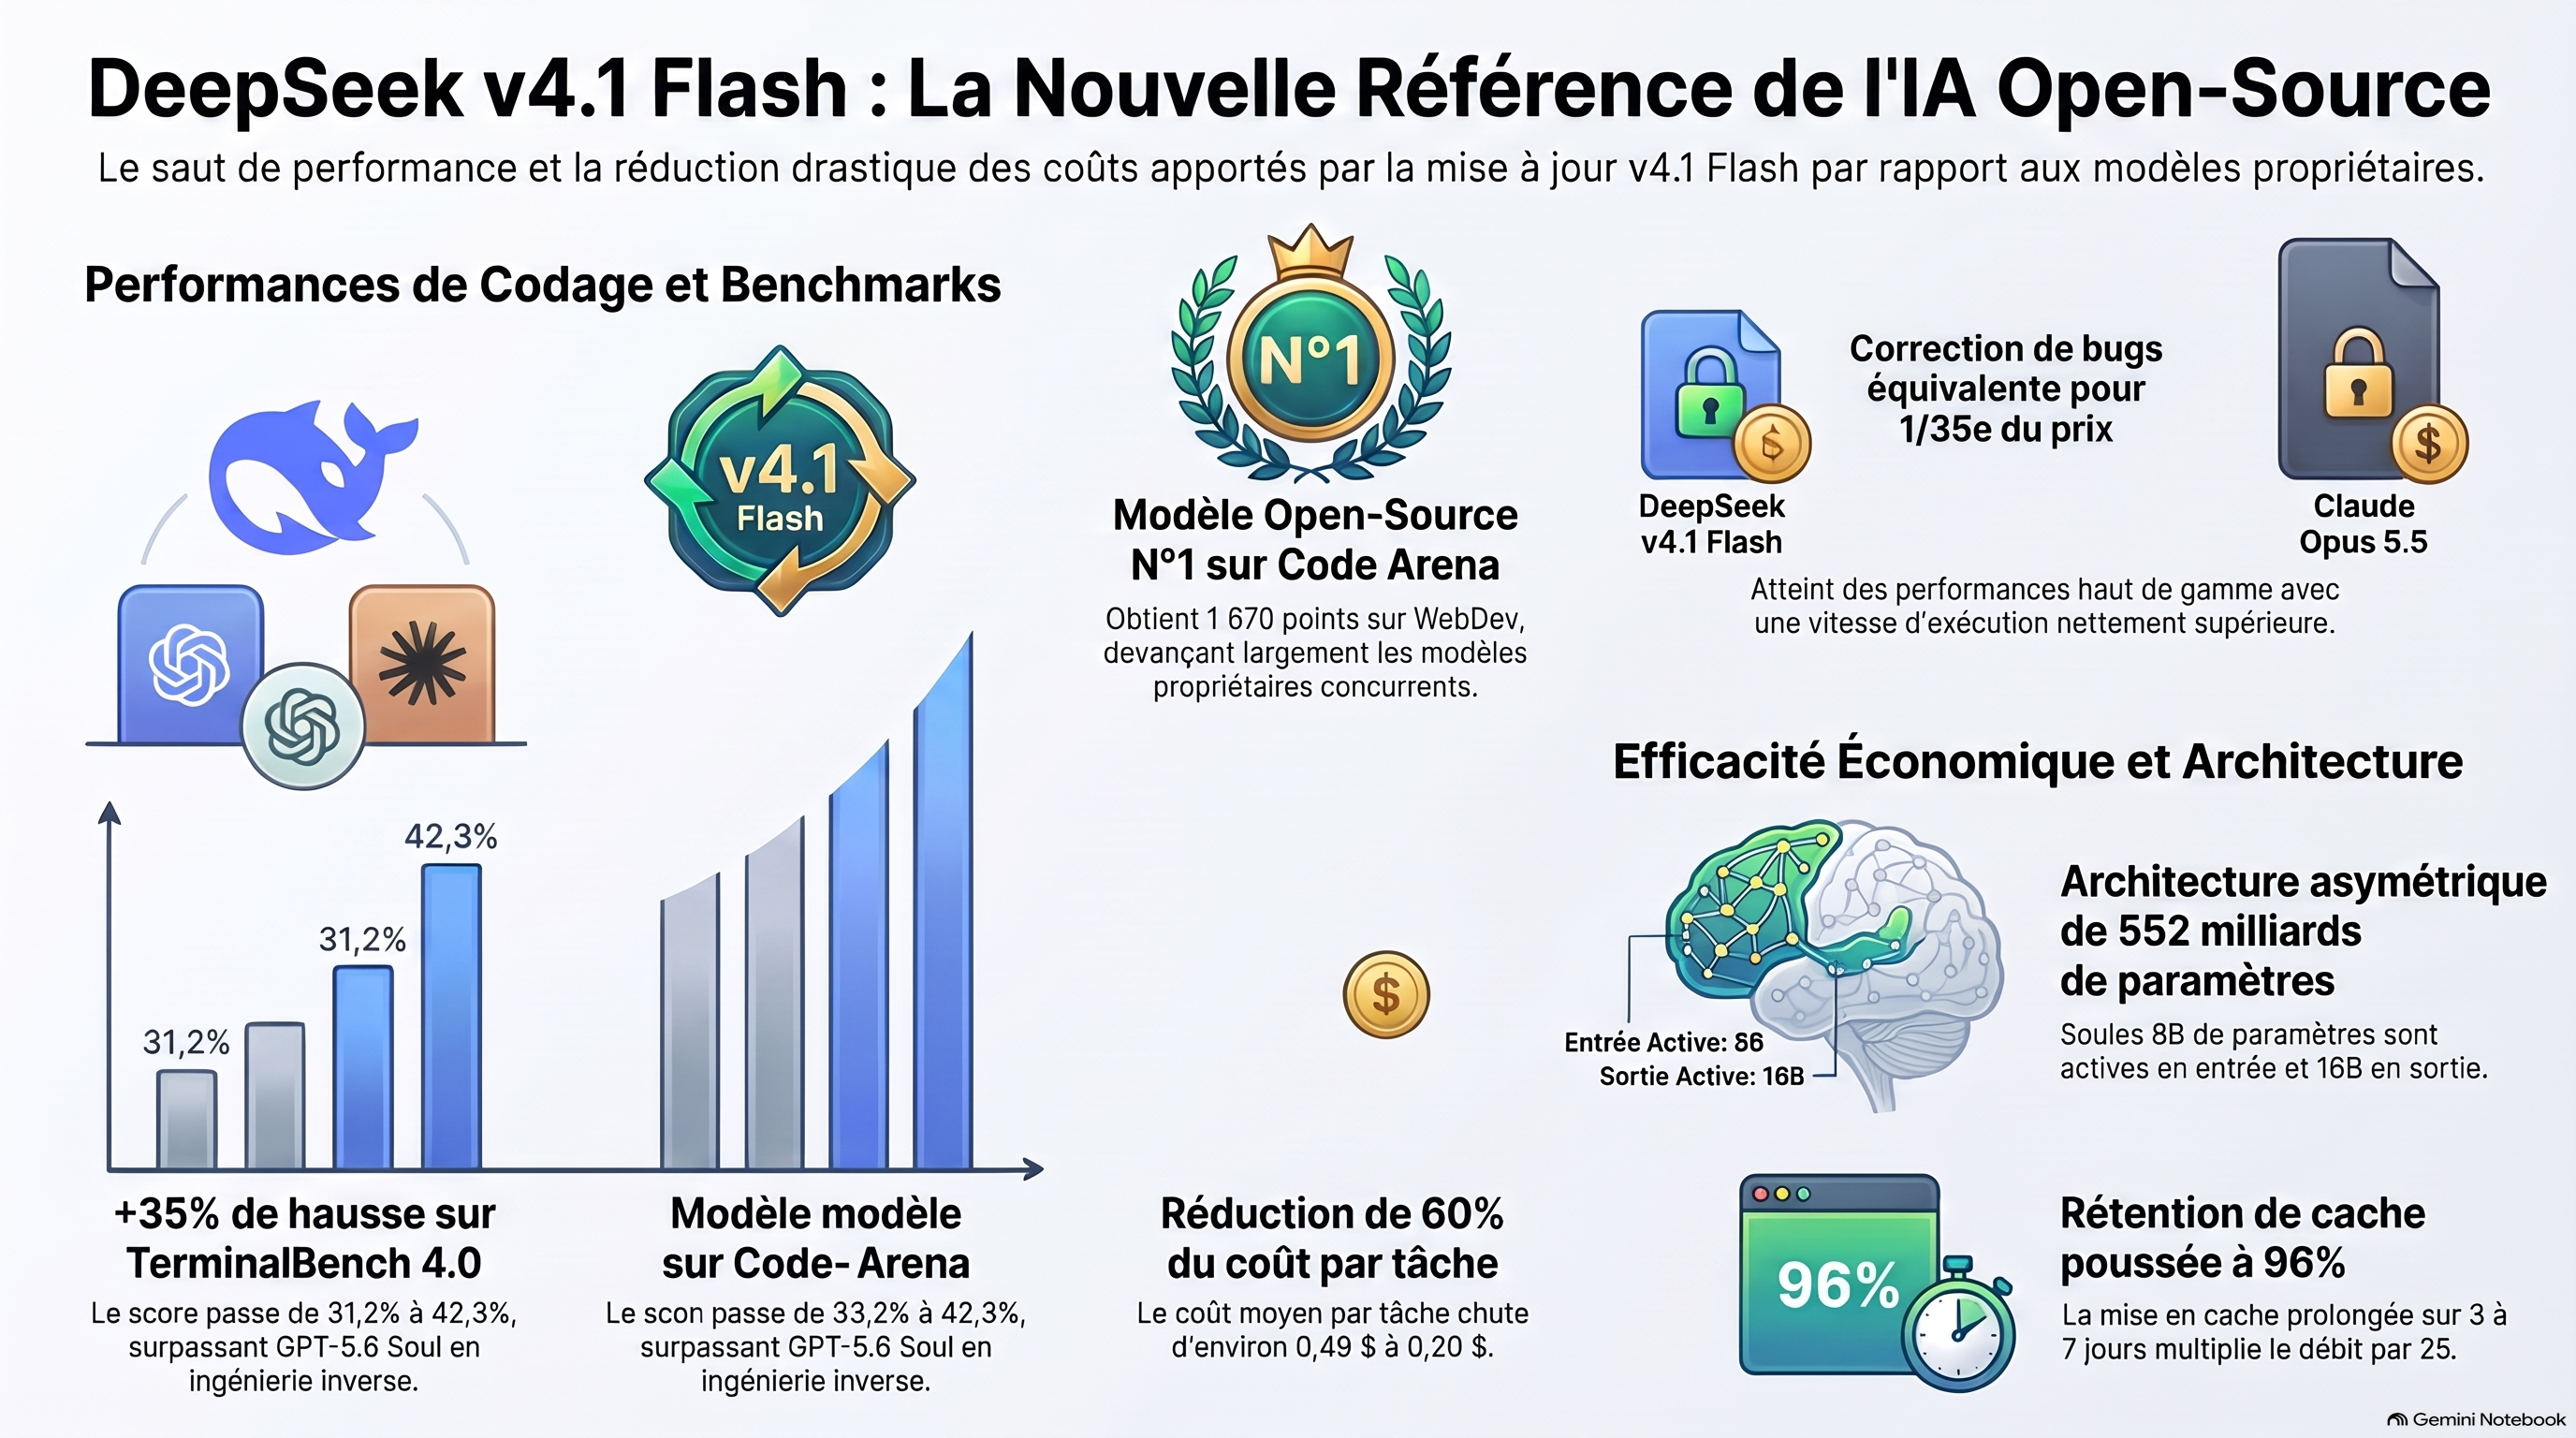
Dès le lundi midi, la planète tech s’embrasait : plus de 582 000 publications déferlaient sur X (ex-Twitter) et des dizaines de milliers de fils de discussion inondaient les plateformes de développeurs. En l’espace de quelques heures, le modèle écrasait la concurrence sur les classements mondiaux de codage et d’agents autonomes. Sur le benchmark TerminalBench 4.0, la v4.1 Flash bondissait de 31,2 à 42,3. Sur ProgramBench (qui évalue l’ingénierie inverse), elle grimpait de 20,3 à 29,1, battant GPT-5.6 Soul sur neuf tests clés et devançant Claude Opus 5 sur DeepSWE, Agents Last Exam et APEX Bench.
Comment un correctif du week-end a-t-il pu redéfinir les standards mondiaux du codage automatisé, terrasser les modèles propriétaires américains et diviser par deux les coûts de développement ? Analyse en 5 points d’un séisme industriel.
2. Point 1 : La « Kill Line » du codage – Des performances de pointe à un centième du prix
Sur le benchmark DeepSWE (version 1.1), les analystes ont rapidement identifié ce qu’ils appellent désormais la « Kill Line » : une courbe de performance dévastatrice où le nouveau modèle atteint un pic de réussite de 77 % (contre 74 % pour la v4.1 Flash précédente et 63 % pour v4 Pro) pour seulement 1,3 yuan par tâche. Concrètement, le coût moyen d’une résolution de bug est passé de 0,49 $ à environ 0,20 $ (soit près de 60 % de réduction). Face aux dizaines de yuans réclamés par les modèles occidentaux pour tenter d’approcher ce niveau, le calcul est vite fait. Quand l’expert Pavel Hurin a constaté que le modèle égalait presque Claude Opus 5.5 xhigh en correction de code pour un 35ème du prix, la réaction de la communauté ne s’est pas faite attendre :
“Rename it v4.2 pro.”
Mais ce bond technologique ne s’arrête pas aux métriques brutes : il concrétise le concept de « Wish-Based Programming » (la programmation basée sur le souhait). L’utilisateur s’affranchit du cahier des charges rigide pour exprimer une simple intention créative, laissant l’agent concevoir la structure, rédiger le code, gérer les dépendances et exécuter le programme de manière autonome. Les démonstrations publiées font sensation :
Le bus spatial sur ruban de Möbius : Un mini-jeu 3D où le véhicule serpente sur un ruban de Möbius inversant le pare-brise, le décor et les étoiles ; un premier tour laisse le joueur la tête en bas, le second le remet à l’endroit.
La génération audiovisuelle 100 % code : Des vidéos pédagogiques entièrement synthétisées par le code, comme l’histoire de la Terre en 13 chapitres (2 min 30) ou le voyage d’un grain de sel à Yangpu (2 min), incluant visuels animés, sous-titres, voix de synthèse et ambiance sonore.
Des prototypes interactifs saisissants : Une ville côtière en papier découpé qui se déplie au défilement de la page avec un contrôle temporel de la lumière, un remake sous Godot de Portal 2, ou encore un jeu de course en navigateur généré en une seule invite.
Sur le plan stratégique, cette chute tarifaire n’est pas qu’une aubaine financière : c’est le carburant indispensable des boucles d’auto-inspection (« recursive self-improvement »). En s’appuyant sur des environnements d’entraînement comme le sandbox DSAC, l’agent peut désormais rejouer ses sessions, vérifier son propre travail face aux exigences initiales et corriger ses bugs en boucle sans ruiner les développeurs à chaque appel d’API.
3. Point 2 : L’attaque furtive sur le marché de la recherche web (bye-bye Google et Tavily)
Pendant que l’attention se focalisait sur les prouesses de codage, DeepSeek a mené une offensive parallèle en intégrant directement au cœur de son modèle sa propre API de recherche web interne (organisée autour des fonctions Search et Fetch). La fonction Search renvoie un JSON structuré enrichi de scores de re-classement et d’autorité, tandis que Fetch convertit à la volée n’importe quelle page web en Markdown épuré.
La prouesse technique réside dans le filtrage natif : l’API élimine automatiquement le spam SEO, les fermes de contenu générées par IA et les manipulations géographiques. Là où Google s’appuie sur son propre moteur historique, OpenAI sur Bing, et où Anthropic est démuni d’infrastructure de recherche publique, DeepSeek offre une solution intégrée et indépendante.
C’est sur le terrain économique que le coup de massue tombe :
DeepSeek Search API : 5 yuans (~0,75 $) pour 10 000 requêtes réussies (les échecs, requêtes vides ou timeouts sont gratuits).
Tavily : ~8 $ pour 1 000 requêtes.
Exa : 4 $ à 15 $ pour 1 000 requêtes.
Serper : ~5 $ pour 1 000 requêtes.
Brave / Google Custom Search : ~5 $ pour 1 000 requêtes.
En intégrant discrètement et gratuitement ce service en arrière-plan dans des environnements d’agents comme Claude Code, CodeBuddy ou Codex avant d’activer sa grille tarifaire dérisoire, DeepSeek orchestre une guerre sur deux fronts : la domination des modèles LLM d’un côté, et la préemption de l’infrastructure de recherche pour agents de l’autre.
4. Point 3 : Le paradoxe Coca-Cola – Pourquoi open-sourcer son infrastructure “DeepInfer” ?
Nouveau coup de théâtre : DeepSeek a publié en open-source, sous licence Apache 2.0, son moteur d’inférence DeepInfer ainsi que sa bibliothèque DeepSeek Recipe. DeepInfer optimise l’exécution du modèle sur les GPU Nvidia SM100 et les NPU Huawei Ascend 950 en combinant décodage spéculatif, parallélisme distribué et planification asynchrone, tandis que Recipe bloque les injections d’invites au niveau du tokenizer.
Pourquoi dévoiler ses secrets industriels ? C’est le paradoxe Coca-Cola. Lorsque la formule de la célèbre boisson a fuité dans la presse en 2011, les ventes de l’entreprise n’ont pas fléchi. Pourquoi ? Parce que le véritable avantage concurrentiel de Coca-Cola ne résidait pas dans la liste de ses ingrédients, mais dans sa puissance de distribution, sa marque et son réseau logistique. En intégrant ses API de recherche et ses tokens directement au cœur des outils occidentaux, DeepSeek applique exactement la même méthode : poser son distributeur Coca-Cola directement dans le magasin de son concurrent.
Les métriques d’exploitation internes affichées par la firme confirment une maîtrise technique hors norme :
Capacité phénoménale : 155 trillions de tokens servis par jour sur un seul cluster.
Rétention de cache extrême : Les données sont conservées 3 jours pour les agents et 7 jours pour le chat sur leur cluster 3FS. Alors que les géants occidentaux (OpenAI, Anthropic, Google) réinitialisent leurs caches après 5 minutes à 24 heures, DeepSeek atteint un taux de rétention de cache de 96 %, multipliant le débit global par 25.
Rentabilité brute : Une marge brute d’infrastructure estimée à 82 % (générant 38 $ par GPU/heure pour un coût de location de B300 d’environ 7 $/heure).
Cette philosophie de l’ouverture rentable est parfaitement résumée par ces deux citations désormais célèbres :
“Sharing fine skills with everyone.” — Citation tirée du classique chinois Yinwenzi
“A nuclear bomb proof there’s no ai bubble.” — Commentaire capturé sur Hacker News à la vue des marges et des coûts réels
5. Point 4 : La réponse éclair de MiniMax (M3.1 Flash) – La guerre totale de l’IA en Chine
La preuve que l’écosystème chinois est devenu un réacteur à fusion technologique : DeepSeek n’a même pas eu le temps de savourer sa victoire. Dans les heures qui ont suivi, le laboratoire rival MiniMax a riposté en lançant son modèle M3.1 Flash. Il s’avère qu’il s’agissait du mystérieux « space bunny » qui accumulait anonymement plus de 200 trillions de tokens sur le classement LMSYS.
Conçu sur une architecture à attention éparse capable de dépasser les 200 tokens par seconde (avec une médiane supérieure à 170 tokens/s, soit une vitesse multipliée par trois), M3.1 Flash a immédiatement aligné des scores spectaculaires :
Zapier Automation Bench (600 tâches d’entreprise réelles) : 1er mondial avec un score de 62,8 (surpassant Claude Opus 5 à ~51, GPT-5.6 Soul à ~46 et DeepSeek à 60,5) pour à peine 0,25 yuan par tâche.
OSWorld 2.0 (tâches informatiques complexes) : Score de 61,7 contre 54,3 pour DeepSeek v4.1 Flash.
Berkeley’s Agents Last Exam (152 tâches) : Le coût d’exécution complet du benchmark s’est élevé à seulement 739 yuans avec M3.1 Flash, contre plus de 5 000 yuans pour GPT-5.6 Soul et près de 9 000 yuans pour Claude Opus 5.5.
Cette rivalité fraternelle entre acteurs chinois crée un effet de ciseau dévastateur pour les acteurs américains : une course à la performance tirée vers le haut, couplée à une effondrement continu des prix.
6. Point 5 : Le jackpot commercial – 15 milliards de dollars et un modèle rentable
Cette guerre des prix n’est pas une stratégie suicidaire financée à perte : elle s’appuie sur une rentabilité financière réelle qui tord le cou au fantasme d’une « bulle de l’IA ». DeepSeek vient en effet de clore un tour de table pharaonique de près de 100 milliards de yuans (environ 15 milliards de dollars) — révisé à la hausse après des objectifs initiaux de 50 puis 80 milliards —, emmené par des titans comme Tencent et China Telecom.
Cette réussite valide la doctrine insufflée par son fondateur, Liang Wenfeng : « engranger des profits raisonnables pour éliminer ceux qui en prennent trop ». Avec un amortissement du matériel informatique estimé à seulement 10 mois et des revenus annuels récurrents qui approchent le milliard de dollars, le tour de force est total. Plus impressionnant encore : DeepSeek génère cette manne financière en exploitant une flotte d’à peine 3 000 GPU. Une leçon d’efficience absolue donnée aux acteurs occidentaux qui alignent les dizaines de milliers de cartes sans parvenir à rentabiliser leurs infrastructures.
7. Conclusion : Vers où va l’IA mondiale ?
La mise à jour “v4.1 Flash 1017” et la riposte immédiate de MiniMax confirment un basculement géopolitique et technologique majeur. La frontière de l’innovation en intelligence artificielle ne se mesure plus uniquement à la quantité brute de puces alignées dans des datacenters énergivores, mais à l’extrême sophistication du post-entraînement, à l’optimisation agressive du cache et à l’effondrement structurel des coûts d’inférence.
En combinant architectures ouvertes, efficacité logicielle sur-mesure et modèle économique hyper-agressif, les acteurs de l’IA chinoise démontrent qu’ils peuvent battre les modèles propriétaires fermés les plus avancés de la Silicon Valley tout en étant rentables.