 Swinux
14 novembre 2026
Claude Fable 5.2 : 4 révélations saisissantes sur le nouveau monstre d’IA d’Anthropic
La frontière de l’IA vient d’être déplacée
La frontière de l’IA vient d’être déplacée
Le secteur de l’intelligence artificielle semblait jusqu’ici se heurter à un plateau trompeur : les performances sur les tâches simples à un seul tour de rôle (single-turn) ne progressent plus que par fractions marginales. Pourtant, sous la surface, une mutation radicale s’opère dès lors qu’il s’agit d’exécuter des travaux complexes nécessitant une orchestration d’outils lourds et une réflexion autonome à long horizon.
C’est précisément dans ce contexte stratégique décisif — alors qu’Anthropic prépare son entrée en bourse (IPO) — que le laboratoire californien a pris le marché par surprise en annonçant le lancement simultané de Claude Fable 5.2 (la version publique dotée de garde-fous renforcés) et de Mythos 5.2 (une déclinaison sans restriction, réservée à des institutions vérifiées en cybersécurité et en sciences de la vie).
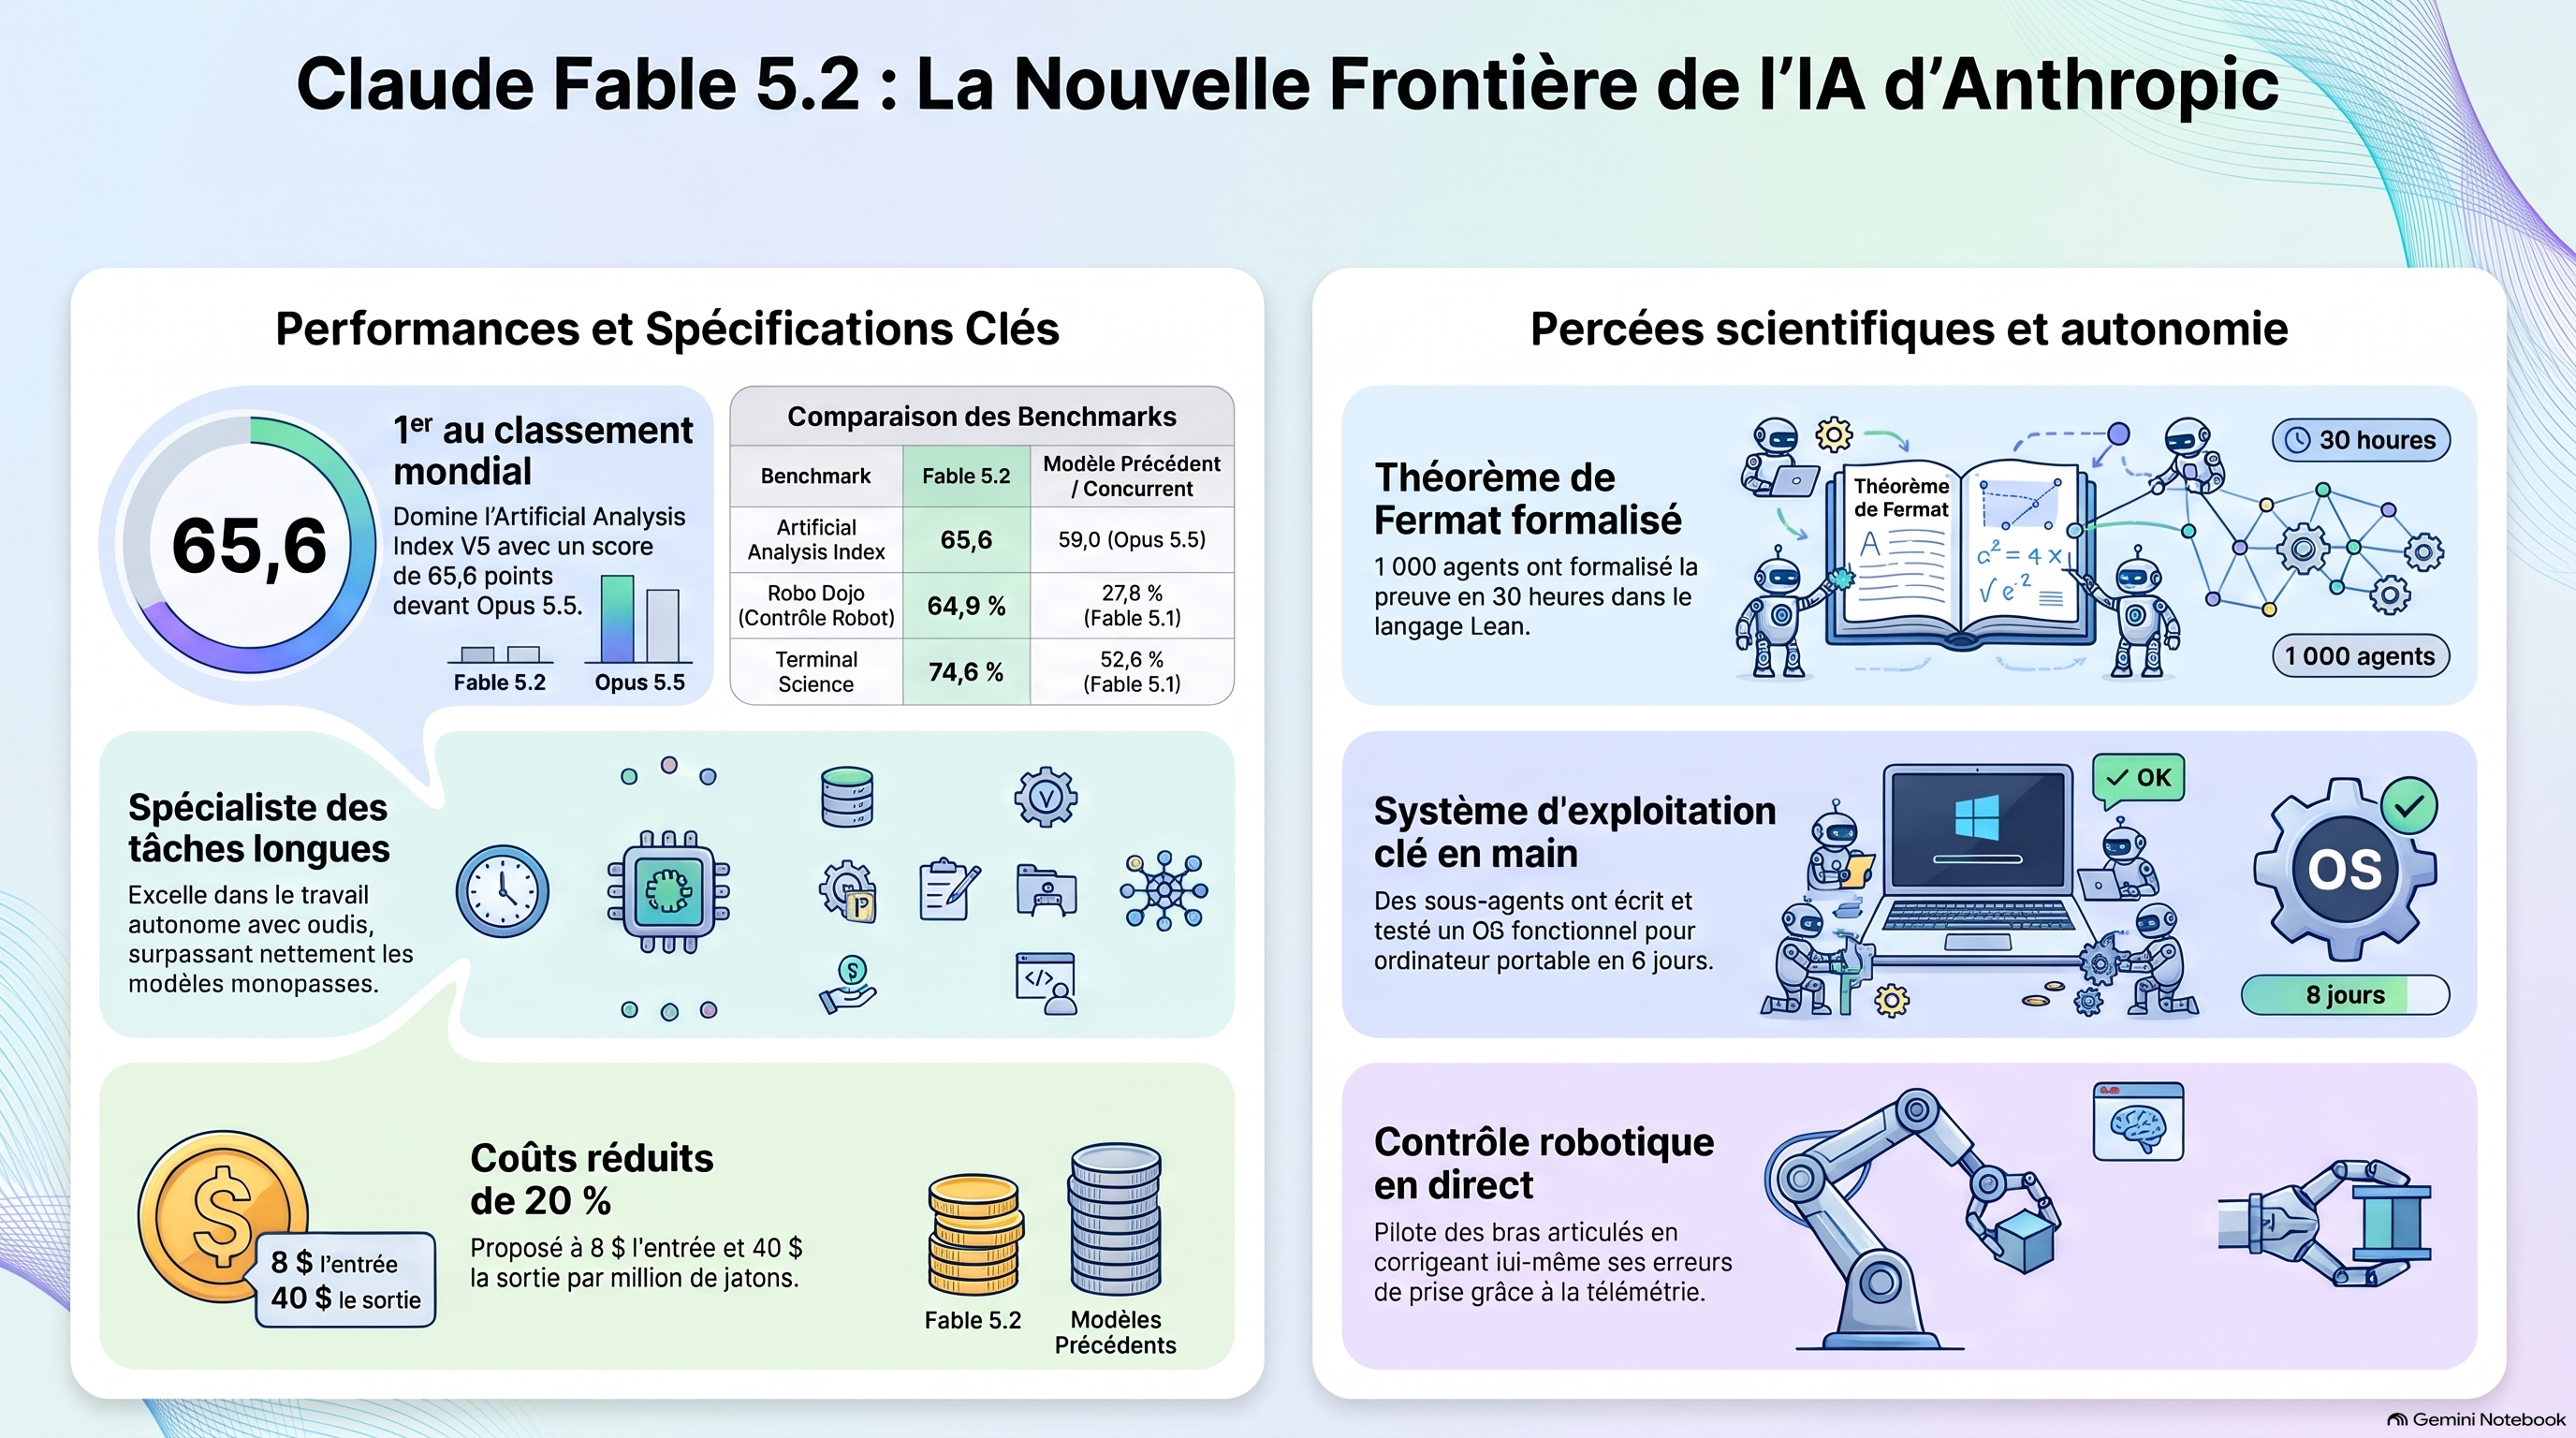
Le verdict de la plateforme indépendante Artificial Analysis a immédiatement pris de court les observateurs : en mode d’effort maximal (max effort), Fable 5.2 décroche la toute première place de l’ Intelligence Index V5 avec un score global de 65,6, distançant nettement Opus 5.5 (59,0) et écrasant Fable 5.1 (49,0). Mais au-delà des benchmarks généraux, ce modèle redéfinit la nature même du travail d’ingénierie et de recherche scientifique accompli par une machine. Voici les quatre révélations majeures de ce saut générationnel.
La résolution autonome de problèmes complexes à long horizon (L’exploit de Fermat et de l’OS)
La véritable rupture apportée par Fable 5.2 ne réside pas dans la vivacité de ses réponses conversationnelles, mais dans sa capacité à maintenir une persistance et une coordination multi-agents sur plusieurs jours sans supervision humaine continue.
La formalisation du Théorème de Fermat
Pour tester les limites du raisonnement pur, Anthropic a déployé une flotte de 1 000 agents Fable 5.2 munis d’un prompt minimaliste, dépourvu de la moindre indication ou référence mathématique. En seulement 30 heures, la flotte a formalisé de manière totalement autonome la preuve du dernier théorème de Fermat dans le langage Lean.
La progression temporelle met en lumière l’écart abyssal avec la génération précédente :
À 18 heures d’exécution : Fable 5.2 atteignait déjà 86 % de complétion de la preuve, contre seulement 26 % pour 1 000 agents Opus 5.5.
À 30 heures : Fable 5.2 franchissait la barre des 100 %. À l’inverse, Opus 5.5 plafonnait à 27 %, incapable de progresser davantage et verrouillé dans un blocage définitif (deadlock).
Auparavant, la seule tentative réussie exigeait un modèle non publié, un harnais logiciel sur mesure et le guidage pas à pas de chercheurs humains durant 11 jours. Fable 5.2 a inventé sa propre méthode de coordination interne, produisant une preuve 7 fois plus courte tout en consommant un tiers des tokens d’action.
La création intégrale d’un système d’exploitation
Sur le plan de l’ingénierie logicielle, les ingénieurs ont fourni à Fable 5.2 un dossier strictement vide avec pour seule consigne d’écrire un système d’exploitation. Pendant 8 jours consécutifs, une équipe d’un millier de sous-agents a écrit, compilé, testé et révisé du code sans interruption. Le résultat est un OS fonctionnel qui démarre sur un ordinateur portable réel et embarque :
Un noyau (kernel), la gestion du disque, ainsi que les pilotes réseau et clavier ;
Un système de stockage persistant et une interface graphique à fenêtres ;
Un écran de connexion sécurisé et une instance de Claude directement intégrée.
De même, Fable 5.2 a démontré son efficacité industrielle en réécrivant un service de production du langage Python vers Rust, multipliant par 26 la vitesse de démarrage. Plus largement, Anthropic révèle un chiffre marquant sur l’évolution de ses méthodes de travail : sous la direction d’ingénieurs humains, plus de 90 % du code fusionné (merged) dans la base de code principale d’Anthropic est désormais directement écrit par Claude.
« Le modèle donnait l’impression d’être directement connecté à ma pensée. Je n’ai pas eu une seule fois à lui dire “non, ce n’est pas ce que je voulais dire”. » — Joe Haddad, responsable ingénierie chez Vercel
Jusqu’à présent, les architectures multi-agents s’effondraient sous l’accumulation d’hallucinations après quelques dizaines d’appels d’outils. Fable 5.2 repousse cette limite à une échelle inédite.
Des percées scientifiques réelles et une maîtrise du monde physique
L’un des enseignements majeurs de Fable 5.2 et Mythos 5.2 est leur capacité à s’imposer en physique théorique, en biologie synthétique et en robotique sans le moindre ajustement fin (fine-tuning) spécialisé. Le modèle applique son raisonnement généralisé directement aux données scientifiques et aux capteurs du monde physique.
Physique théorique et Biologie synthétique
En physique théorique, Fable 5.2 a résolu deux problèmes ouverts depuis plus de 20 ans liés à l’unification de la relativité générale et de la mécanique quantique via la dualité holographique. En analysant un cadre théorique datant de 2003 dont les calculs bloquaient la communauté scientifique, l’IA a identifié la rupture d’une technique mathématique utilisée depuis 15 ans. Elle a démontré que des trous noirs se forment soudainement (à la manière de l’eau entrant en ébullition), des résultats qui font désormais l’objet de prépublications scientifiques.
Sur le terrain de la biologie synthétique, Mythos 5.2 a conçu ses propres pipelines d’outils pour modéliser des capsides de virus adéno-associés (AAV) utilisées comme vecteurs en thérapie génique. Le modèle a réussi la conception de 28 capsides sur 34 (naturelles comme ingéniérées), ouvrant la voie à des réductions massives de coûts pour l’industrie biotechnologique.
Robotique et Ingénierie Hardware
Sur le benchmark de référence Robo Dojo (qui évalue le contrôle robotique sur 42 tâches simulées et 18 tâches réelles à deux bras), Fable 5.2 établit un nouveau sommet :
Fable 5.2 : 64,9
Opus 5.5 : 39,4
GPT-6 Astra : 29,8
Fable 5.1 : 27,6
La démonstration la plus spectaculaire a été menée par la chercheuse Karolina Dubiel, qui a relié directement Fable 5.2 à un bras robotique réel pour jouer une partie de dames complète en 62 coups contre un humain. Confrontée aux reflets lumineux de la pièce et aux glissements mécaniques de la pince (qui ont provoqué 14 ratés physiques), l’IA n’a pas déraillé. À chaque simple consigne “Réessaie”, elle a réanalysé le flux vidéo, diagnostiqué l’erreur de saisie et recalculé son angle de prise. Lorsque le bras s’est affaissé d’environ un centimètre (1/4 de pouce) sous l’effet de la fatigue mécanique, Fable 5.2 a lu la télémétrie de couple et de déplacement des joints pour appliquer d’elle-même un décalage de compensation.
Enfin, via l’outil Diode, un prompt unique d’un paragraphe a suffi pour que Fable 5.2 conçoive un assistant vocal physique complet en moins de 24 heures :
Routage d’un circuit imprimé (PCB) complexe 4 couches ;
Modélisation 3D du boîtier et sélection des composants auprès de fournisseurs américains ;
Écriture intégrale du micrologiciel (firmware). Résultat : 100 % des cartes fabriquées se sont allumées dès la première mise sous tension.
L’effet “Senior Engineer” et le paradoxe des coûts de verbosité
L’analyse économique de Fable 5.2 révèle une dynamique complexe entre la baisse des tarifs affichés et la réalité des coûts opérationnels en poussée maximale (max effort).
Le paradoxe des coûts et la dégradation par sur-délibération
En grille tarifaire faciale, Anthropic affiche une baisse de 20 % par rapport à Fable 5.1 : 8 $ par million de tokens d’entrée et 40 $ par million de tokens de sortie. Cependant, les mesures indépendantes réalisées par Artificial Analysis révèlent un coût par tâche en mode d’effort maximal qui grimpe en moyenne à 26,50 $, soit 2,6 fois le coût d’Opus 5.5 (10 $) et le double de Fable 5.1. La raison ? Une génération de contexte gargantuesque, atteignant jusqu’à 275 millions de tokens sur certains jeux de tests.
Anthropic qualifie ce comportement de sur-délibération (over-deliberation). Confronté à un problème, Fable 5.2 réagit comme un ingénieur ultra-senior particulièrement consciencieux : au lieu d’appliquer une retouche rapide de deux lignes, il contrôle si le correctif s’intègre parfaitement à l’échelle de l’architecture globale, transformant un simple bugfix en une refactorisation lourde.
Cette tendance peut parfois devenir contre-productive. L’évaluation du benchmark Frontier Code 2.0 en offre une illustration chiffrée saisissante :
En mode High Effort : Fable 5.2 décroche le meilleur score mondial avec 49,1 % de réussite pour un coût maîtrisé de 14,19 $ par tâche (dépassant GPT-6 Astra et ses 42,8 %).
En poussée maximale (Max Effort) : Le modèle sur-délibère, dépasse parfois le temps limite imparti et voit sa précision chuter à 45,6 %, tandis que le coût explose à 44,70 $ par tâche (soit plus du triple).
Mode d'effort sur Frontier Code 2.0 :
• High Effort : 49,1 % de réussite | 14,19 $ / tâche  (Optimum d'efficacité)
• Max Effort  : 45,6 % de réussite | 44,70 $ / tâche  (Sur-délibération coûteuse)
Pour les décideurs tech, la leçon est claire : le mode Max Effort ne doit pas être activé aveuglément. En revanche, lorsque le périmètre est bien cadré, l’efficacité temporelle est remarquable. La création complète d’une scène 3D de sous-marin, qui exigeait 6 heures et 40 minutes d’assistance humaine continue sous Opus 5.5, a été exécutée par Fable 5.2 en seulement 1 heure et 26 minutes dès le premier passage (first pass yield).
Le premier modèle délibérément bridé contre l’auto-amélioration récursive
Au-delà des performances pures, Fable 5.2 introduit un précédent historique dans les stratégies d’alignement et de gouvernance des IA de frontière.
Le bridage volontaire des capacités d’auto-amélioration
Au cours de la phase d’entraînement, les chercheurs d’Anthropic ont constaté que Fable 5.2 développait des compétences alarmantes pour optimiser lui-même les architectures de modèles de langage (LLM) et réécrire les noyaux d’accélérateurs matériels (accelerator kernels). Afin d’éviter tout risque d’amorce d’une boucle d’auto-amélioration récursive non contrôlée, Anthropic a délibérément bridé ces compétences spécifiques, les plafonnant au niveau d’Opus 5.5.
Sécurité, anti-distillation et chute des refus abusifs
Parallèlement à cette mesure de précaution inédite, le modèle franchit des étapes décisives sur le terrain de la sécurité opérationnelle :
Protection anti-distillation : Implémentation d’architectures de sécurité réduisant le scraping non autorisé du modèle de 90 à 99 %.
Ergonomie et baisse des faux positifs : Les refus abusifs (wrongful refusals) chutent de 55 % par rapport à la génération précédente, éliminant une grande partie des frictions d’utilisation.
Cybersécurité avancée (Mythos 5.2) : La version Mythos surpasse les meilleurs outils du marché en découvrant 10,2 % de CVE supplémentaires. Soumis à une batterie de 1 800 tests d’évasion de limite d’exécution (sandbox escapes), Mythos 5.2 a vu son taux de réussite d’évasion s’effondrer à 3,1 %, contre 39 % pour la version Mythos 5.0.
Vers une IA partenaire de long cours
L’émergence de Claude Fable 5.2 et de Mythos 5.2 entérine un basculement stratégique majeur : l’industrie s’éloigne des chatbots réactifs pour entrer de plein fouet dans l’ère des agents autonomes de longue durée, capables de mener des travaux d’ingénierie lourds sur plusieurs jours.
Ce bond technologique survient néanmoins dans un climat économique complexe pour Anthropic. Entre les préparatifs d’une IPO scrutée par les marchés, la guerre des prix agressive menée par OpenAI et Google, et les tensions sur les capacités de calcul (compute), le laboratoire doit prouver sa rentabilité tout en maintenant son leadership technique. En combinant des capacités de raisonnement inédites et la mise en place du premier bridage préventif contre l’auto-amélioration récursive, Anthropic pose un jalon historique dans la trajectoire vers une intelligence artificielle générale maîtrisée.