12 juillet 2026
DeepSeek DSpark : Pourquoi la vitesse est la nouvelle frontière de l’intelligence artificielle
1. Introduction : Le goulot d’étranglement invisible de l’IA Dans la course effrénée à l’intelligence artificielle, l’industrie a longtemps été obsédée par la “puissance cérébrale” brute. Pourtant, une vérité brutale s’i
1. Introduction : Le goulot d’étranglement invisible de l’IA
Dans la course effrénée à l’intelligence artificielle, l’industrie a longtemps été obsédée par la “puissance cérébrale” brute. Pourtant, une vérité brutale s’impose aujourd’hui aux ingénieurs : l’intelligence d’un modèle est stérile si elle est trop lente, trop coûteuse ou impossible à déployer à l’échelle. C’est le goulot d’étranglement invisible de l’IA moderne : la latence d’inférence.
DeepSeek vient de franchir une étape décisive avec une mise à jour majeure de son architecture V4, baptisée DSpark. Ici, l’innovation ne réside pas dans l’accumulation de nouveaux paramètres ou de connaissances académiques, mais dans une refonte radicale de l’agilité du système. En s’attaquant au “système nerveux” de l’IA plutôt qu’à son cerveau, DeepSeek transforme la manière dont les modèles massifs interagissent avec le monde réel.
2. L’IA ne devient pas plus intelligente, elle devient (enfin) rapide
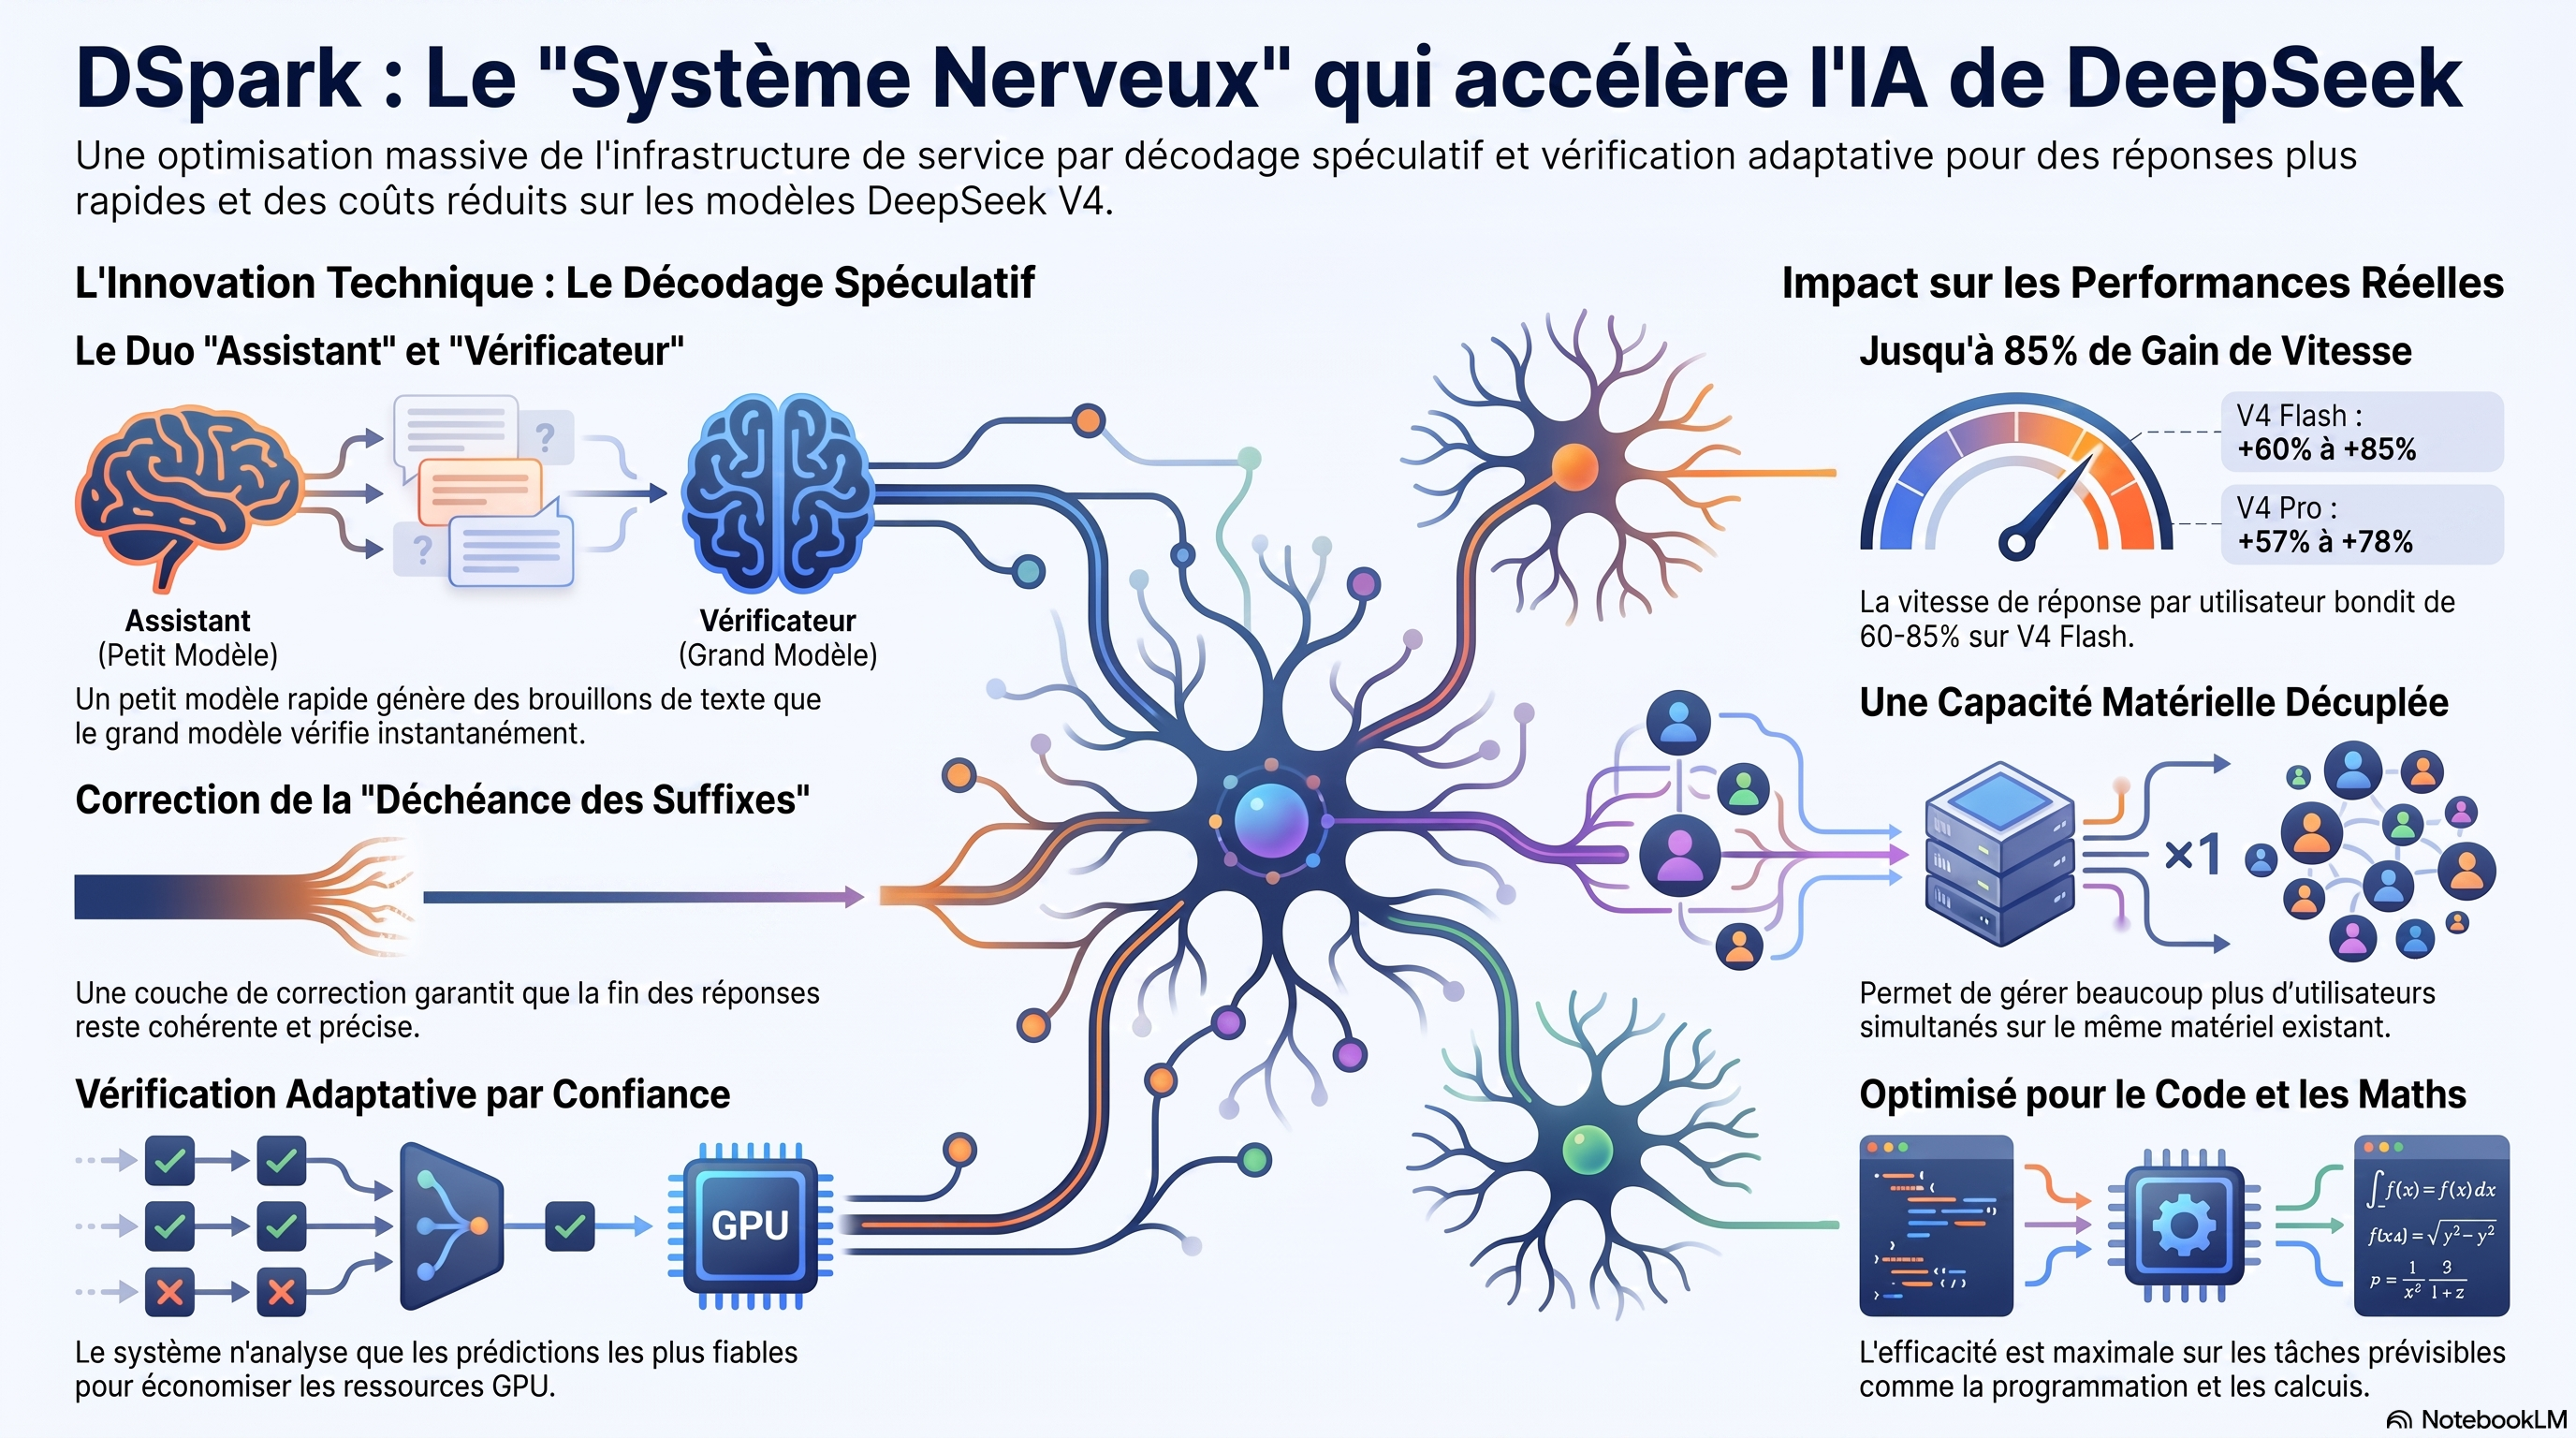
DSpark ne doit pas être perçu comme une mise à jour des capacités cognitives de DeepSeek-V4. Il s’agit d’une optimisation structurelle massive visant à briser la linéarité de la génération de texte, où chaque jeton (token) est habituellement produit l’un après l’autre, créant une attente visible pour l’utilisateur.
Les gains d’efficacité rapportés sont sans précédent pour cette classe de modèles :
V4 Flash : Une augmentation de la vitesse de réponse par utilisateur de 60 % à 85 %.
V4 Pro : Une accélération de 57 % à 78 %.
Cette distinction entre le “cerveau” (le modèle de langage) et le “système nerveux” (DSpark) est le pilier d’une nouvelle stratégie industrielle. Pour un déploiement massif, la capacité d’un système à absorber la charge prime sur l’ajout de complexité. Comme le précise l’analyse de DeepSeek, un modèle intelligent perd toute valeur opérationnelle s’il s’effondre sous son propre coût de service. DSpark permet ainsi au même parc de GPU de supporter une densité d’utilisateurs bien plus élevée sans dégrader l’expérience.
3. Le secret du “Speculative Decoding” et la correction du “Suffix Decay”
Au cœur de DSpark se trouve le décodage spéculatif. Le concept est élégant : un petit modèle “assistant”, ultra-rapide, génère un brouillon de plusieurs jetons à l’avance. Le grand modèle (V4) n’intervient que pour valider ou corriger ce bloc de texte.
Cependant, les méthodes de brouillon purement parallèles souffrent souvent du suffix decay (déclin des suffixes). Lorsqu’un assistant prédit plusieurs mots simultanément, les derniers jetons du bloc ont tendance à devenir incohérents car ils ignorent les choix faits pour les premiers.
Exemple technique : Pour une expression comme “of course” ou “no problem”, un modèle parallèle mal régulé pourrait s’emmêler les pinceaux et produire des hybrides absurdes comme “of problem” ou “no course”.
Pour résoudre cela, DeepSeek, en collaboration avec l’Université de Pékin, a opté pour une approche de génération semi-auto-régressive. Plutôt que d’utiliser une tête RNN (plus complexe et aux gains marginaux en production), les ingénieurs ont privilégié une tête Markov. Cette solution, plus pragmatique, assure que chaque mot du brouillon reste cohérent avec le précédent tout en conservant la vitesse du calcul parallèle. C’est le compromis parfait entre la rapidité brute de DFlash et la stabilité séquentielle d’Eagle 3.
4. L’IA adaptative : Le “Confidence Scheduled Verification”
L’innovation la plus stratégique de DSpark est sans doute sa capacité à s’auto-réguler selon le trafic grâce au Confidence Scheduled Verification. Le système attribue un score de confiance à chaque jeton du brouillon, estimant sa probabilité d’être validé par le modèle principal.
Pour rendre ces scores fiables, DeepSeek utilise le Sequential Temperature Scaling, réduisant l’erreur de calibration à seulement 1 %. Cette précision permet au système de se comporter comme une infrastructure intelligente :
En période de trafic fluide : DSpark vérifie des brouillons longs pour maximiser la vitesse.
En période de saturation : Le système devient sélectif. Il coupe les parties incertaines du brouillon avant qu’elles ne sollicitent le GPU principal, évitant ainsi de gaspiller de la puissance de calcul sur des erreurs probables.
Cette sélectivité n’est pas un simple filtre, c’est une gestion de charge en temps réel. En isolant les segments à haute probabilité, les taux d’acceptation par le modèle principal ont explosé :
Chat : Passage de ~45 % à 95,7 %.
Mathématiques : Passage de ~76 % à 92,5 %.
Code : Passage de ~67 % à 92 %.
5. L’efficacité comme arme stratégique face aux restrictions
Le développement de DSpark ne se fait pas dans un vide technologique. Il répond aux réalités géopolitiques chinoises : face aux restrictions sur les puces haut de gamme, l’optimisation logicielle est devenue l’arme de survie.
DeepSeek n’est pas seul dans cette quête. Des géants comme Tencent et Xiaomi transforment l’efficacité d’inférence en avantage compétitif majeur. On peut citer le modèle MIMO V2.5 Pro ultra speed de Xiaomi, capable de dépasser les 1 000 tokens par seconde. Dans ce contexte, DSpark représente une ingénierie pragmatique : compenser la rareté du matériel par une intelligence logicielle supérieure, capable de tirer le maximum de configurations moins puissantes.
6. Des performances brutes aux limites du matériel
Les tests de stress montrent que DSpark ne se contente pas d’améliorations marginales. Sous une contrainte extrême, avec une cible de 120 tokens par seconde par utilisateur, DSpark affiche un débit global nominal 661 % supérieur à l’ancienne infrastructure (MTP1) sur V4 Flash. Ce chiffre spectaculaire s’explique par le fait que là où l’ancien système s’effondrait sous la charge, DSpark maintient une fluidité constante.
Il ne s’agit pas d’un simple “plugin” léger. DeepSeek a ouvert le code via le projet DeepSpec, mais l’infrastructure nécessaire reste imposante. La configuration par défaut pour un modèle Quen 3 4B nécessite un environnement de 8 GPU et environ 38 téraoctets de cache cible. C’est une technologie conçue pour les data centers de production, prête à supporter des millions de requêtes simultanées.
7. Conclusion : Vers une IA omniprésente et instantanée
L’avenir de l’intelligence artificielle ne se jouera plus seulement sur la taille des paramètres, mais sur la capacité des modèles à être stables, rapides et économiquement viables. Avec DSpark, DeepSeek prouve que l’optimisation du “système nerveux” est tout aussi vitale que l’augmentation des capacités cognitives.
Cette transition marque le passage de l’IA expérimentale à l’IA utilitaire. En privilégiant l’ingénierie pragmatique au “scaling” théorique, DeepSeek nous rapproche d’un futur où la technologie est si réactive qu’elle en devient invisible. La véritable révolution de l’IA n’est peut-être pas de penser mieux, mais de répondre assez vite pour s’effacer derrière l’usage quotidien.