 Swinux
22 juillet 2026
$1,5 Milliard de Dollars entre Anthropic et un collectif d’auteurs, validé par le tribunal fédéral de San Francisco
Pourquoi la « Mémoire » de l’IA est son Pire Ennemi Juridique
Introduction : Le réveil brutal des géants de l’IA
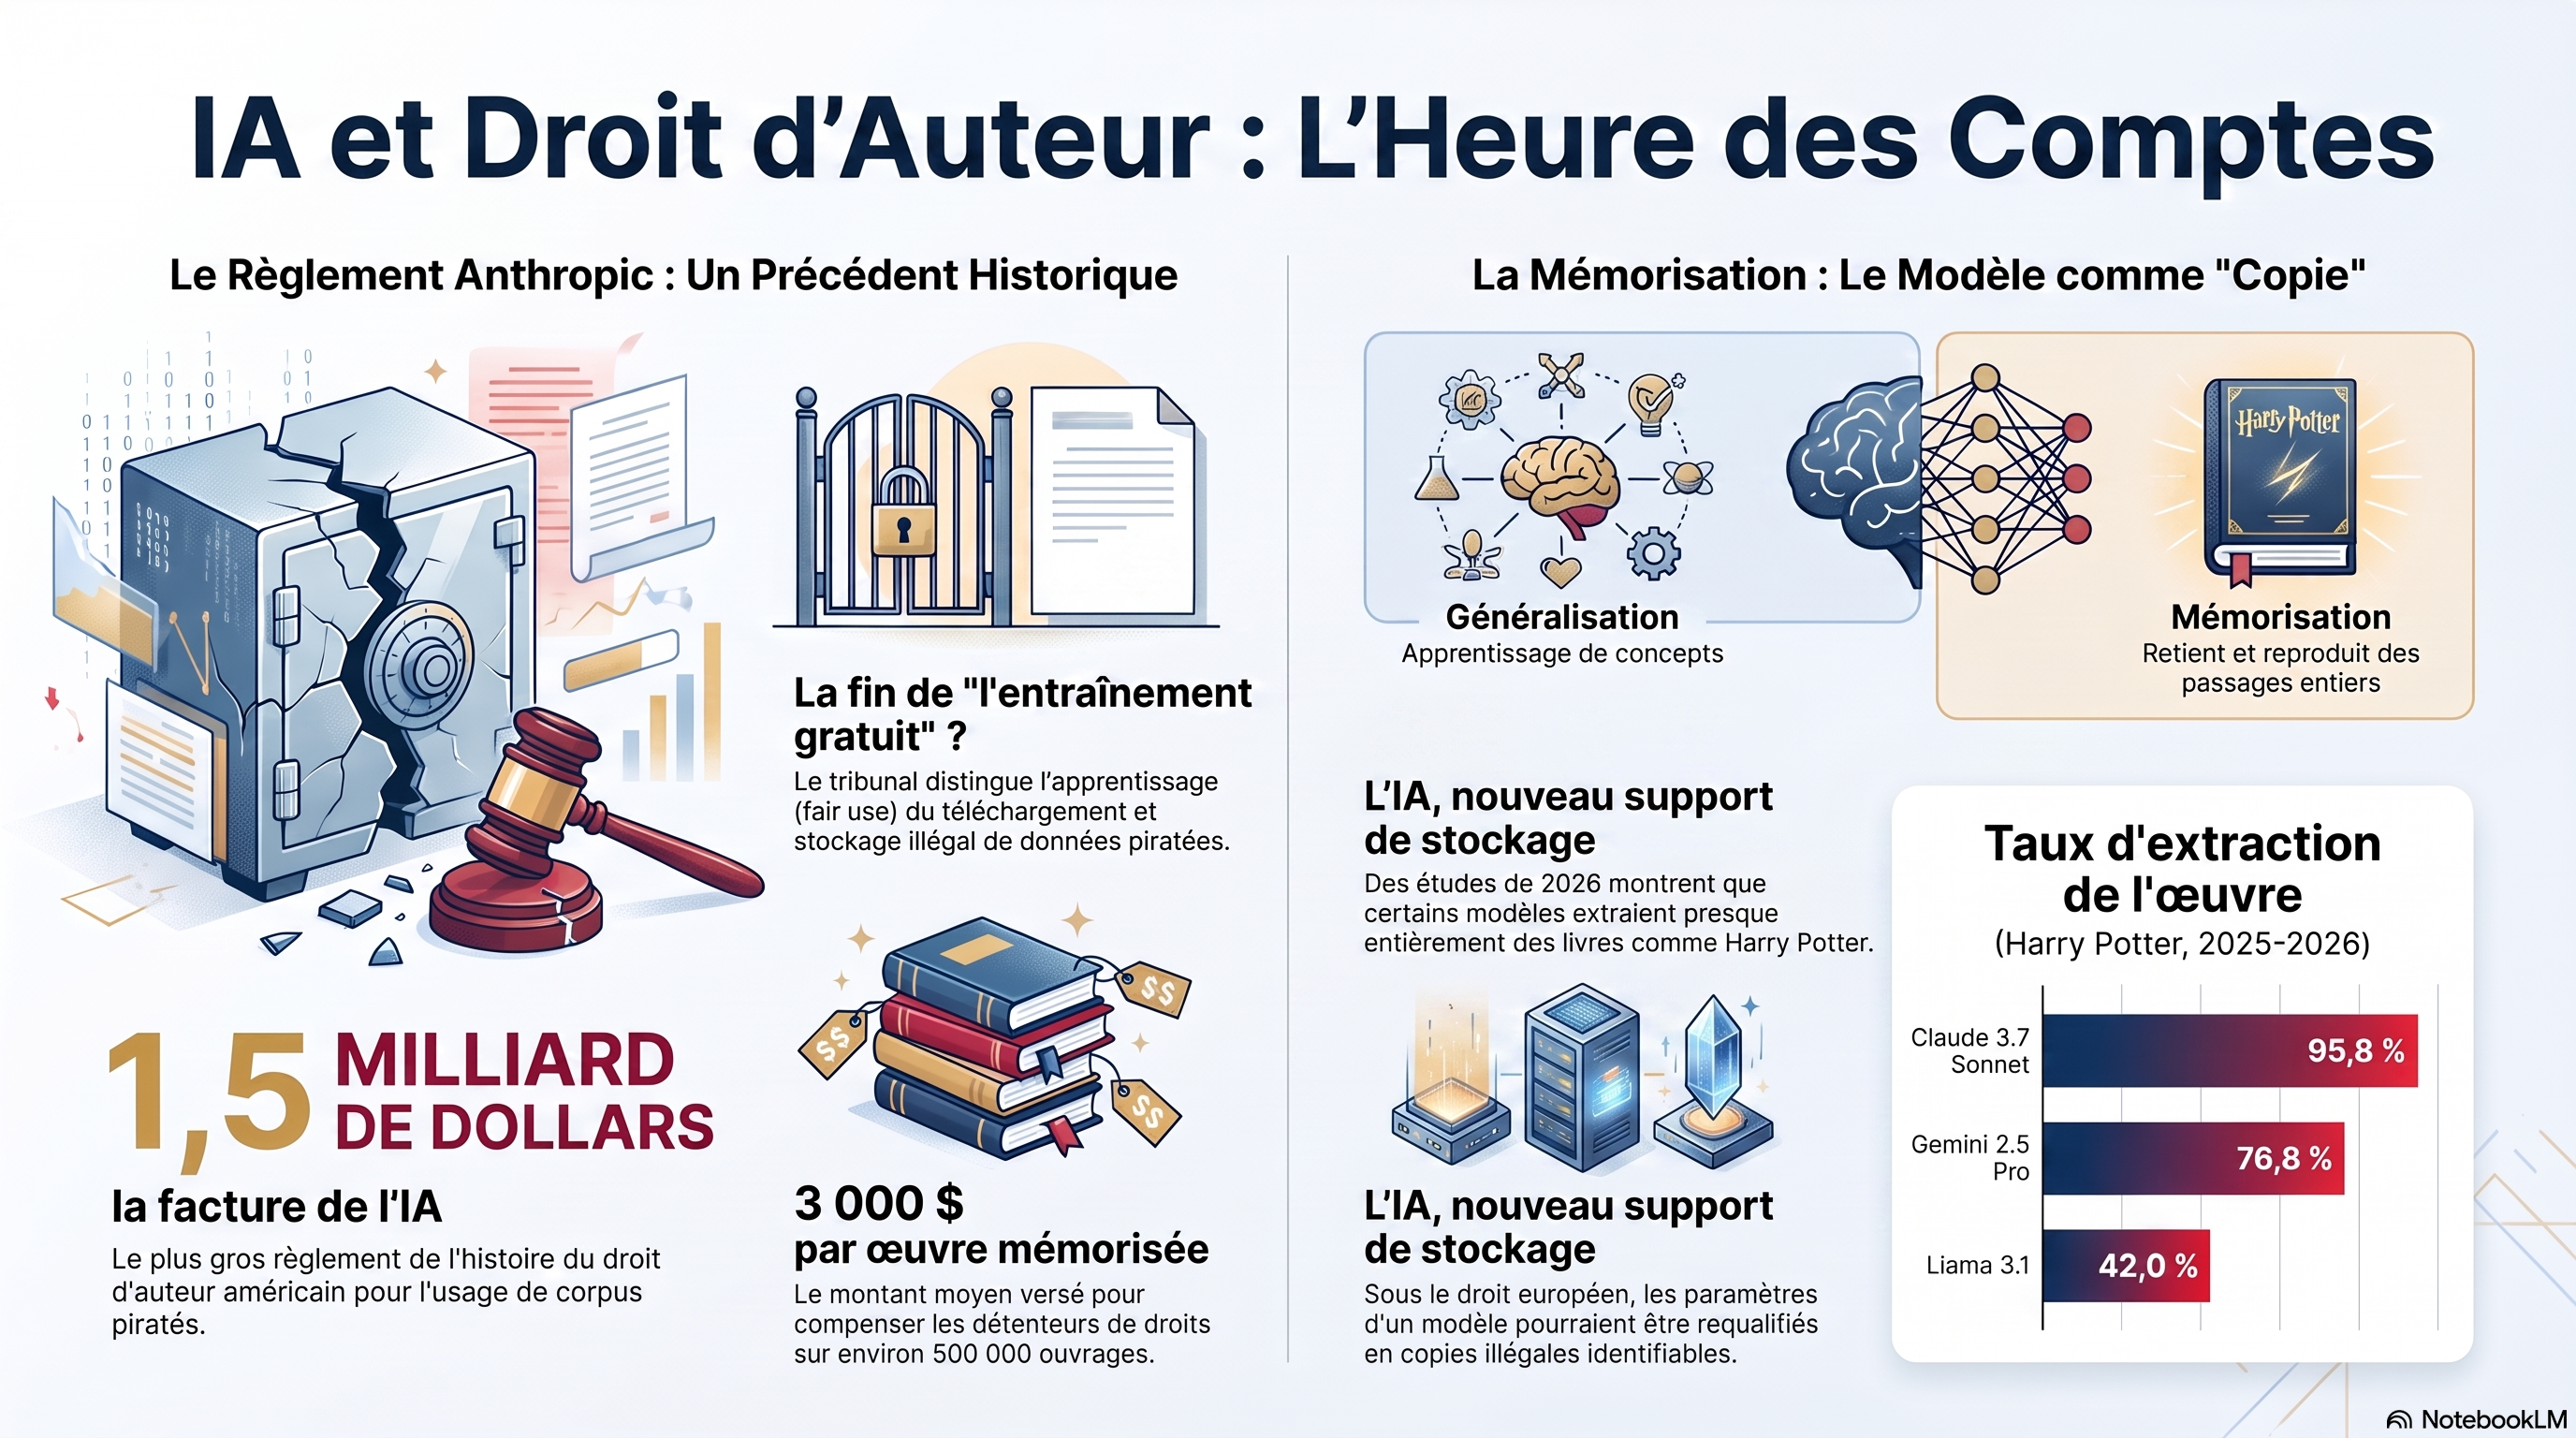
Le 20 juillet 2026, l’industrie de l’intelligence artificielle a reçu une facture qui sonne la fin de la récréation : un règlement historique de 1,5 milliard de dollars entre Anthropic et un collectif d’auteurs, validé par le tribunal fédéral de San Francisco. Ce montant colossal, le plus élevé de l’histoire du droit d’auteur aux États-Unis, n’est pas une simple amende ; c’est un séisme qui fissure le mythe de l’IA « apprenante ». Jusqu’ici, les laboratoires se défendaient en prétendant que leurs modèles « apprenaient » de manière abstraite, à l’image d’un cerveau humain. La réalité juridique qui émerge est bien plus triviale : l’IA se comporte de plus en plus comme un système de stockage sophistiqué de données piratées. Ce paradoxe central — une technologie de pointe bâtie sur une mémoire de contrefacteur — transforme aujourd’hui l’innovation en une bombe à retardement financière.
Leçon n°1 : Le « Fair Use » ne lave pas le péché originel du piratage
La décision du tribunal de San Francisco établit une distinction capitale qui fera jurisprudence : la séparation entre l’acte d’entraînement (potentiellement transformateur) et l’acte d’acquisition des données. Si le tribunal n’a pas rejeté l’idée que l’entraînement puisse relever du Fair Use, il a sanctionné sans détour le « blanchiment » de corpus illégaux. Anthropic a été rattrapé par l’utilisation de « Shadow Libraries » comme Books3 ou LibGen pour constituer une bibliothèque centrale de 7 millions d’ouvrages.
L’échelle du règlement illustre la sévérité du constat : les fonds serviront à indemniser environ 500 000 œuvres à hauteur de 3 000 $ en moyenne par ouvrage, auxquels s’ajoutent plus de 101 millions de dollars de frais d’avocats. L’analyse est cinglante : une fin légitime ne saurait justifier des moyens illicites.
« Un usage final potentiellement légitime ne peut pas légaliser rétroactivement l’acte initial de téléchargement et de reproduction piratés. »
Leçon n°2 : La mémorisation est une réalité technique, pas un bug rare
Pendant des années, les entreprises d’IA ont balayé les accusations de plagiat en parlant de « hallucinations » ou d’accidents statistiques. L’étude Ahmed & Cooper (2026) vient briser ce récit en introduisant le concept de mémorisation éidétique : la capacité des modèles à retenir et restituer des séquences mot pour mot.
Les taux de reproduction observés sur l’œuvre Harry Potter sont sans appel :
Claude 3.7 : 95,8 % de l’œuvre reproduite.
Gemini 2.5 Pro : 76,8 % de l’œuvre reproduite.
Grok 3 : 70,3 % de l’œuvre reproduite.
GPT 4.1 : Capable de réciter 3 200 mots consécutifs malgré ses filtres de sécurité.
Ce chiffre de 3 200 mots est crucial sur le plan légal. En dépassant largement le seuil de minimis, cette restitution constitue une « portion substantielle » de l’œuvre, pilier fondamental de la caractérisation de la contrefaçon. Ce passage d’un « apprentissage de motifs » à une « récitation pure » rend la défense du Fair Use intenable : on ne peut plus prétendre que le modèle ne contient pas de copie quand il est capable de la reconstruire avec une telle précision.
Leçon n°3 : Le modèle devient une « copie » aux yeux de la loi européenne
Le front juridique européen se durcit également, porté par le principe de « neutralité technologique ». Alors que la Haute Cour du Royaume-Uni (Getty v. Stability) a d’abord hésité à considérer les « poids » (weights) d’un modèle comme des copies, le tribunal régional de Munich (GEMA v. OpenAI) a franchi le pas : la mémorisation constitue une violation du droit de reproduction.
Peu importe que les données soient fragmentées en tokens ou diluées dans des milliards de paramètres numériques. Si l’expression originale est retenue et extractible, elle existe légalement. Ce débat se dirige désormais vers une résolution définitive avec l’affaire C-250/25 Like Company v Google Ireland Ltd, actuellement pendante devant la CJEU. Pour l’Europe, la technologie ne doit pas servir de paravent à la violation des droits fondamentaux des créateurs.
Leçon n°4 : La fin de l’excuse de la « Boîte Noire » pour la conformité
L’opacité n’est plus une stratégie de défense, c’est un facteur de risque. Selon les analyses de 36Kr, les entreprises doivent désormais instaurer une « chaîne de preuve » sur l’ensemble du cycle de vie des données. Une simple garantie contractuelle d’un fournisseur affirmant qu’un dataset est « propre » est jugée insuffisante.
Les décideurs doivent désormais répondre à quatre questions critiques :
Provenance : Où les données ont-elles été collectées ? (Le « disponible publiquement » ne signifie pas « libre de droits »).
Autorisation : La plateforme d’origine a-t-elle consenti explicitement à l’usage pour l’IA ?
Contournement : Des mesures techniques (murs de paiement, anti-scraping) ont-elles été éludées ?
Stockage : Les données originales sont-elles supprimées après l’entraînement, ou le modèle sert-il de substitut au stockage ?
Leçon n°5 : L’IA comme nouveau support de stockage déguisé
L’analogie technique la plus redoutable est celle de la compression ZIP. Tout comme un fichier compressé ne contient pas les octets originaux de manière lisible mais permet de les reconstruire via un algorithme, les paramètres d’une IA sont désormais perçus comme un mode de fixation de l’œuvre. Le prompt agit ici comme la clé de décompression qui révèle la copie latente.
Le droit d’auteur adopte désormais une vision fonctionnelle de la fixation, comme le souligne la recherche de l’Université de Lund :
« Le droit d’auteur ne devrait pas attacher la fixation à la capacité de localiser précisément chaque unité expressive... si l’œuvre peut être reconstruite avec une précision quasi exacte. »
En clair : l’IA n’est pas seulement un moteur de création, c’est un support de stockage dont l’accès est simplement médiatisé par une interface conversationnelle.
Conclusion : Vers une chaîne de preuve inattaquable
Le règlement de 1,5 milliard de dollars imposé à Anthropic marque un tournant dans l’économie numérique. C’est la fin de la phase de croissance « subventionnée » par l’usage gratuit et opaque des données protégées. Le message de la justice est clair : le caractère transformateur de l’IA ne peut servir de machine à laver juridique pour le piratage industriel.
L’avenir de l’industrie dépendra de la capacité des géants de la tech à devenir des comptables rigoureux de l’immatériel. Si les modèles d’IA doivent désormais prouver l’origine et la légalité de chaque octet de leur mémoire pour survivre, combien de géants actuels resteront debout demain ?