5 juillet 2026
12 Millions de Tokens : L’architecture qui pourrait raser le complexe industriel du RAG
1. Introduction : Le mur invisible de l’IA moderne L’industrie de l’IA souffre d’un syndrome de « mémoire courte », et nous avons bâti un empire technologique pour masquer cette infirmité. Jusqu’à présent, traiter d’énor
1. Introduction : Le mur invisible de l’IA moderne
L’industrie de l’IA souffre d’un syndrome de « mémoire courte », et nous avons bâti un empire technologique pour masquer cette infirmité. Jusqu’à présent, traiter d’énormes volumes de données avec un Large Language Model (LLM) revenait à payer une taxe prohibitive en puissance de calcul. C’est ce mur invisible qui nous a forcés à ériger ce que j’appelle le complexe industriel du RAG : des pipelines de chunking épuisants et des bases de données vectorielles coûteuses. On découpe l’information en miettes, en espérant que l’IA saura recréer le puzzle.
Aujourd’hui, une startup nommée Subquadratic promet de dynamiter cet échafaudage. Sa promesse ? Une fenêtre de contexte de 12 millions de tokens avec une efficacité multipliée par 1000. Ce n’est pas une simple mise à jour ; c’est une déclaration de guerre contre les limitations architecturales qui dictent nos stratégies Data depuis trois ans.
2. Le point de rupture : Pourquoi l’attention « quadratique » nous freine
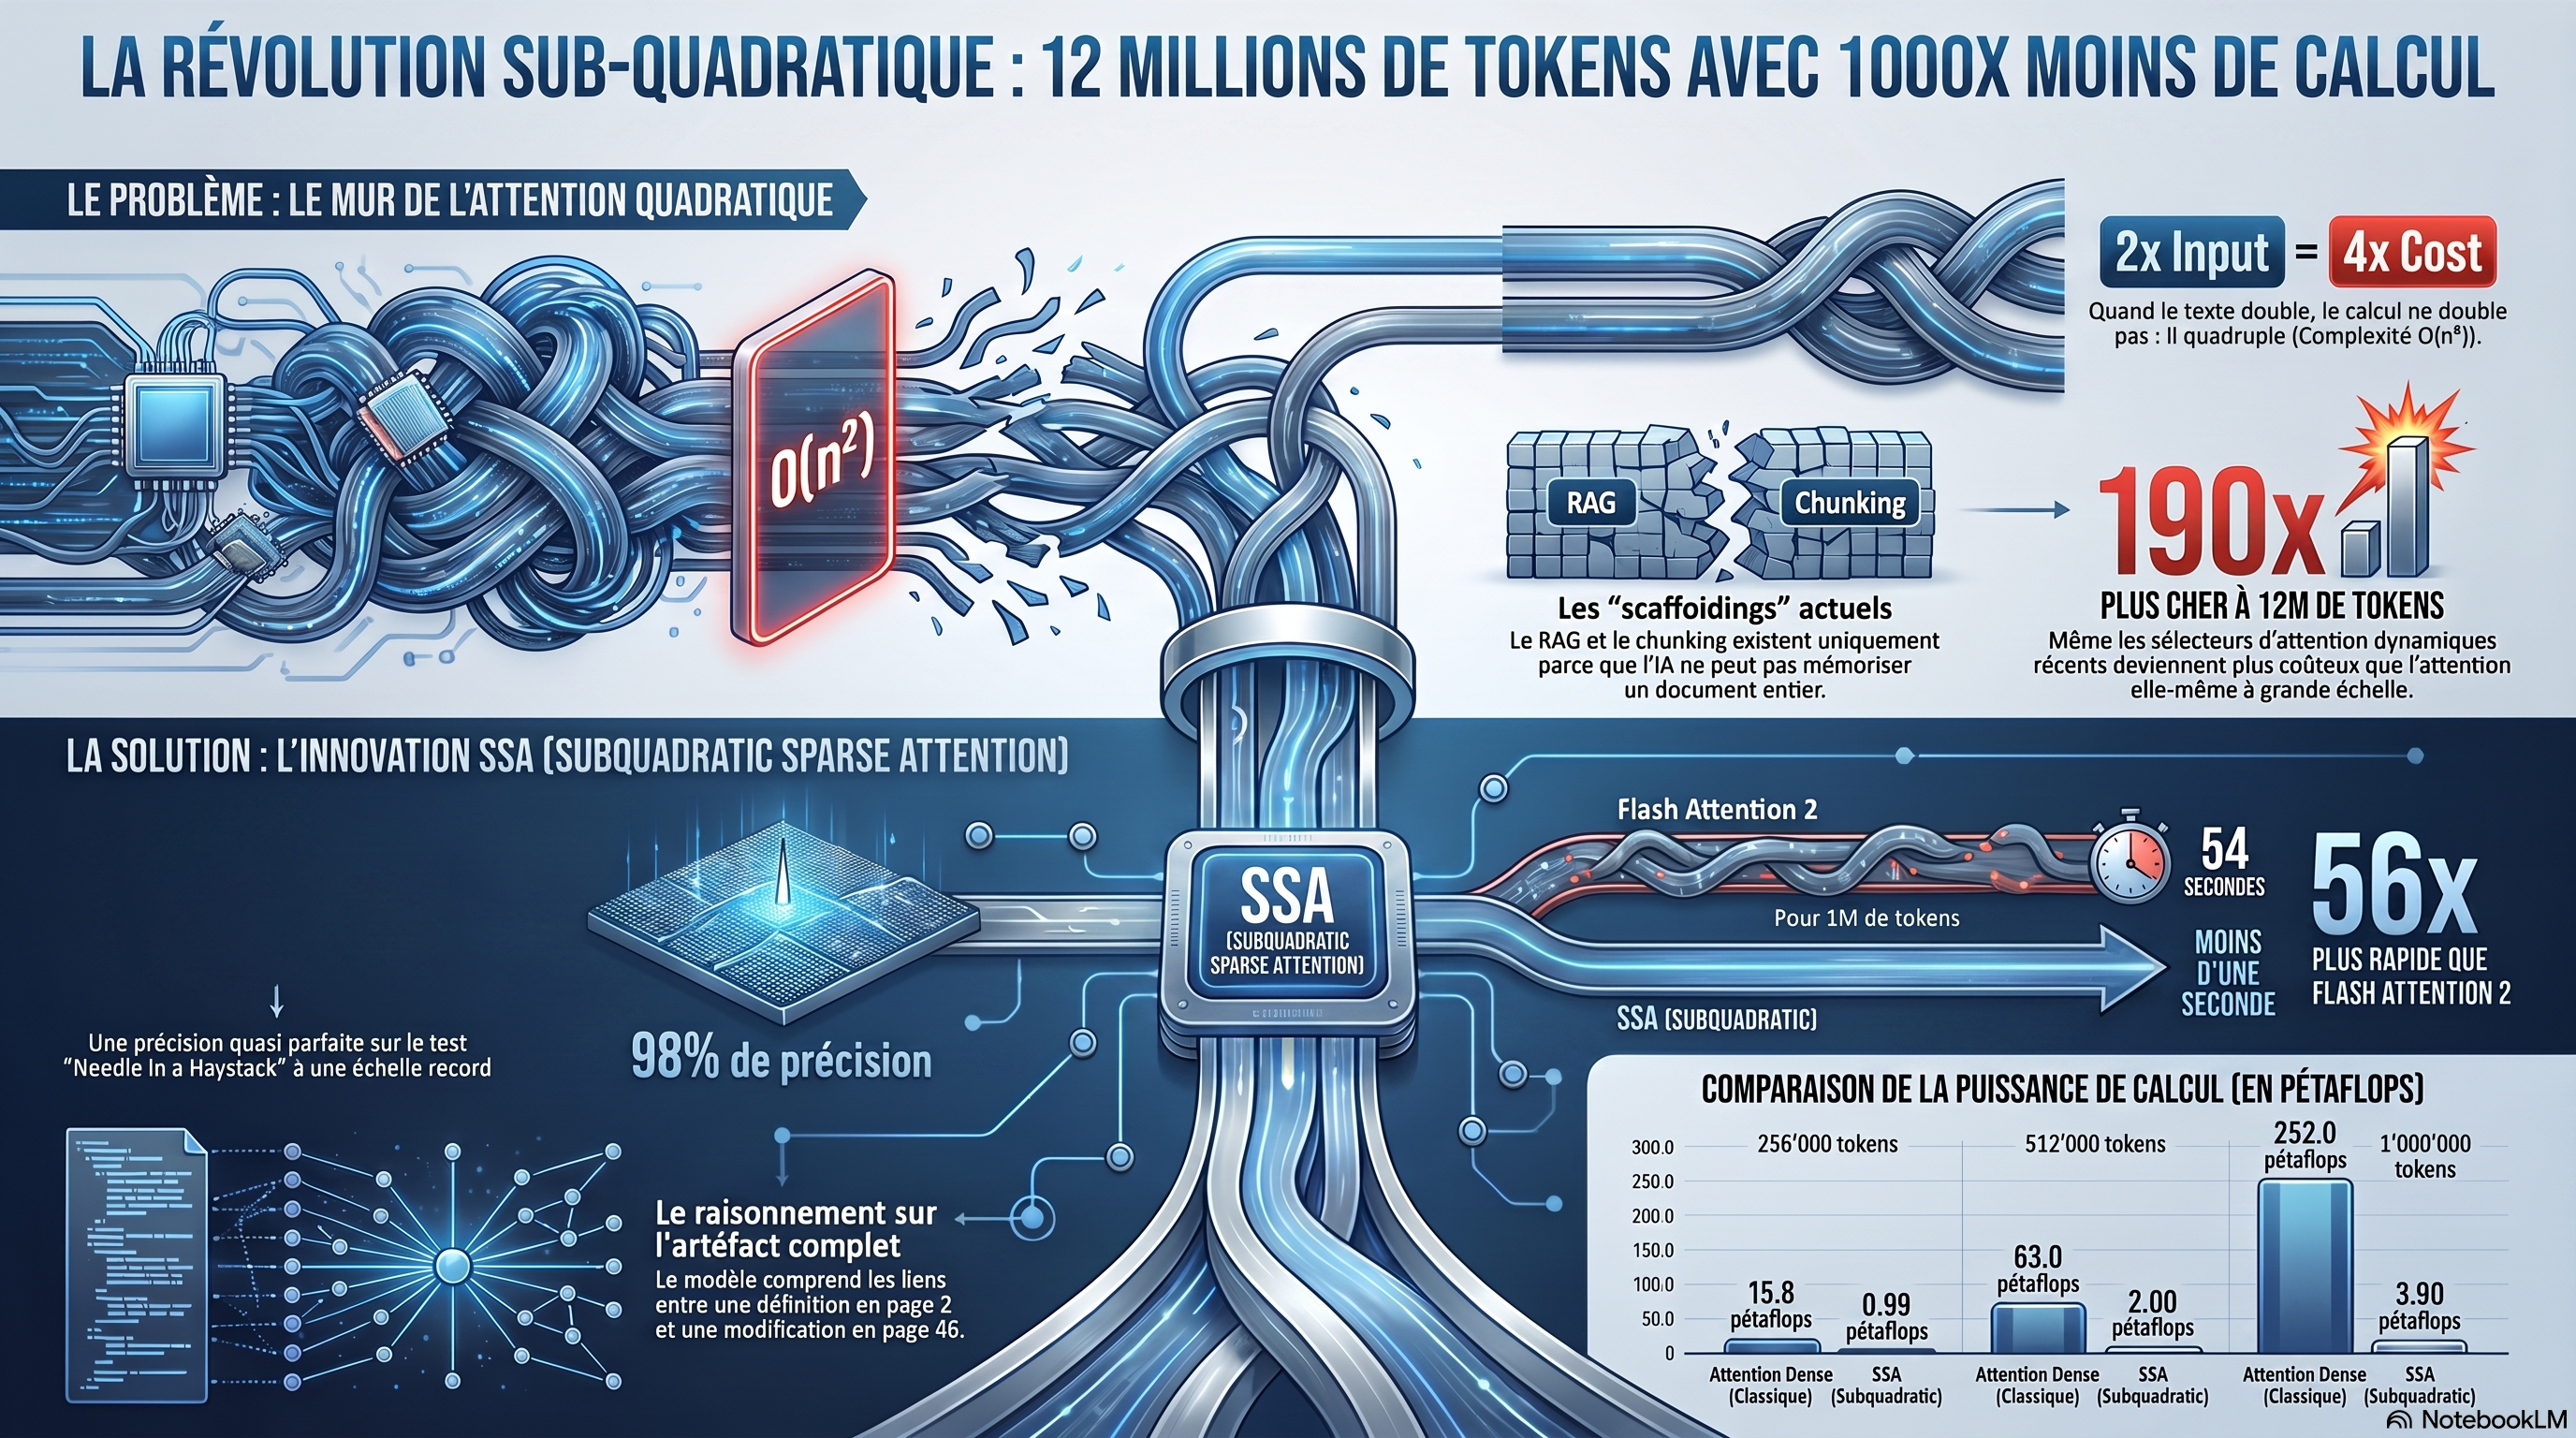
Le problème fondamental des Transformers réside dans leur mécanisme d’attention dense. Pour comprendre un texte, le modèle compare chaque token à tous les autres. C’est une complexité quadratique : doublez la longueur du texte, et le calcul quadruple. À l’échelle de l’entreprise, ce coût devient brutal. Passer de 10 000 à 1 million de tokens n’augmente pas la charge de calcul par 100, mais par environ 10 000.
« Tout cet échafaudage — bases de données vectorielles, pipelines de chunking, couches d’orchestration d’agents — n’existe que parce que les modèles ne peuvent pas, à moindre coût, garder un document entier en tête pour raisonner sur l’ensemble. Cette infrastructure est un monument à nos limitations actuelles. »
Chaque système de récupération actuel fait un pari implicite sur l’information qui compte. Et dans le monde réel, l’IA perd souvent ce pari car elle ne saisit pas les connexions logiques dispersées à travers des milliers de pages.
3. L’innovation SSA : Le génie de l’attention linéaire
Pour briser ce cycle, Subquadratic a développé la SSA (Subquadratic Sparse Attention). Contrairement aux anciennes méthodes d’attention éparse aux schémas fixes (fenêtres locales ou motifs prédéfinis), la SSA est dynamique. Elle apprend quelles relations sont réellement pertinentes en se basant sur le sens et le contenu, et non sur la position.
Le véritable tour de force est que l’étape de sélection est elle-même linéaire. C’est le « piège » dans lequel tombent les architectures concurrentes. Prenez le système de DeepSeek : il utilise un indexeur dynamique pour guider l’attention, mais cet indexeur reste quadratique.
Analyse : Selon les rapports techniques, à 1 million de tokens, l’indexeur de style DeepSeek coûte déjà 16 fois plus cher que l’attention qu’il guide. À 12 millions de tokens, ce ratio explose à 190 fois. En rendant la sélection et l’attention totalement linéaires, Subquadratic évite ce goulot d’étranglement financier et technique.
4. Des performances qui défient les attentes : 12 millions de tokens sans perte
Le modèle SubQ 1.1 Small affiche des chiffres qui redéfinissent l’état de l’art :
Précision Chirurgicale : 100 % au test « Needle in a Haystack » jusqu’à 2 millions de tokens, et 98 % à 12 millions.
Ruler Benchmark : Un score de 99,12 % à 128 000 tokens, prouvant que le modèle ne fait pas que récupérer une information, mais maîtrise des tâches complexes (extraction multi-clés, traçage de variables).
Efficacité Radicale (sur GPU H100) : Pour 1 million de tokens, l’attention dense classique consomme 252 Petaflops et prend 54 secondes. La SSA ne consomme que 3,9 Petaflops et traite le tout en 966 millisecondes.
Analyse stratégique : Le modèle n’attend réellement que 0,13 % des paires de tokens possibles. Cela signifie que nous avons enfin une intelligence capable d’effectuer un « filtrage de pertinence » au niveau matériel (hardware level), et non plus via une couche logicielle fragile. Bien que le modèle ait été entraîné principalement à 1 million de tokens, l’utilisation de techniques comme Yarn lui permet d’extrapoler à 12 millions sans effondrement de la logique.
5. L’épreuve du feu : « Artifact Reasoning » vs RAG classique
Subquadratic introduit le concept de « Artifact Reasoning » : la capacité de raisonner sur l’intégralité d’un actif complexe (code source, contrat de 500 pages, dossier financier). Le RAG échoue là où l’interdépendance règne : une clause en page 2 peut être annulée en page 46. Un système de fragments manquera toujours cette connexion.
Les benchmarks de capacité générale confirment que SubQ 1.1 Small est un modèle « Frontier » :
GPQA Diamond (Sciences) : 85,4 %, dépassant GPT-5.4 Nano.
LiveCodeBench v6 (Code) : 89,7 %, rivalisant avec Claude 4.6 Sonnet.
Automation Bench Finance : Sur ce test simulant 500 points d’accès API, SubQ 1.1 Small atteint 13 %, talonnant les 18 % de GPT-5.5. C’est une prouesse pour un modèle de petite taille face à des colosses.
6. Scepticisme et réalité : Entre percée historique et « Theranos de l’IA »
Le projet n’échappe pas à la controverse. Certains observateurs n’hésitent pas à parler de « Theranos de l’IA », rappelant les promesses non tenues de Magic.dev (100 millions de tokens annoncés sans adoption réelle) ou les limites de précision des modèles Mamba/RWKV.
Cependant, le sérieux financier est là : Subquadratic a levé 29 millions de dollars en seed sur une valorisation de 500 millions, soutenu par les investisseurs de la première heure d’OpenAI et d’Anthropic.
Le doute persiste néanmoins sur la fiabilité en conditions réelles. Un écart notable a été observé lors des vérifications par des tiers : sur le benchmark MRCR v2, le score est tombé de 83 % (interne) à 65,9 % (vérifié par Appen). Cette disparité souligne la difficulté de passer des benchmarks « propres » aux données d’entreprise désordonnées.
7. Conclusion : Vers une nouvelle architecture de l’intelligence
Si Subquadratic confirme son essai, nous assistons à la fin de l’ère du « chunking ». L’enjeu n’est pas seulement technique, il est structurel. Nous passons d’un paradigme où l’on cherche une information dans un document à un monde où l’IA possède l’intégralité du contexte instantanément.
L’architecture SSA supprime le goulot d’étranglement qui a forcé les ingénieurs à construire des usines à gaz logicielles depuis trois ans. Le « Artifact Reasoning » devient la norme, et le document n’est plus une base de données qu’on interroge, mais une unité de pensée cohérente.
Ma question aux décideurs techniques est simple : si votre IA peut demain ingérer et comprendre 12 millions de tokens en moins d’une seconde, quel argument restera-t-il pour justifier la maintenance de vos pipelines RAG et de vos coûteuses bases de données vectorielles ?